手把手带你用AI系列 第三弹:知识萃取——研究过的东西,怎么才算你的
【往期:第一弹《一起构建你的第一个学习研究智能助理》链接|第二弹《循环研究法》链接】
第二弹给了你循环研究法,课题能一圈圈往下钻,档案柜也立起来了。这一弹讲最后一道工序:档案柜里攒的东西,怎么炼成真正属于你的知识。
引子:你的AI比你更健忘
第二弹结尾我留了个尾巴:课题之间是断的。
当时没展开。这一弹开头,先讲两件我真实遇到的事。
第一件。
我开了一个新课题,跟AI说:帮我研究一下这个方向。
它撸起袖子就干:联网搜索、翻材料、整理信息,从零起步,忙得热火朝天。
我在旁边看着,总觉得哪里不对。想起来了,这个方向我们之前研究过。不光研究过,结论就躺在另一个课题的档案里,写得清清楚楚。
我说:停,等等,这个方向咱们之前研究过吧?去翻那个课题的档案,用里面的东西。
它去翻了,还真翻到了,直接复用。研究起点一下往前挪了一大截。
看着配合挺好?但你把这事倒过来看一眼:这回能复用,靠的是我还记得。
记得研究过,记得大概是哪个方向,记得让它去翻。我成了它的人肉索引。那我忘了呢?它就把旧路重走一遍,而且永远不会知道自己干了重复的活。
第二件更隐蔽。
AI配合我研究出一个结论。逻辑顺,材料扎实,我差点就收了。
但心里总有个疙瘩。说不上来,就是隐隐觉得这个结论跟之前哪个课题里的东西有点关系。
我说:你回去翻翻,之前某个课题里似乎有类似的研究,对比一下。
它真去翻了。一对比:矛盾。这个新结论跟几个月前另一个课题的结论打架,两个不能同时成立,要么有一个错了,要么适用条件不同。
好悬。这条要是收了,往后的研究就盖在自相矛盾的地基上。
两次,都是我的记忆救的场。
头一回是我确切记得;第二回是我模糊觉得"哪里没对"。但你琢磨过没有,这事反常。
它有存储啊。档案都在,翻得出来,一个字没丢。它缺的不是记忆,是想起来。该想起的时候想不起来,跨课题也不主动调用,除非你提一嘴。你做的每个课题在它那都是孤岛,岛跟岛之间没桥。
而真正的麻烦在你这边:你在拿自己的脑子,当整个知识体系的索引。
课题少,这么干没问题。课题一多,你会忘掉自己有过的洞见,会把研究过的东西再研究一遍,会拿着两条矛盾的结论各走一段,然后莫名其妙撞墙。
AI健忘能治。你健忘,治不了,只能换方案:把"人肉索引"换成一个真正的知识库。
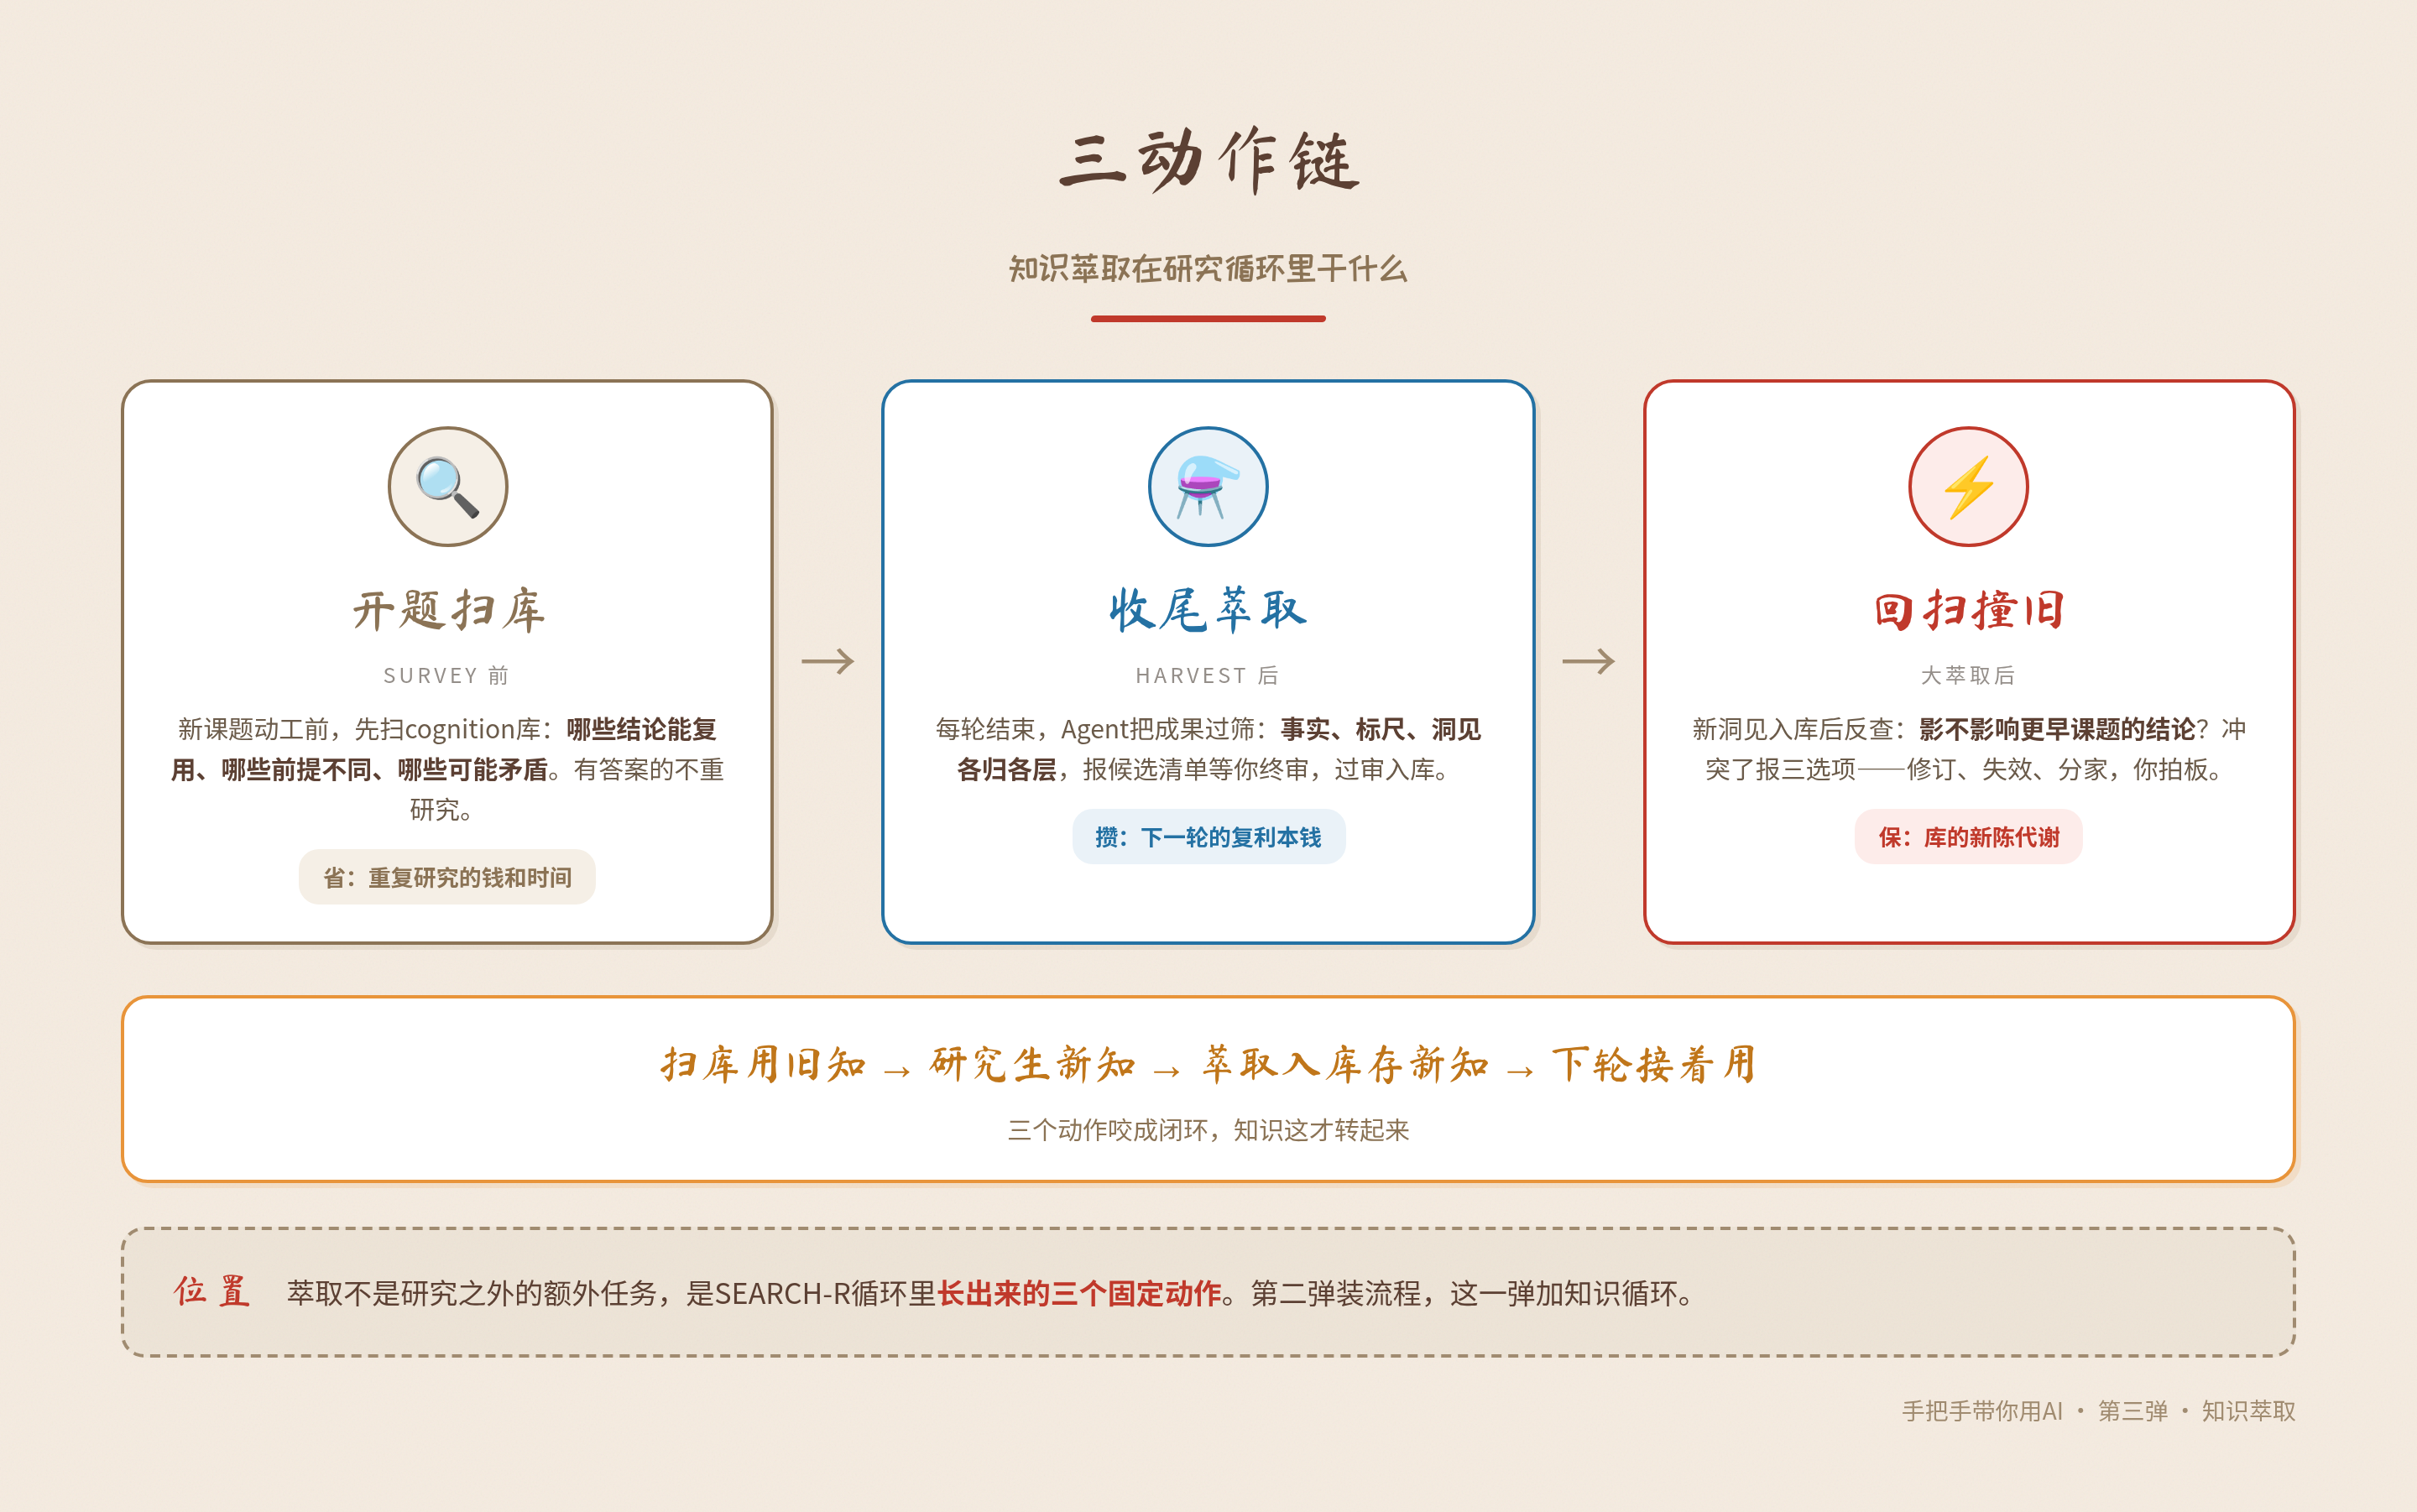
这就是第三弹要解决的。知识的完整链路,我后来提炼成三个动作:找出来,存下来,用起来。
找出来——研究过的东西,怎么萃取成能调用的知识;
存下来——炼出来的知识,怎么存才存得住、存得久;
用起来——建好的知识,怎么在课题之间自动流动,让AI在该想起的时候想起。
方法论:研究过,不等于拥有
动手之前,先把几个问题想透。这些答案决定了后面每一步操作为什么长那样。
研究产出的是材料,不是知识
第二弹的Harvest,存了四样东西:阶段结论、原始资料、分析过程、下一步问题。这些是过程的忠实记录。
过程记录有价值,上一弹说过,没有过程记录的结论是死结论。但它有个天生的毛病:它是给"这一轮"写的,不是给"下一轮"写的。
下一轮、下一个课题要用的时候,要的是压缩过的认知:一句话说清、带出处、拿来就用。而不是翻回几十页的讨论记录里重新考古。
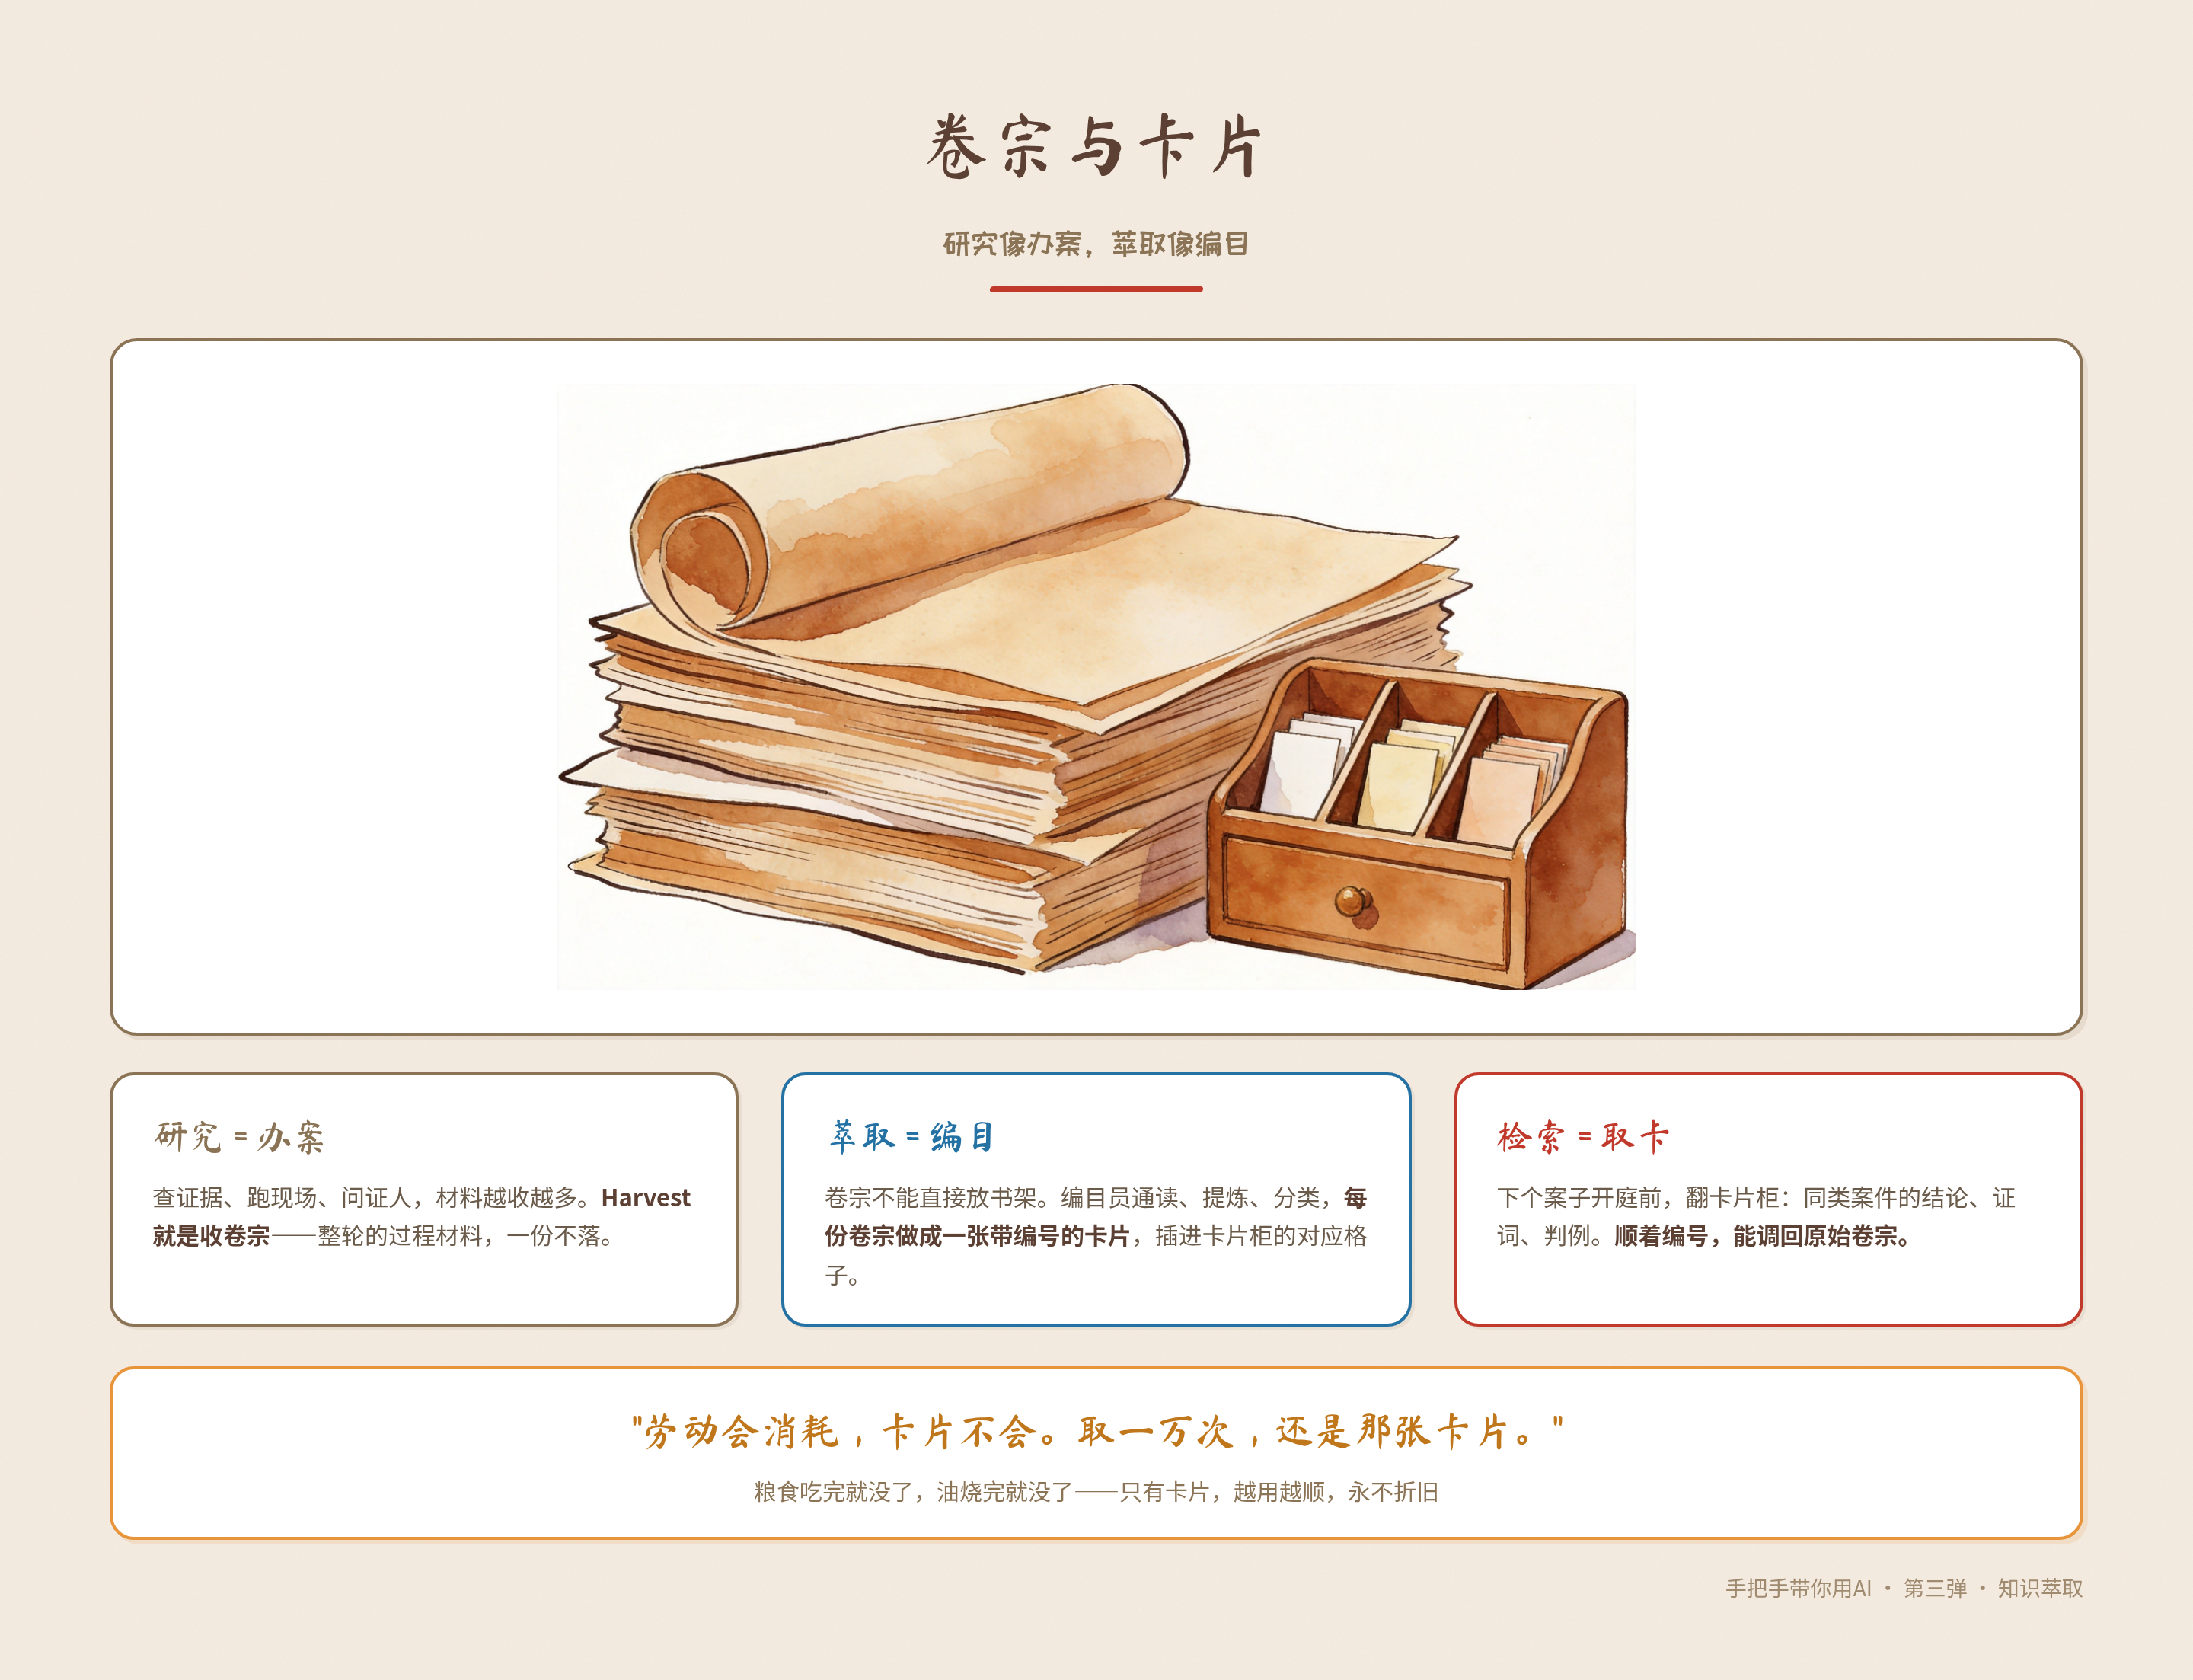
打个比方。研究像办案,Harvest收回来的是一摞卷宗:调研报告、讨论记录、分析草稿,几百页。卷宗有价值,但它是一案一卷的。下个课题要用的时候,你没法把几百页卷宗整个搬过去,只能从头翻。
萃取就是给这摞卷宗编目:把里面最关键的那几条,做成一张张带编号的卡片,放进卡片柜。往后任何课题,报编号就取卡,取了就用。它不是把文件再整理一遍,是从过程材料里,把认知的精华部分分离出来。
没有萃取,就没有复利
再往深一层。
你为什么做研究?为了下次碰到类似的问题不用从头来。研究的价值,一半在眼下这个结论,另一半在"以后还能再用"。
前一半,研究完就兑现了。后一半,取决于你有没有萃取。
想象两个人,都用循环研究法跑了半年,各做了二十个课题。
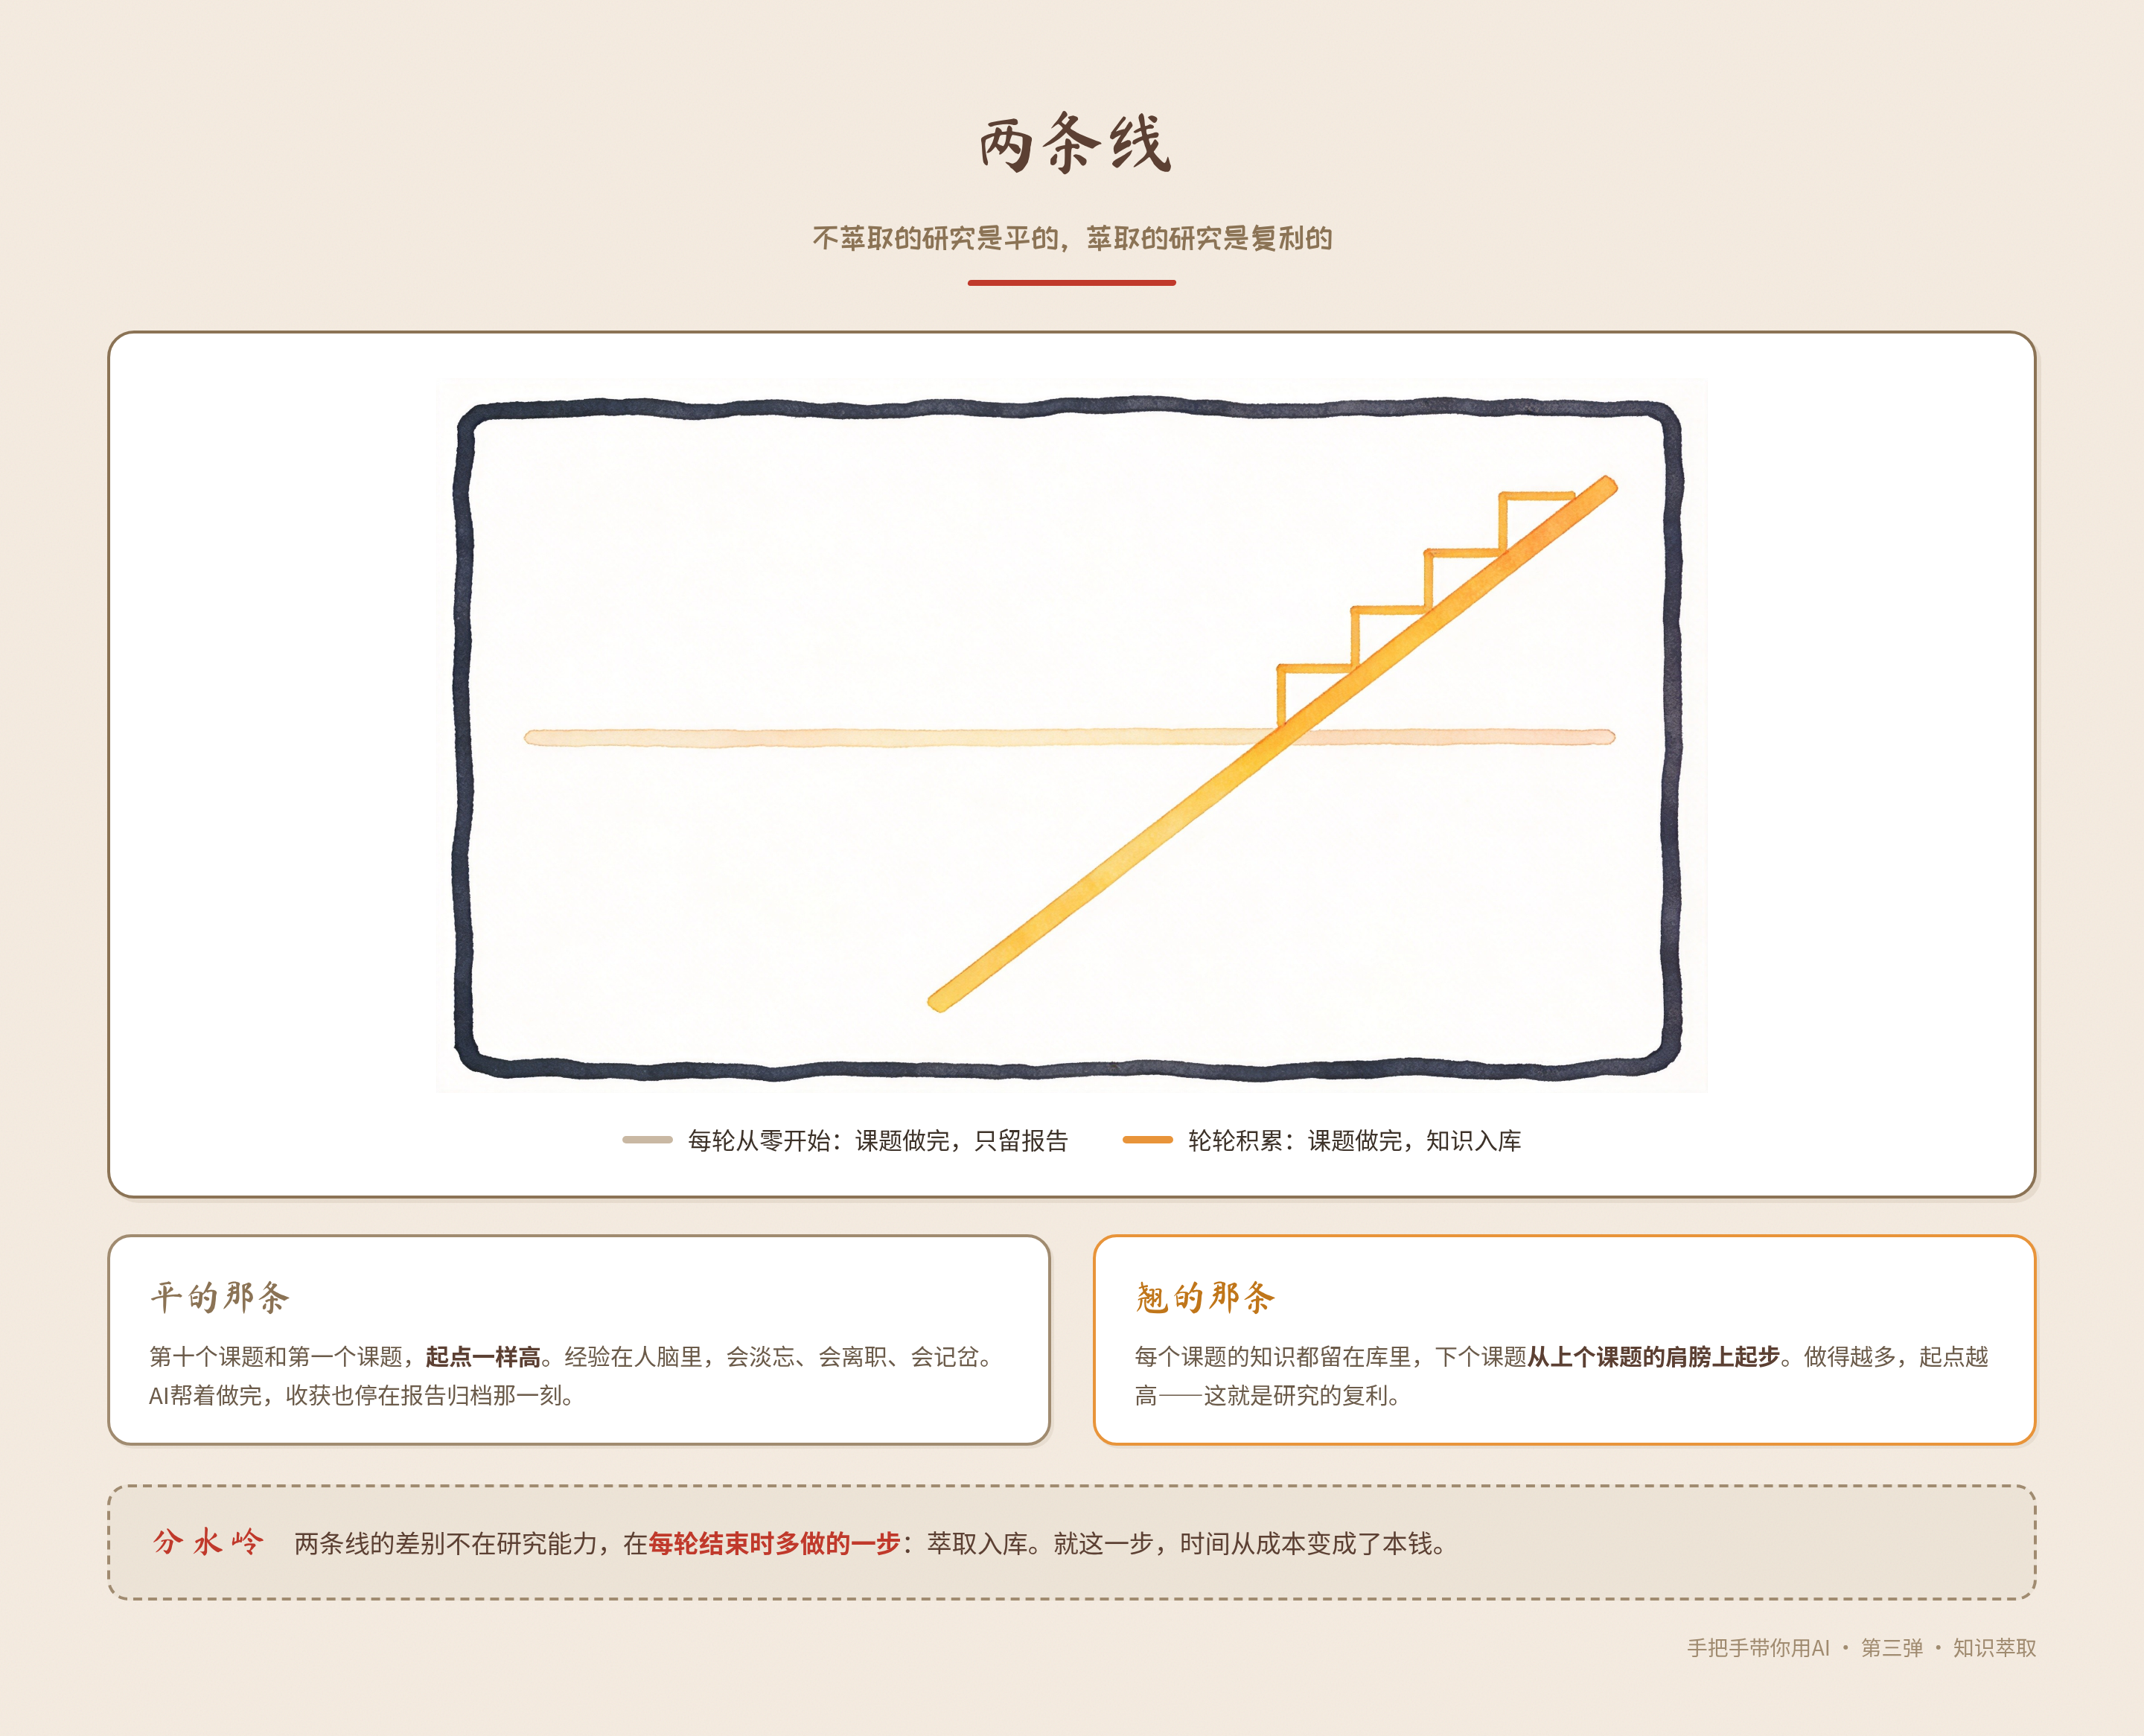
第一个人,档案做得整整齐齐,但没萃取。做到第二十一个课题,能带上的只有脑子里的印象。他的研究能力是一条水平线,每个课题都做得不错,课题之间不叠加。做了五十个课题的人和做了五个课题的人,起点差不多。
第二个人,每个课题结束都萃取。做到第二十一个课题,他站在前二十个炼出的洞见上往下钻。课题越多,起点越高,研究能力是一条斜率向上的线。
差别不在勤奋,在复利。 萃取就是把研究从"线性劳动"变成"复利资产"的那道工序。卷宗会越堆越高,卡片柜越用越顺手:第一条卡片做出花十分钟,往后每个课题都在白捡。这就是复利,劳动会消耗,卡片不消耗,取一万次还是那张卡片。
而且这差距会越拉越大。到第三十个课题,两人差的已经不是熟不熟练,是站在多高的地基上。
知识的判据:能不能改变行动
编目要有标准。什么算知识、什么不算?
我的标准只有一条:能不能改变你的行动逻辑。
能改变行动的,是知识。不能改变的,存得再多也只是材料。
注意这判据有多严。"说得对"不算,正确的废话满地都是;"信息量大"不算,一堆数字不告诉你怎么做;"很深刻"也不算,听着有道理落不了地,等于没有。
拿这个判据照一照常见的"学习行为",很多当场露馅。
收藏三百篇文章,是Fact囤积;划两千条重点,是Fact囤积;问AI一百个问题、存一百段回答,还是Fact囤积。囤积的特征就一条:藏品在涨,做法没变。
知识正相反:数量可能不多,但每一条都对应一句"从今往后我换个做法"。
判据是行动,而行动是你的行动。 这就引出了分工问题。
分工:AI初筛,你终审
"改变行动逻辑"——判断一条东西能不能改变行动,谁说了算?
AI干初筛:按标准把候选挑出来,理由写清楚。但"这个行动改不改"它说了不算,它不知道你的场景、你的取舍、你眼下卡在哪。行动的语境在你手里。
这跟第二弹的Review一个原则:出力可以外包,判断不能外包。Review把研究关,萃取终审把知识关,一脉相承。
为什么必须分层
编目还有一个前置动作:按成色分。
研究材料里的东西成色不一样:有客观事实,有量化数据,有行动洞见。三种东西的命和用法完全不同,事实要准,数据会过期,洞见要指挥行动。
混在一起存会怎样?三个月后就是一锅粥。
想复核"哪些数据可能过期了",没法查,数据跟事实混着;想调出"能指导决策的那部分",没法调,洞见埋在信息里;想判断一条结论还作不作数,看不出,它依赖的数据坏没坏,一眼望不穿。
分了层,这些操作才做得起来:复核只碰Metric层,调用先看Insight层,判断可信度顺着来源链查。分层不是按主题分,是按"性质和用法"分。 这就是下一节的三层模型。
问题想清楚,操作就水到渠成。
解决方案:三层模型,一个最小体系
方法论落地,就两样东西:一个三层分类标准,一套最小文件体系。
三层:事实、标尺、洞见
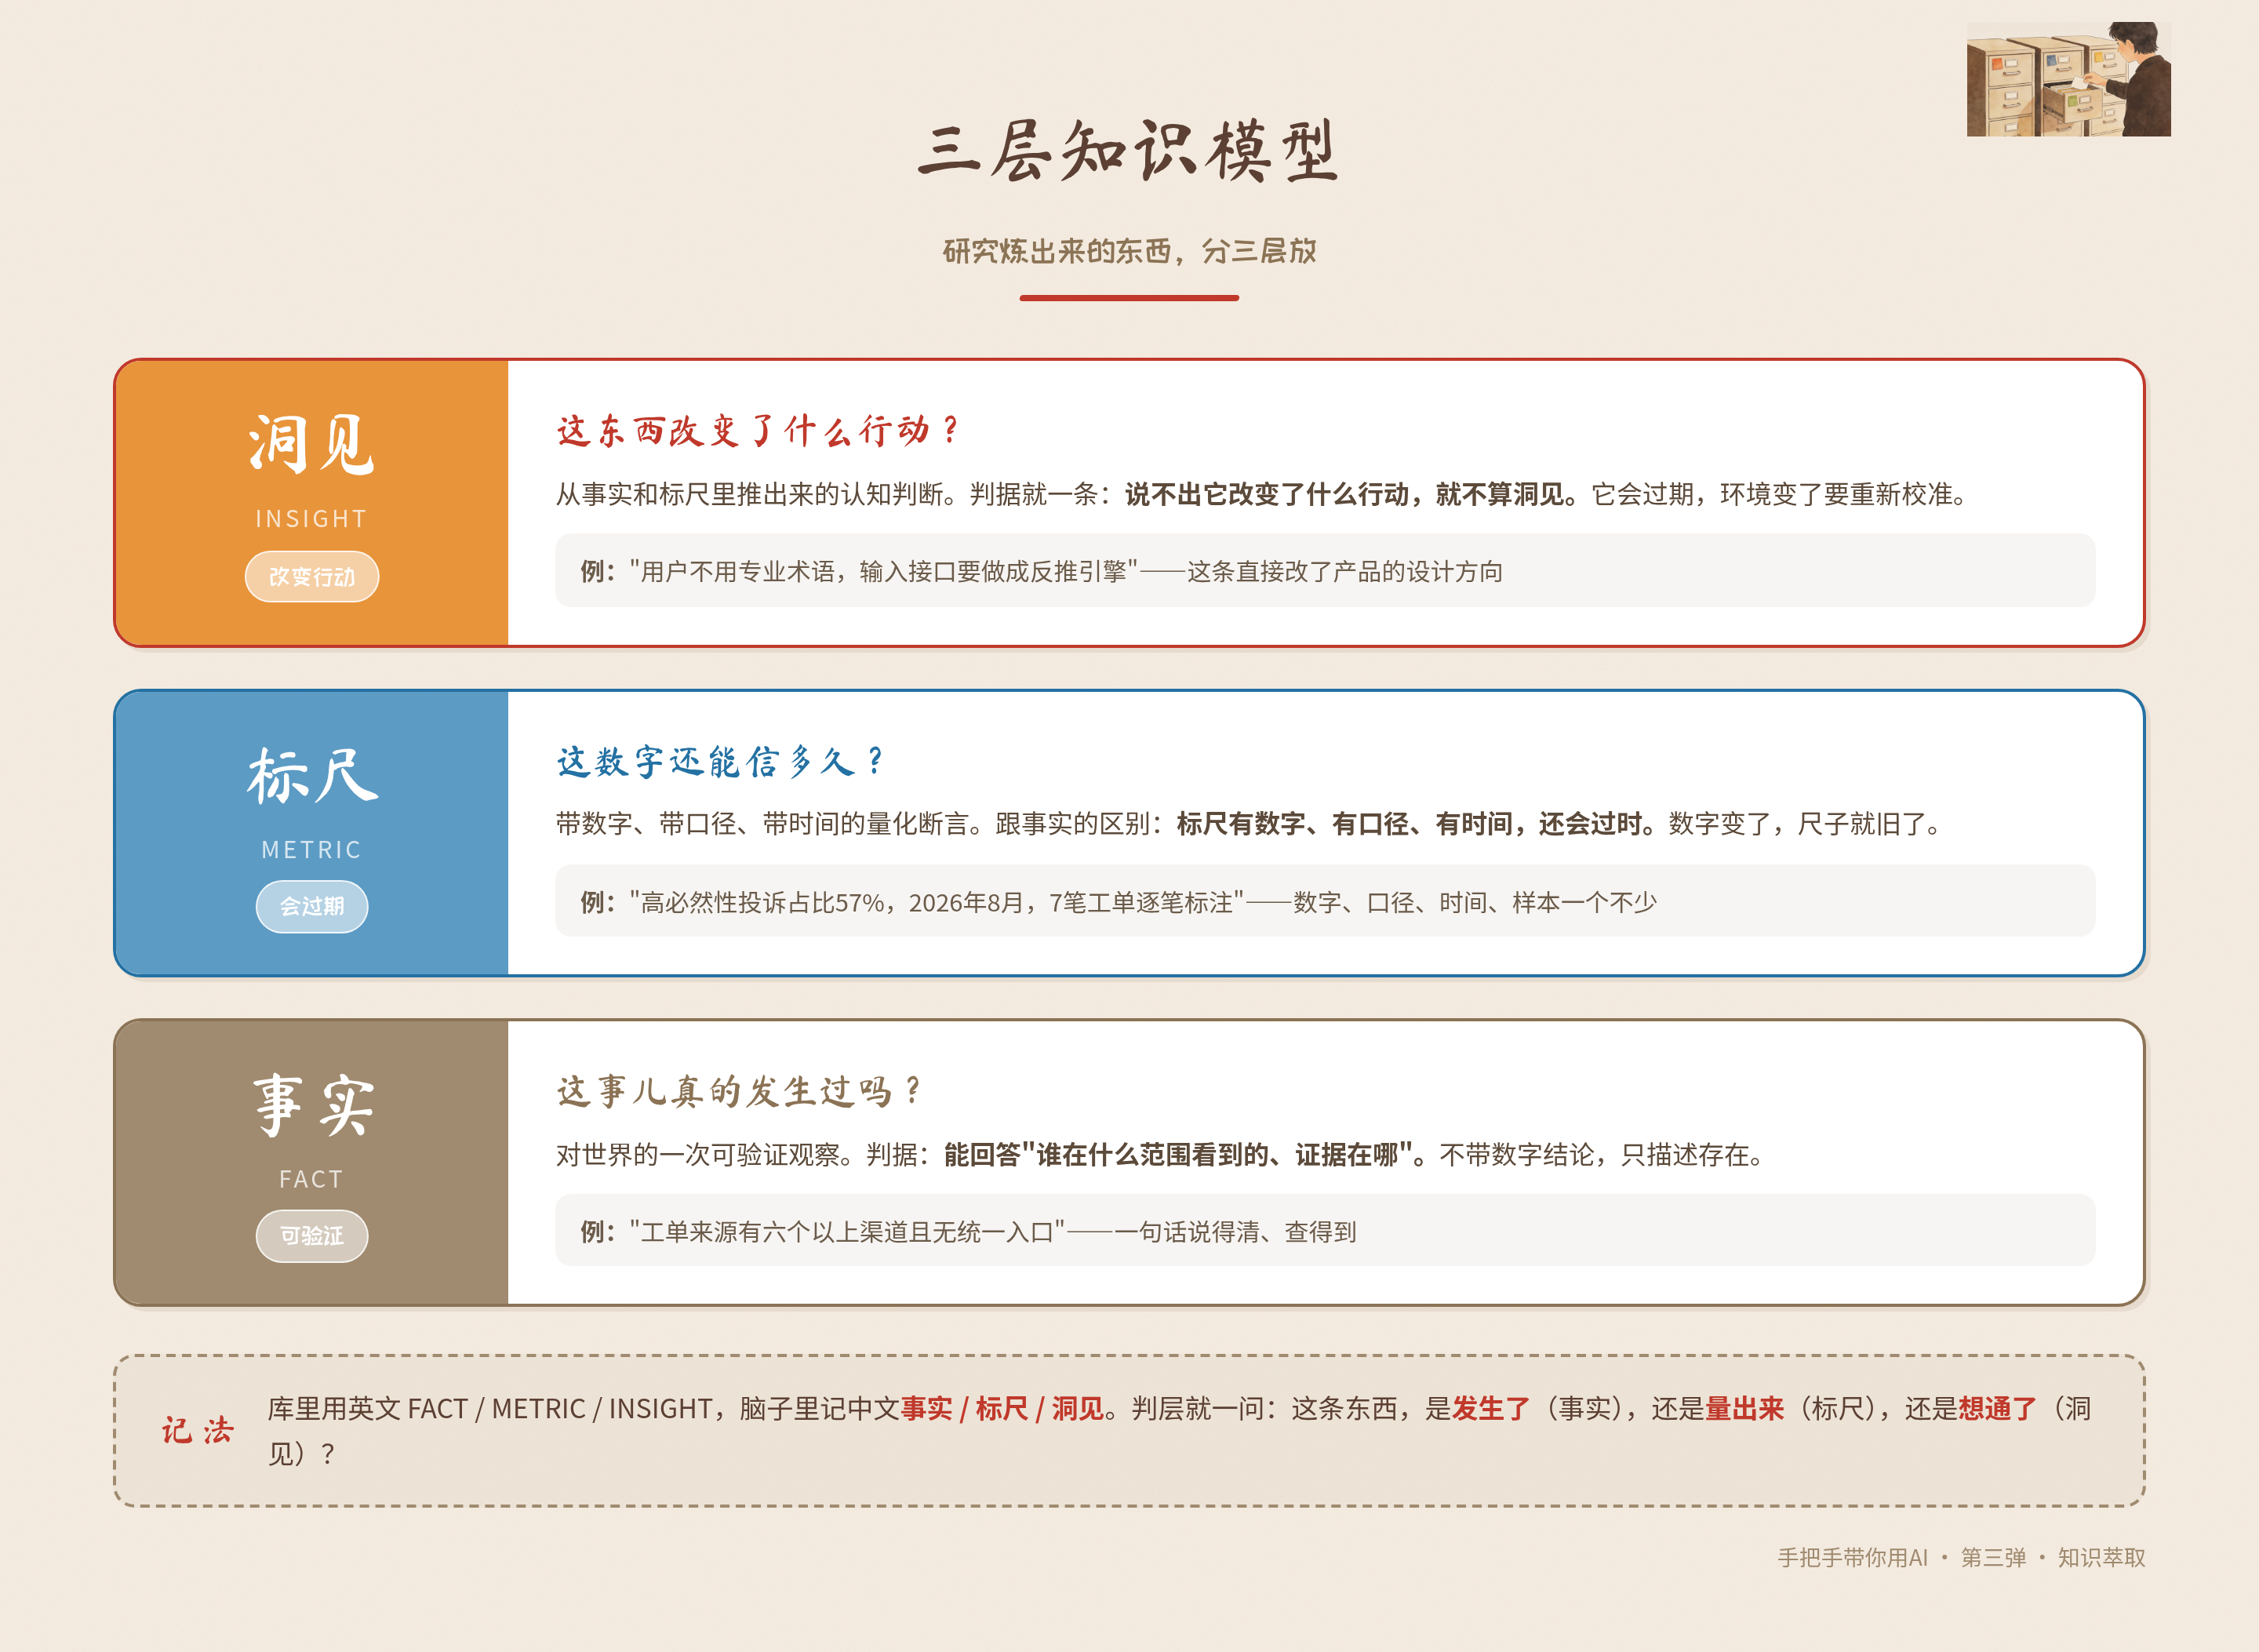
三层各有一个英文名和一个中文名:Fact是事实,Metric是标尺,Insight是洞见。库里和Agent指令里用英文,脑子里记中文名就行。
Fact,事实。 对世界的事实性描述,客观存在,不随你的研究改变。回答"是什么",不回答"意味着什么"。
拿我自己一个真实课题举例,AI供电服务员研究。这个课题调研了供电服务的投诉处理体系,萃取时有这么几条东西:
"供电服务采用三级组织架构:市供服中心→供服分中心→供电所。"——Fact。对组织事实的客观描述,谁来看都一样。
"工单来源包括客服热线、政务热线、本地电话、微信群、营业厅等六个以上渠道,没有统一入口。"——Fact。一件真实存在、可验证的事。
Fact的价值在准和可验证。它像地基,你不能住在地基上,可没地基盖不了楼。
但攒了一堆Fact不等于有知识。就像攒了一仓库砖头不等于有了个家。
很多人做笔记,说到底就是在收集Fact。好文章摘几段,讲座记几个要点,问AI存下回答,全是Fact。Fact本身没错,可你库里只有Fact,它就是个高级收藏夹,永远不告诉你"所以呢"。
Metric,标尺。 有独立引用价值的量化发现。跟Fact的区别:标尺有数字、有口径、有时间,还会过时。
还是那个课题,再举两条:
"7笔投诉工单逐笔分析,4笔(57%)属于高必然性投诉——只要条件满足、必然发生的那类。"——Metric。有数字、有口径(逐笔标注)、标注了"样本量偏小但指向性强"。
"一个客户3个月内低电压53次才形成投诉。"——Metric。极端个案,口径里明确标注"说明投诉只是冰山一角"。
Metric比Fact值钱,值钱在它给你判断的标尺。 你跟人说"投诉有不少其实怪电网自己",这是观点;说"57%有系统性根因",这是论据。差的那个东西就是Metric。
Metric有个特点:它会变。 样本会扩大,口径会调整,时间一长还可能过期。所以每条Metric都标时间和来源,方便你判断它还能不能用。
Insight,洞见。 改变行动逻辑的认知。整个体系的核心层,唯一判据还是方法论那条:能不能改变你接下来怎么做。
真实例子,同一次萃取里出了这么一条:
"用户表述与技术故障之间存在系统性语义鸿沟——AI必须从生活体验反推技术原因。"
用户从来不使用"低电压""电压偏差"这些专业术语。他们说"空调不制冷""灯泡忽明忽暗""火锅煮不熟",甚至方言"电灯南瓜花"。从这些表述到技术原因,中间隔着好几步推理。
凭什么这条算Insight?它不是Metric,重点不在任何数字;也不是通识,"要理解用户"这种话谁都会说。它改了行动逻辑:AI系统的输入接口,不能设计成"用户报什么关键词、我匹配什么故障"的关键词匹配器,必须设计成"生活体验→技术原因"的反推引擎,还要给可能性排序。整个接口设计的思路被这条洞见改写了。它还能迁移:医疗(患者说"肚子疼",倒推鉴别诊断)、IT运维(用户说"网慢",倒推根因分析),同一套结构。
再送一条同课题的,感受下Insight长什么样:
"投诉触发是三重阈值链——仅盯单次严重性,会漏掉一半风险。" 客户从"感知到异常"到"累积不满"到"情绪引爆"是三个阈值。以前只盯单次事件的严重程度,现在行动改了:把"一段时间内的异常累积频次"纳入监测。客户敏感度识别,从看单次事件变成看累积曲线。
三层的用法:事实是地基,标尺是望远镜,洞见是地图。 标尺让你看清远处发生了什么,地图告诉你往哪走。
顺便说一句,这套三层体系自己也产出过一条关于自己的Insight,来自知识管理课题:"认知不应用等于死库存。"行动含义:知识管理的核心指标不是存了多少,是被调用多少。一条洞见三个月没被任何课题引用,先别得意,先怀疑它是不是死库存。你现在读的这篇,上面每条知识都引了,按这条Insight的标准,它们今天都活着。
三层和DIKW金字塔是什么关系
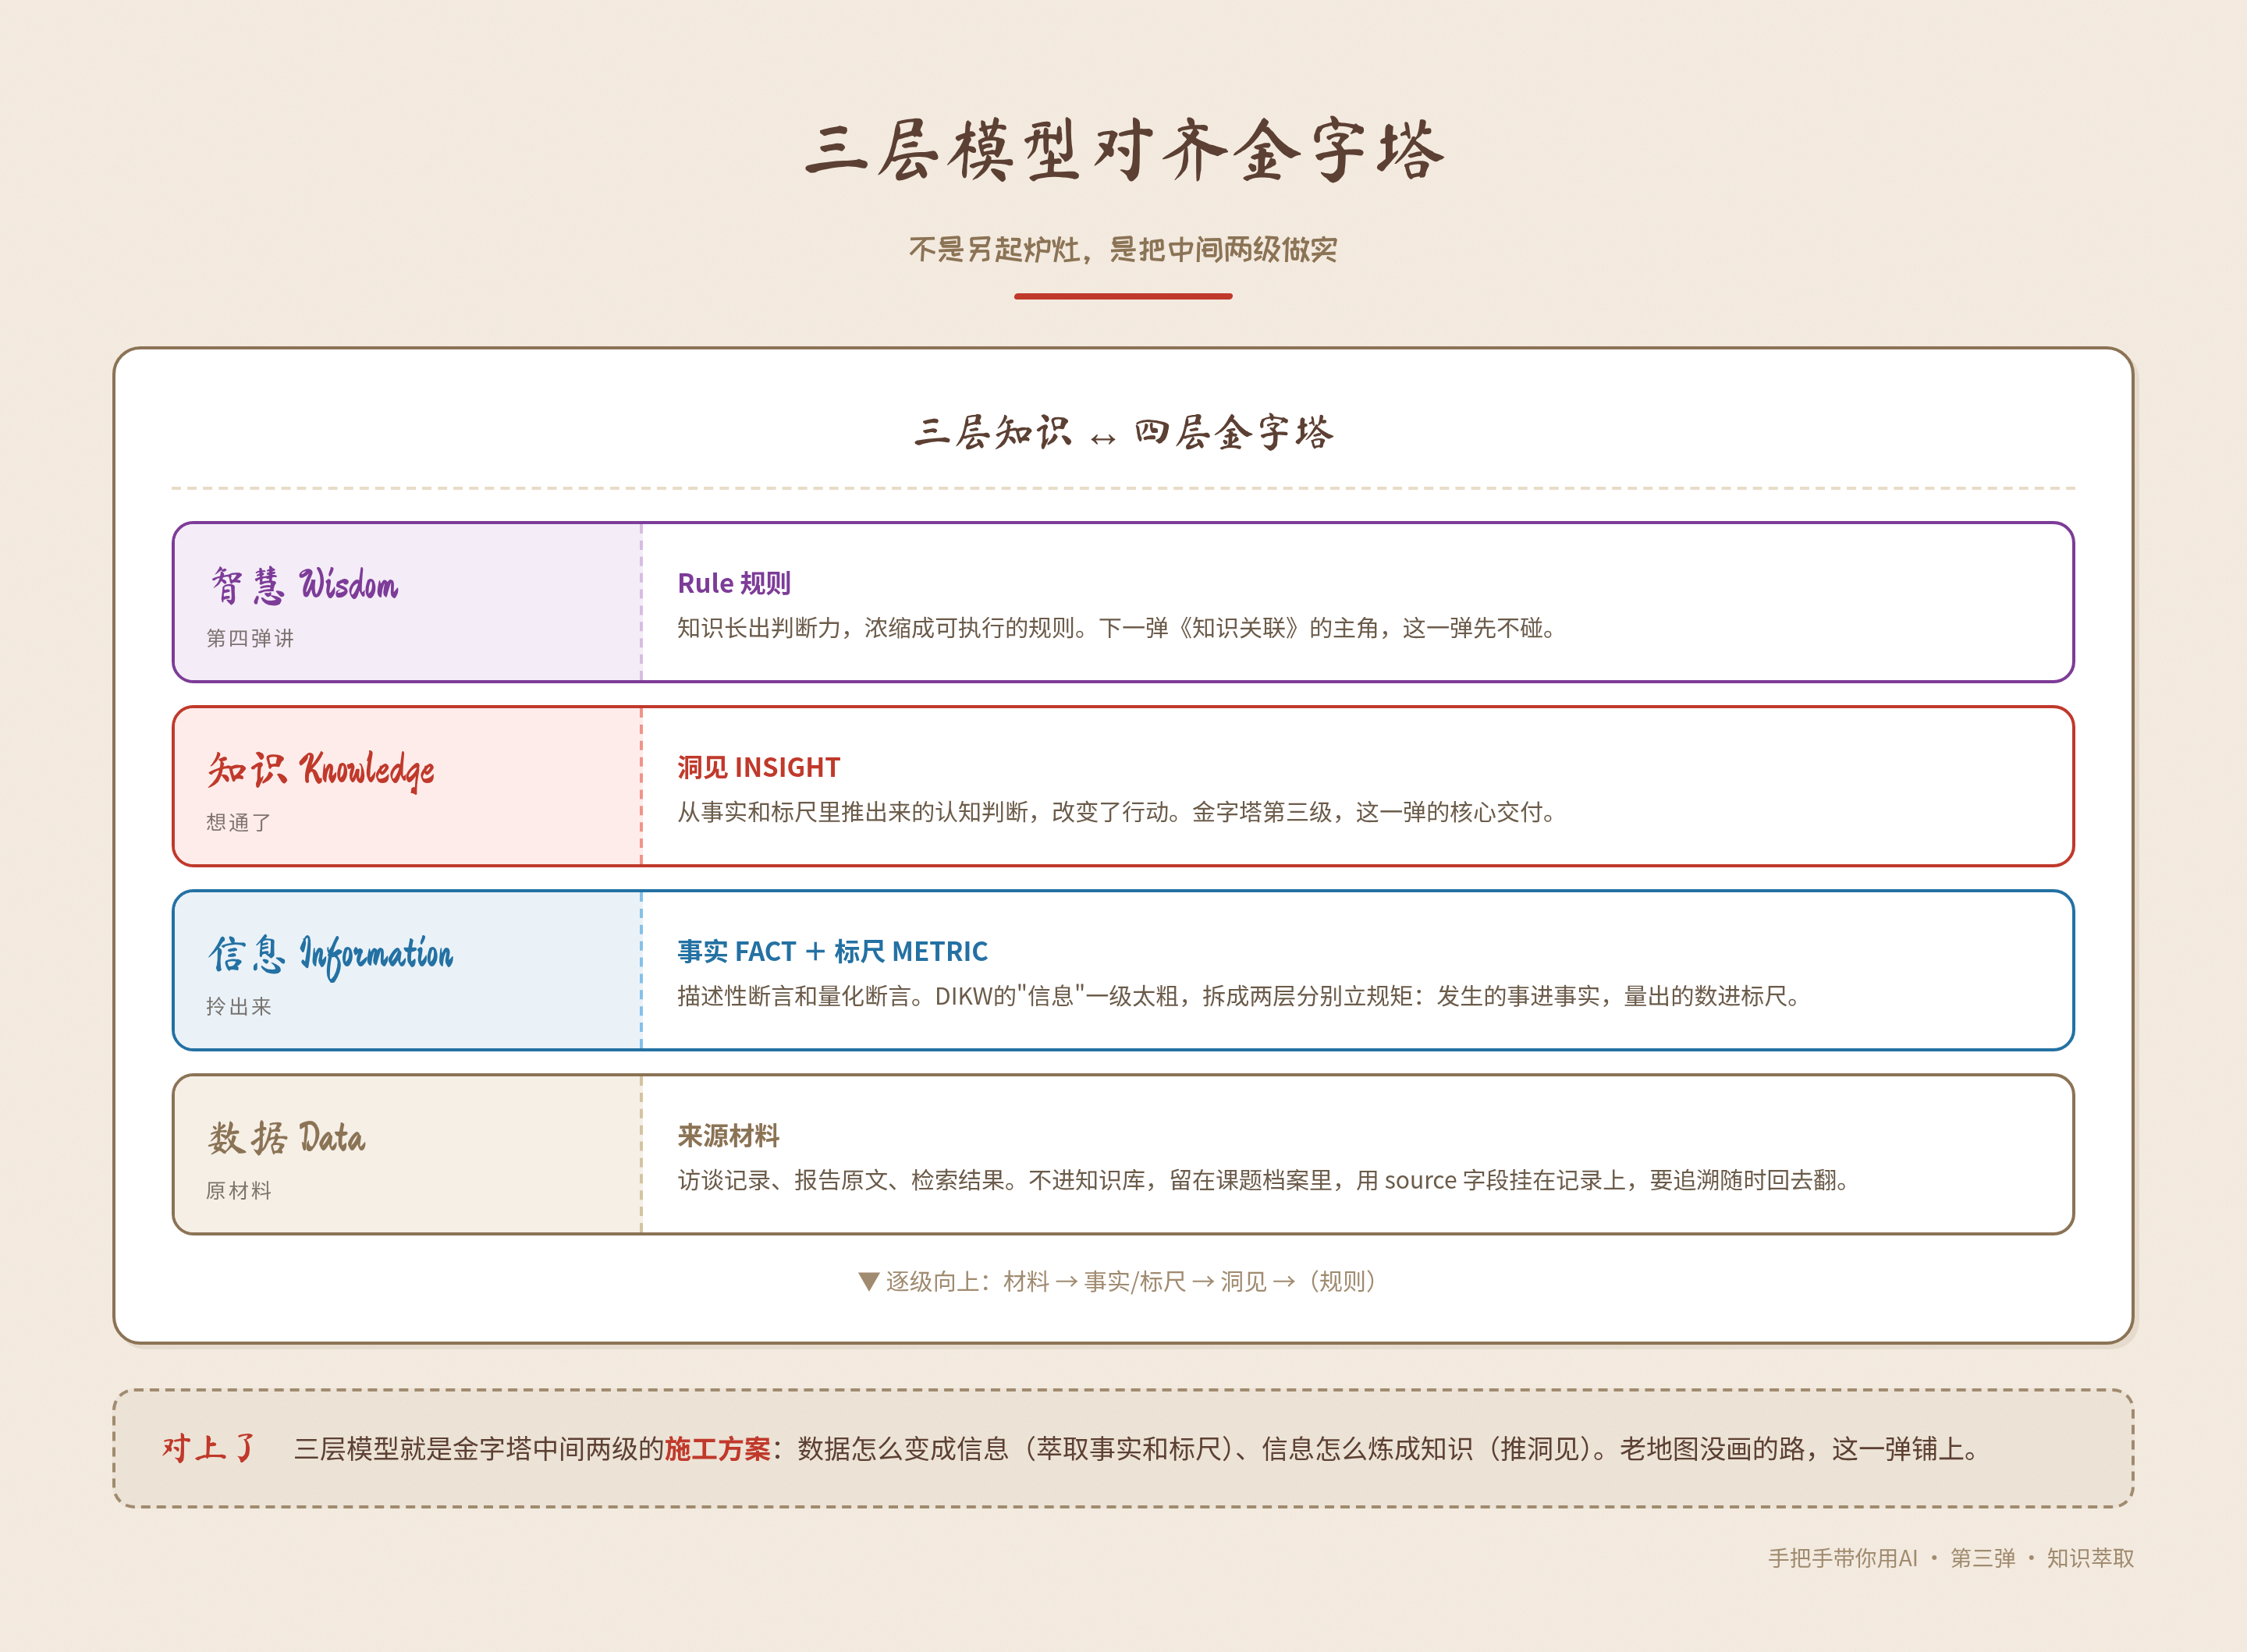
知识管理领域有个经典金字塔:DIKW,Data(数据)→Information(信息)→Knowledge(知识)→Wisdom(智慧)。不少人拿它当知识管理的地图,但它有个致命问题:每一层它自己都没讲怎么落地。 原始内容怎么变成信息?信息怎么变成知识?金字塔只告诉你有这几层,不告诉你怎么从一层爬到上一层。
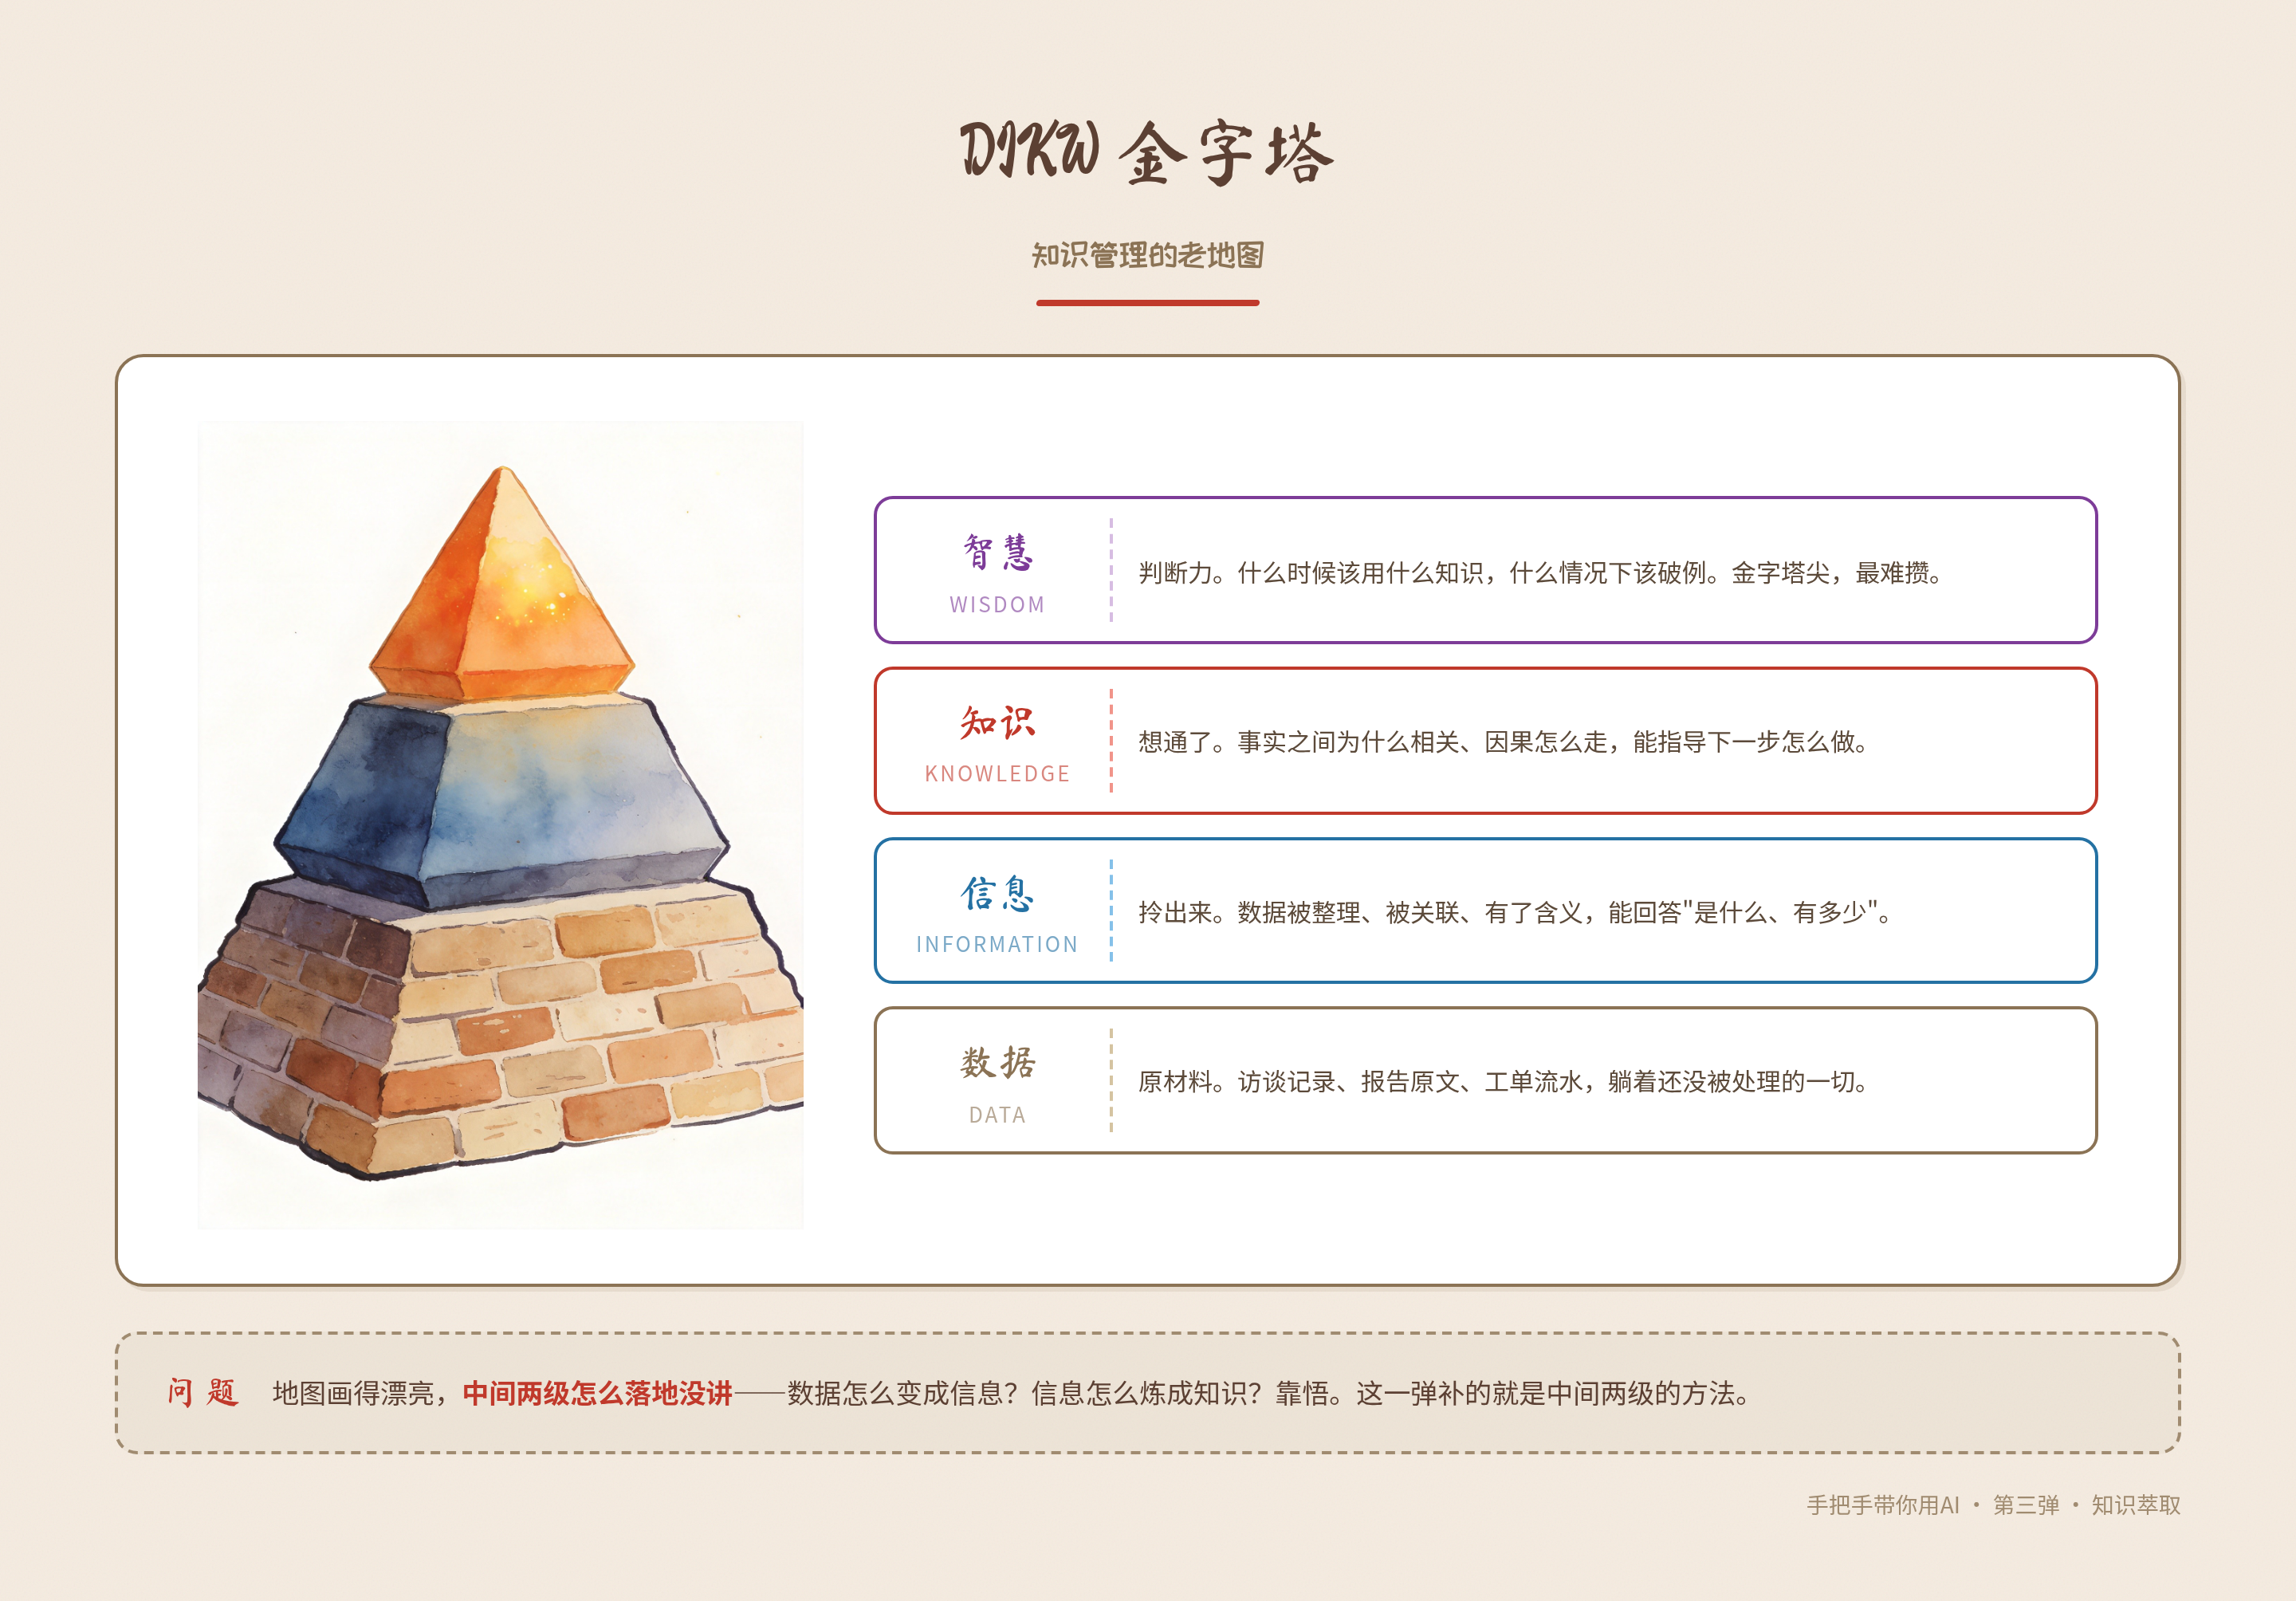
把这套三层放上去,正好补齐中间两级,也顺便看清各层的位置:
- DIKW的Data,处理前的原始内容——对应这套体系的来源材料:调研报告、讨论记录、没加工过的东西
- DIKW的Information,加工后的事实——对应Fact/Metric:从材料里炼出的事实和标尺
- DIKW的Knowledge,改变行动的认知——对应Insight
- DIKW的Wisdom,最终指导行为的智慧——对应Rule:把验证过的洞见固化成规则,让它接管后续行动
来源材料 → Fact / Metric → Insight → Rule
所以这一弹补的正是中间两级的方法:怎么从原始材料里炼出Fact和Metric,怎么让Insight从里面长出来。至于塔尖那层Rule,洞见怎么升级成规则、规则怎么接管行为,后面一弹专门讲。
"所以呢"测试
Insight的判定,实操上用一个简单测试:"所以呢"测试。
有人跟你说一条东西,你就问:所以呢?
"投诉触发是三重阈值链"。所以呢?"所以监测不能只盯单次严重性,把累积频次也纳入。"对,行动变了。
"57%的投诉有系统性根因"。所以呢?"所以……投诉分析要往根因走?"勉强。数字本身不构成行动,它是个有力的Metric,等着跟别的东西碰出Insight。
再看两条最容易混进来的:
"智能客服的情绪识别准确率达到了92%"。Metric。技术指标,不指向你的行动。
"AI时代要重视用户体验"。通识。永远不错,也永远没用。
从Fact、Metric到Insight,中间隔着一层"所以呢"。 穿过这层"所以呢",才从"知道了"变成"会做了"。
最小体系:一个文件夹,三个文件
分类标准有了,往哪存?
不需要Notion,不需要Obsidian,不需要任何知识管理软件。一个文件夹,三个JSONL文件。 JSONL,一行一条JSON记录的纯文本文件,Agent的原生格式。
第二弹的课题档案还记得吧。档案柜继续放过程材料,不动。现在,在所有课题的旁边,研究根目录下另立一个目录:
研究根目录/
├─ 课题A/
│ ├─ topic.md(课题档案,第二弹已有)
│ ├─ observations/(观察笔记)
│ ├─ retrievals/(检索报告)
│ ├─ theory/(理论文档)
│ ├─ harvest/(确认成果)
│ └─ reflections/(反思笔记)
├─ 课题B/(同构)
└─ cognition/(新增:全部课题炼出来的知识)
├─ facts.jsonl
├─ metrics.jsonl
└─ insights.jsonl
cognition,认知。注意这个目录的站位:不在任何课题里,在所有课题旁边。 它放的不是过程材料,是从所有课题里炼出来的东西,全量汇聚,全局唯一。
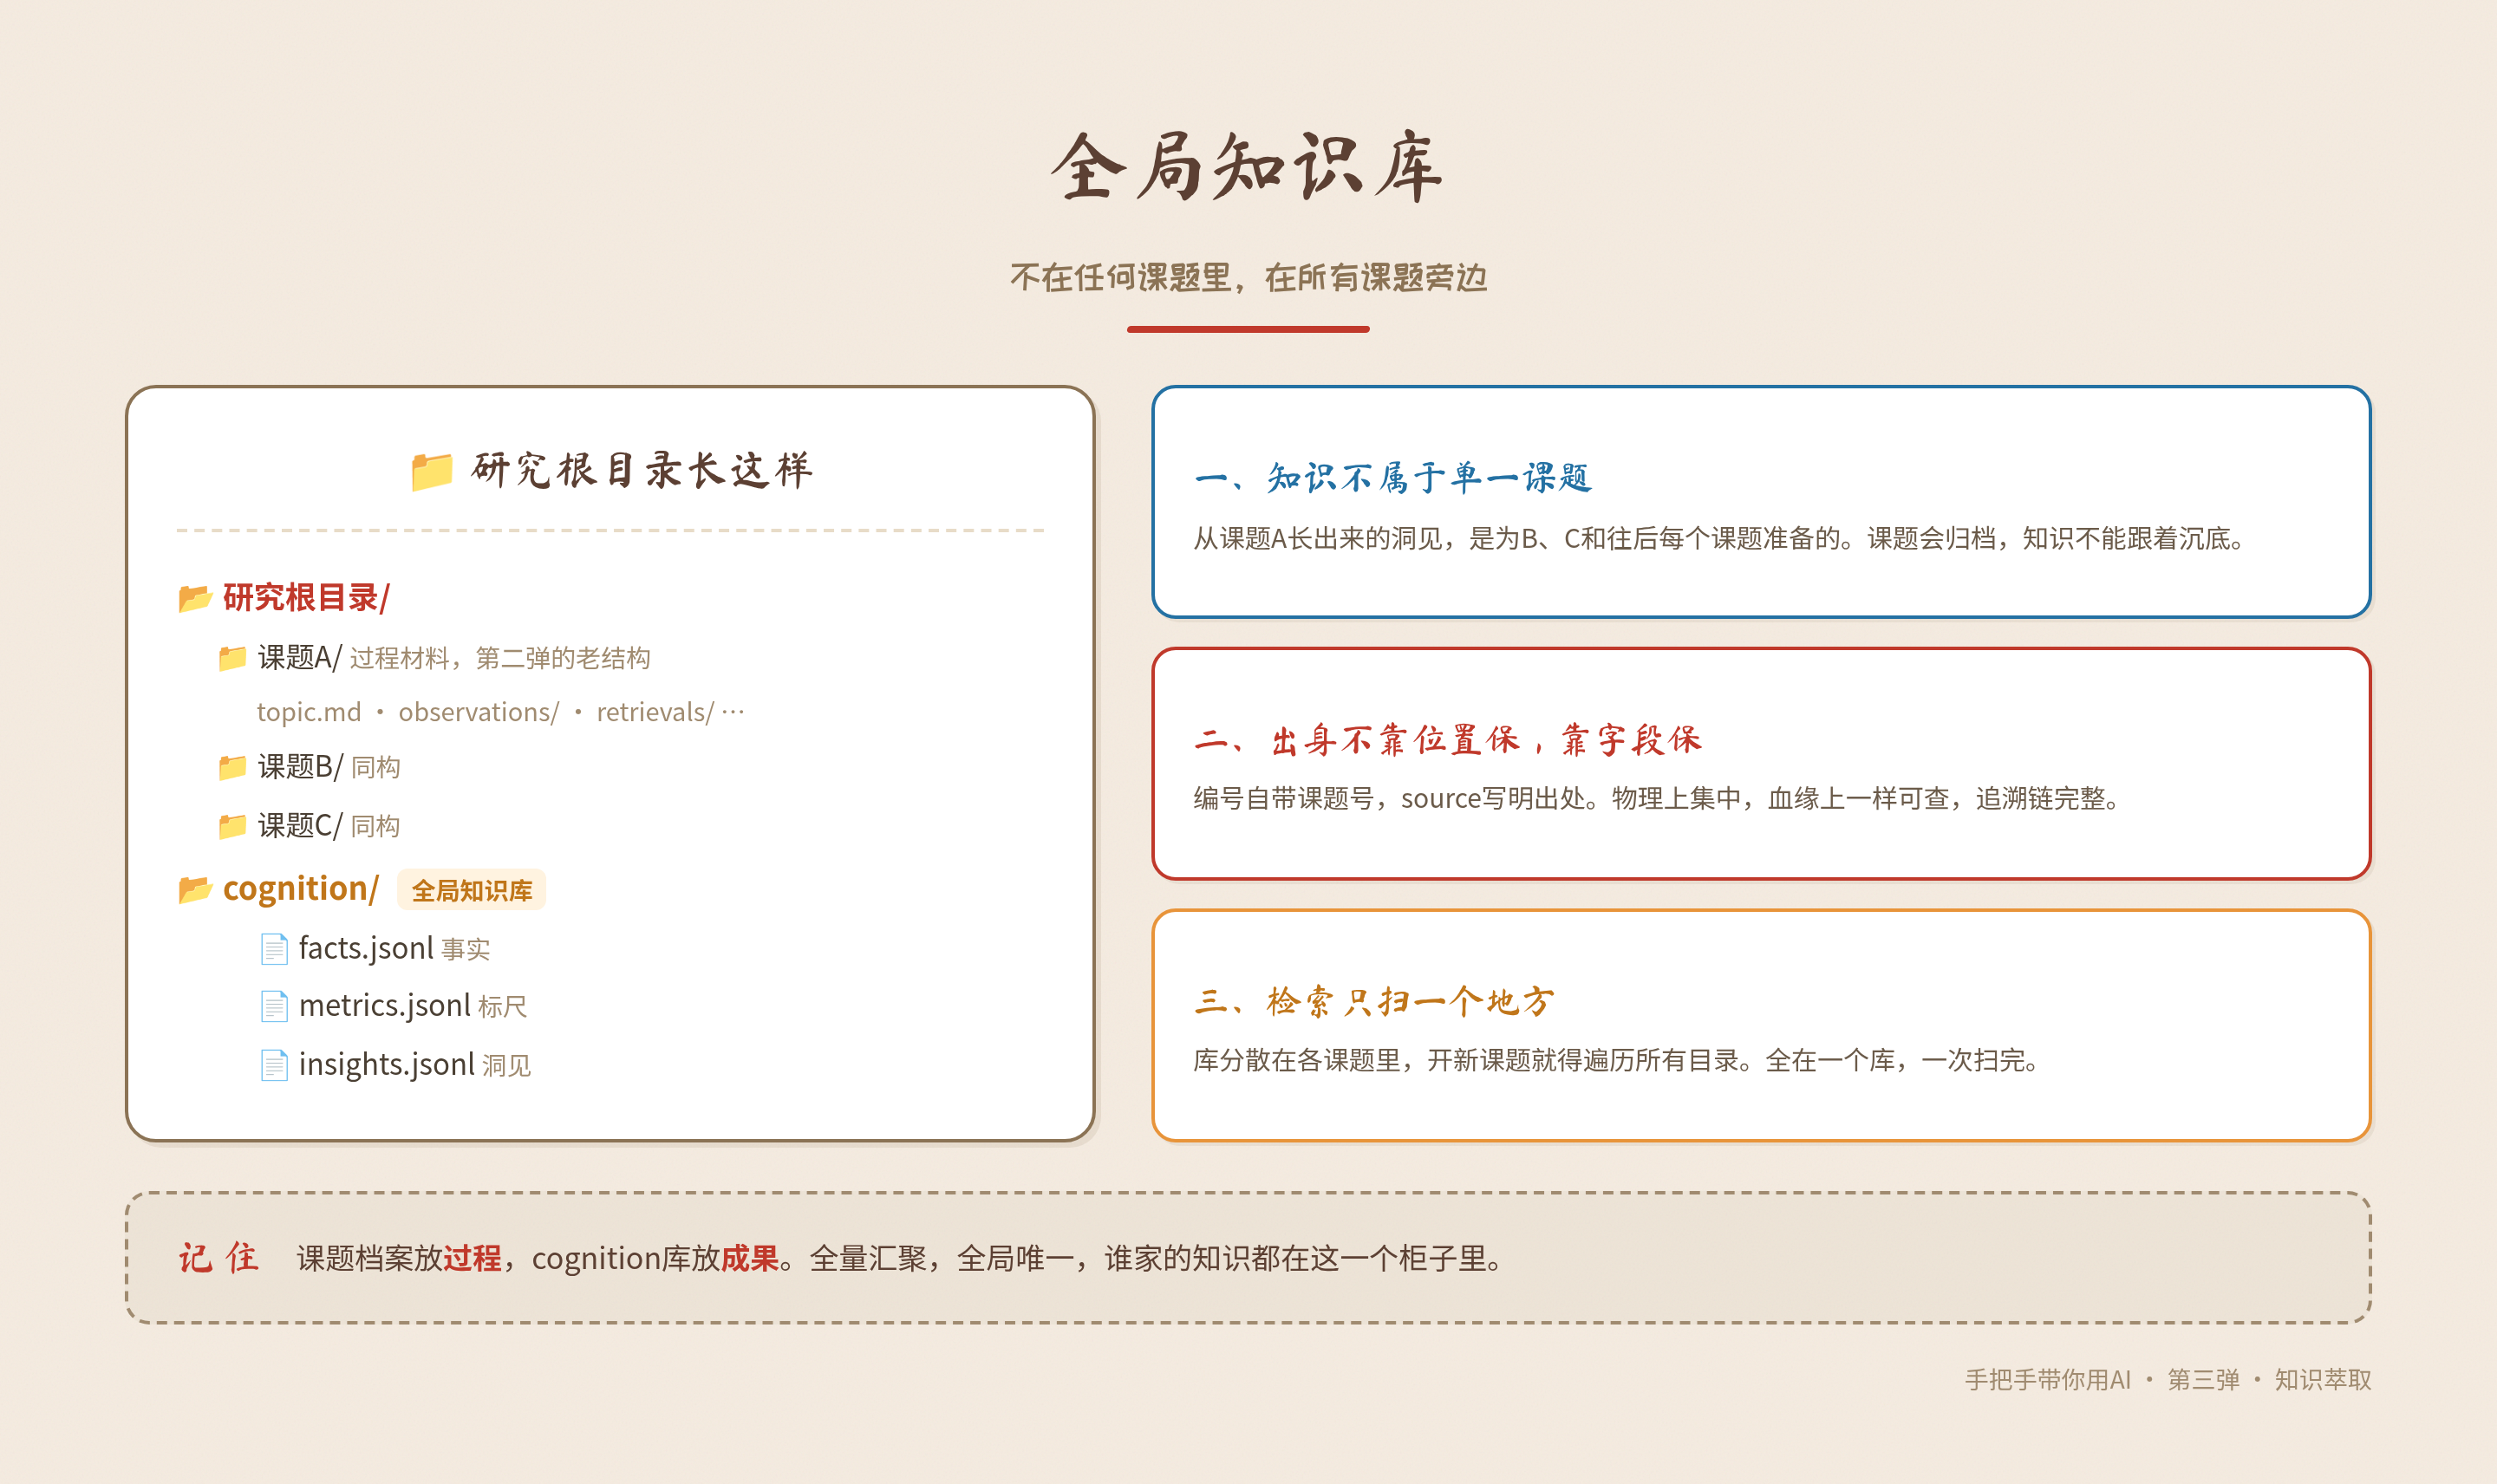
为什么不放进课题里?三个原因。一是知识炼出来那一刻,就不属于任何单一课题了。 它从课题A里长出来,却是为课题B、C、往后每一个课题准备的。课题会结束、会归档,知识不能跟着一起沉底。二是出身不靠位置保,靠字段保。 编号自带课题号,source字段写明出处,物理上集中,血缘上一样可查,追溯链完整。三是检索只扫一个地方。 库分散在各课题里,每开新课题就得遍历所有课题目录,课题一多,扫描本身就成负担;全在一个库,一次扫完。
每条知识的格式极简。拿语义鸿沟那条举例,一条记录长这样(实际入库时压成一行,展开只是为了让你看清字段):
{ "id": "INS-A03",
"title": "用户表述与技术故障之间存在系统性语义鸿沟",
"content": "用户不用专业术语,用功能性表述(空调不制冷、火锅煮不熟、方言)。从表述到技术原因需多步推理。正确路径是'生活体验→反推技术原因集合→排序排查',而非关键词匹配",
"source": "AI供服员课题 / 低电压投诉调研报告(用户表述三层级结构)",
"date": "2026-08-10",
"action": "输入接口设计为反推引擎,建立'用户表述→可能故障→概率排序'的映射",
"transfer": ["医疗鉴别诊断", "IT运维根因分析"] }
注意"action"这个字段,行动含义。写不出行动含义,就不是真正的Insight。 这是"所以呢"测试的落地形态:逼你和Agent写清楚这条洞见改了什么做法,写不出来,降级。
为什么偏偏是JSONL、是文件夹?
先把一件事说透:这套库里,记录是Agent写的,检索也是Agent做的,人不需要读库。 你不会去翻insights.jsonl的第八百行,就像你不会去查数据库的原始表。人只在两个时刻出现:终审候选清单的时候,抽查的时候。这两个时刻Agent会把东西呈现给你——清单、卡片、报告。你读的是呈现,不是存储。
存储是给Agent的,那就该用Agent的原生格式。JSONL就是:一行一条JSON记录,一行一条知识。追加知识就是追加一行,Agent逐行读,零歧义,不用猜哪里是标题哪里是正文。等哪天要上数据库,把文件直接导入就行,一行一记录,天然对齐。
那为什么不是Notion或Obsidian?它们不是不能用,都是成熟工具,而且有真实的用法:把管理动作交给Agent,让它按固定结构往Notion数据库里写,让它维护Obsidian的双向链接。Agent用它们管理,人用它们抽查,这条路是通的。我没把它们当主存储,原因就一个:你的知识被锁在别人的系统里,Agent每次读写都要过它的接口,早晚受制于工具。文件夹是你自己的,任何Agent直接读写。
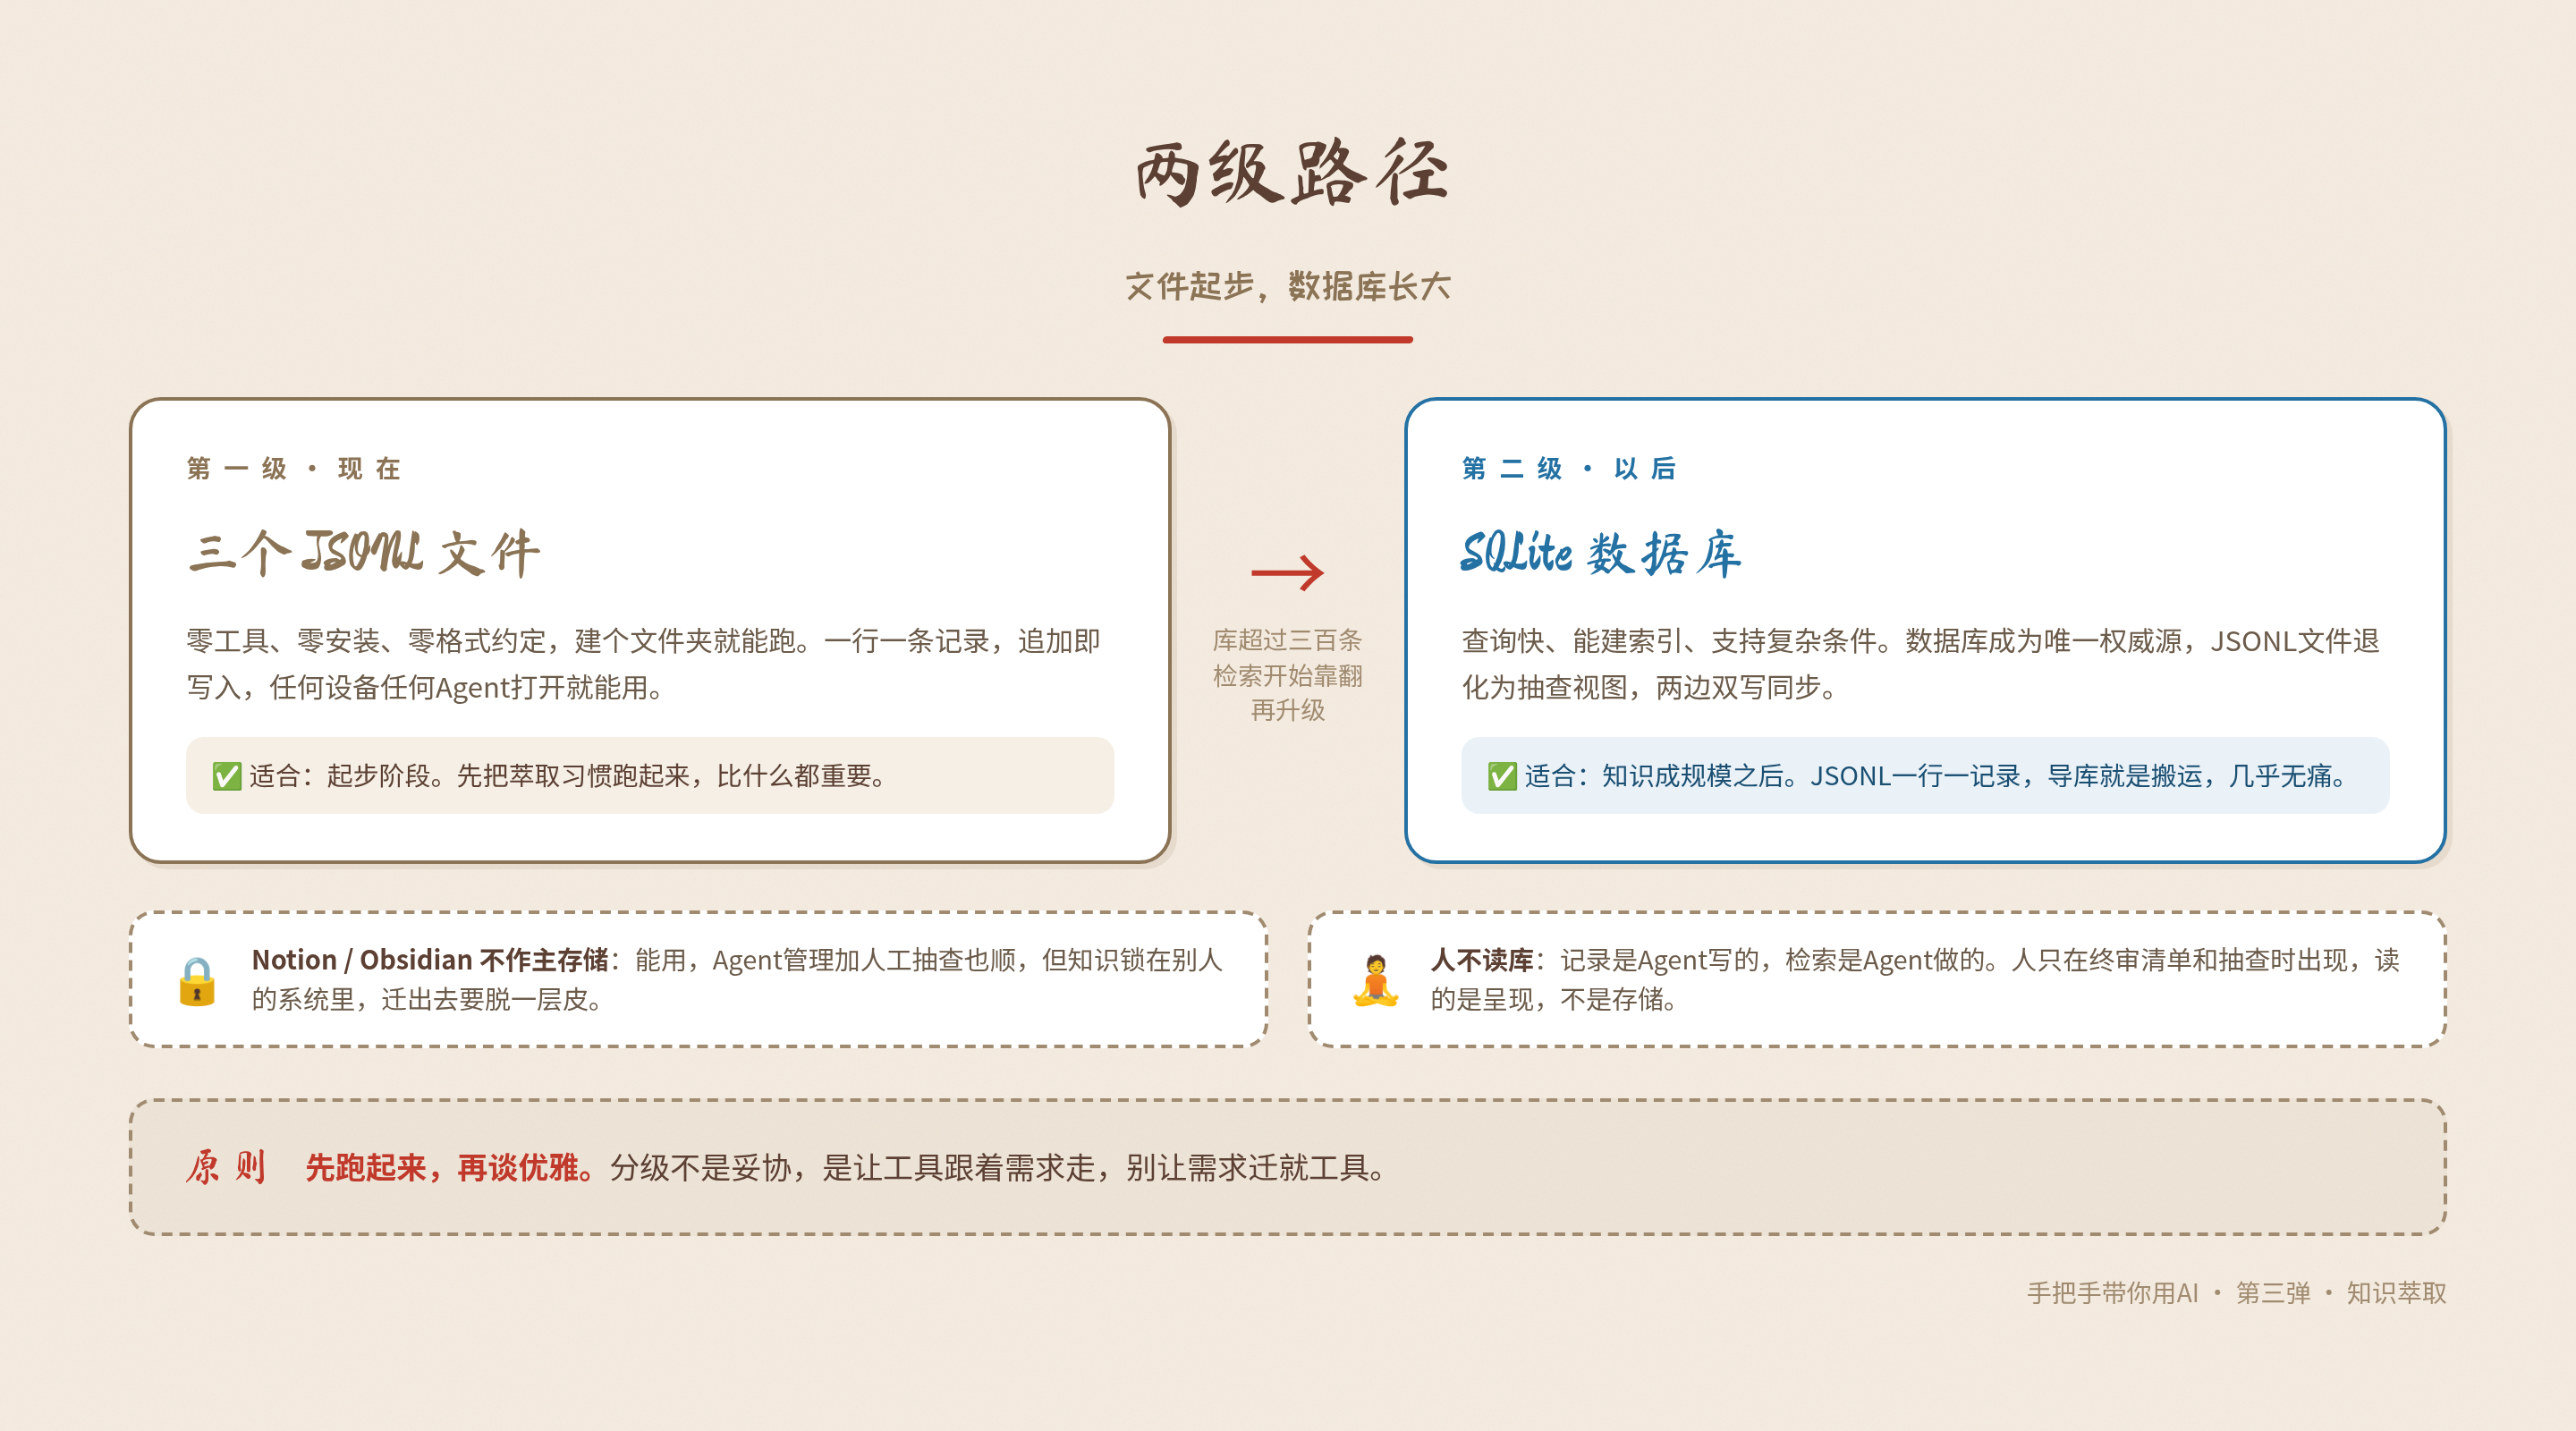
SQLite呢?查询能力碾压文件:全文索引、关联查询、溯源链一条SQL拉出来。我的生产库后来就是SQLite。但起步别上它——建库、定义表结构、维护同步,这些动作都在跟"坚持萃取"抢注意力。多少知识库死在了"先把工具配好"这一步,萃取本身还没开始。
所以路径就两级,都很省心:
起步,三个JSONL文件。 零工具零维护,AI追加一行就完事。先把萃取习惯跑起来。
规模大了,SQLite。 我的库跑到四百多条洞见时,文件开始撑不住:Agent要查"支撑这条洞见的所有断言",得一个文件一个文件翻着拼;要全文检索,只能一条条扫,又慢又漏。迁进数据库之后,全文索引、完整溯源链,一条查询直接拉出来。数据库是唯一权威源,JSONL文件退化为抽查视图,两边同步。而且这一步几乎无痛:JSONL本来就是一行一记录,导库就是搬运。
实操办法·萃取:找出来
体系搭好了,进入日常操作。知识的链路就三个动作:找出来、存下来、用起来。先讲第一个,萃取。
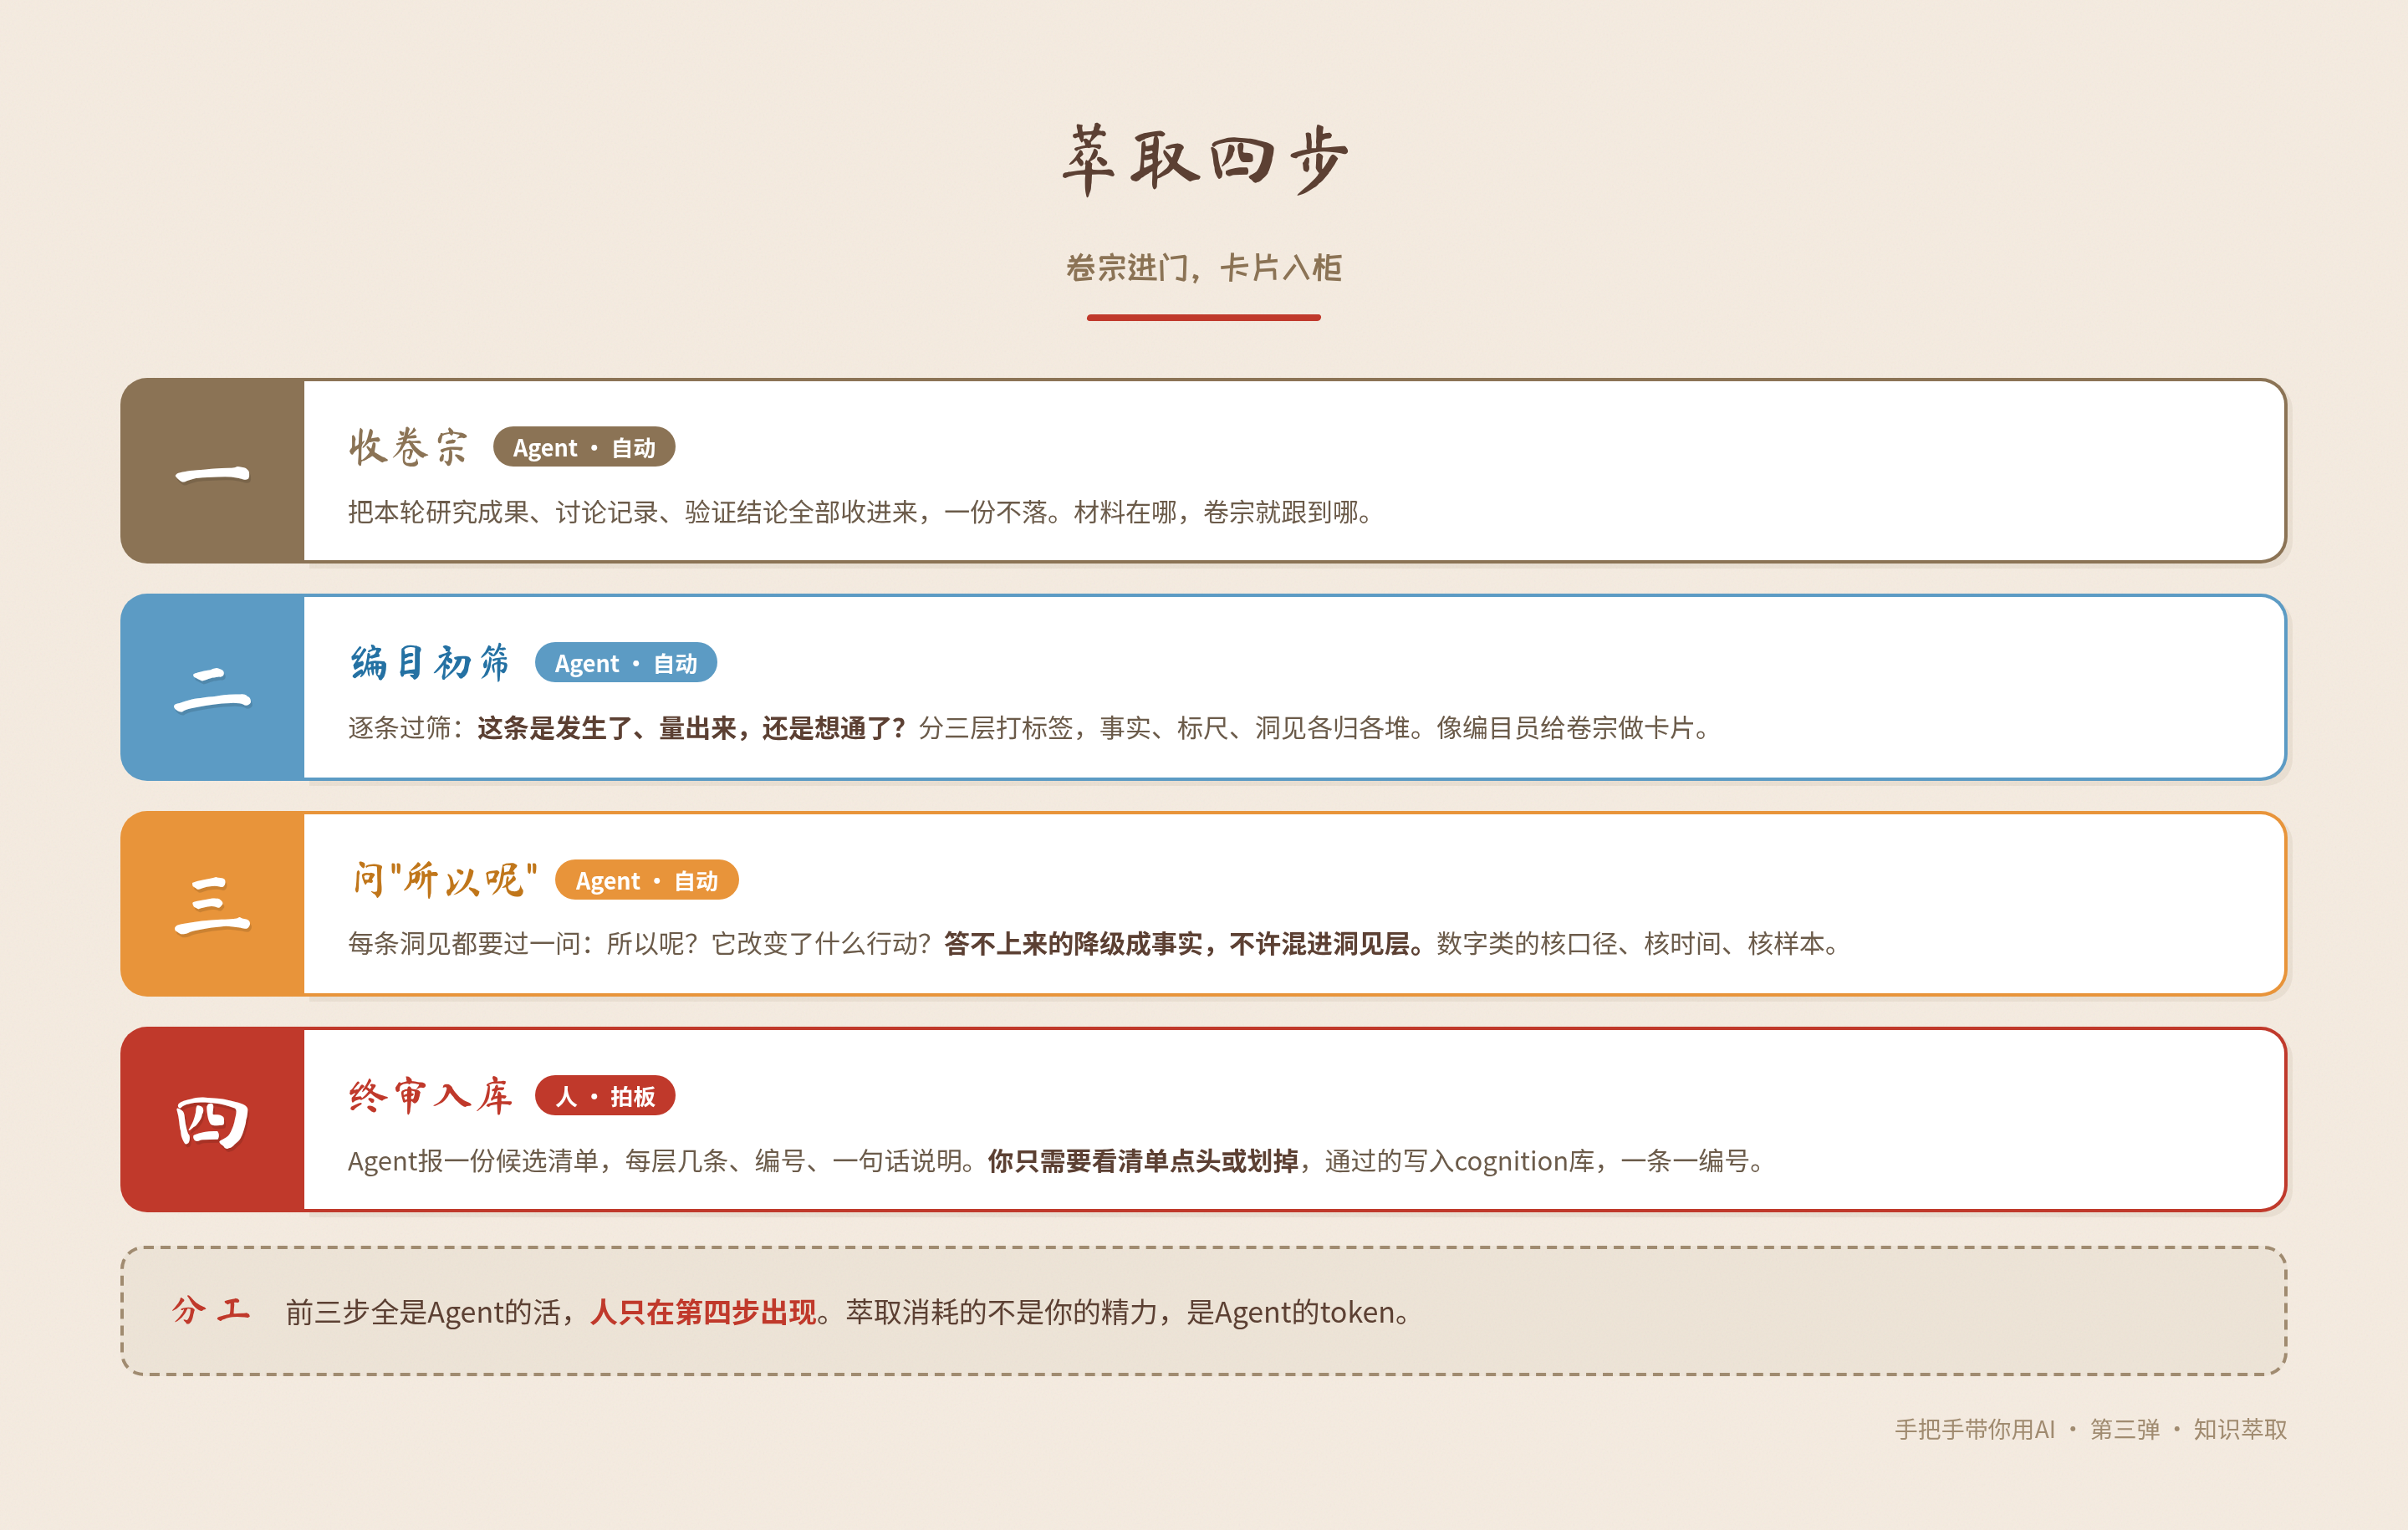
AI初筛三步,你终审一次
跑完一轮研究,课题文件夹里有retrievals(检索报告)、theory(分析过程)、harvest(确认结论)。什么时候萃取?Review过了、Harvest做完之后。萃取是Harvest的深化工序,没确认过的东西不进知识库。
AI做三步:
第一步:分类。 把每条内容识别为Fact、Metric或Insight。事实归Fact,量化发现归Metric,可能改变行动的进Insight候选。
第二步:测试。 对每条候选做"所以呢"测试。能回答"所以该怎么做"的保留,不能的降级。
第三步:过滤。 四类东西不许进Insight层:数据点、过程结论、工程设计、通识。
你做一步:终审。 AI报候选清单,你逐条断。这条真是Insight吗?它的"所以呢"成立吗?你否决的,让它记下否决原因。否决记录也是知识,省得下次同类候选再进来一遍。
拿真实场景走一遍。AI供服员课题,一轮研究跑完,课题里有六份专题调研报告(电压对家电的影响、低电压投诉规律、感知判定规则、气象与故障、行业对标、业务梳理)加一份方案文档,八份材料。AI初筛完交上来的总结单长这样:
萃取成果
| 层级 | 新增 | 当前总数 |
|------|------|---------|
| Fact | 22条 | 34条 |
| Metric | 19条 | 30条 |
| Insight | 11条 | 11条(首次创建) |
Insight清单(11条),按类分组:
- 感知规则类4条:变频化瓦解统一阈值 / 白炽灯淘汰导致感知方式迁移 / 静态阈值需动态校准 / 气温-负荷分段非线性
- 系统设计类3条:语义鸿沟需反推引擎 / 规则编码与数据接入可并行 / 确定-不确定层分离
- 服务范式类4条:气象驱动是范式转换 / 湿度关联度大于雨量 / 投诉触发是三重阈值链 / 感知端投入ROI高于处置端
你终审,逐条断。其中两条有意思:
"湿度对配网故障的关联度大于雨量",反直觉。所有人都盯着下雨,数据说湿度才是信号。行动含义:预警模型的输入权重,湿度排雨量前面。过。
"规则编码不必等待数据接入",听着像项目管理经验,但它过得了"所以呢":规则的逻辑来自国标和行业规范,独立于数据,只要接口契约定了,编码和接入就能并行。行动含义:交付周期从串行6个月压到并行3个月。过。这条后来直接改了那个课题的推进计划。
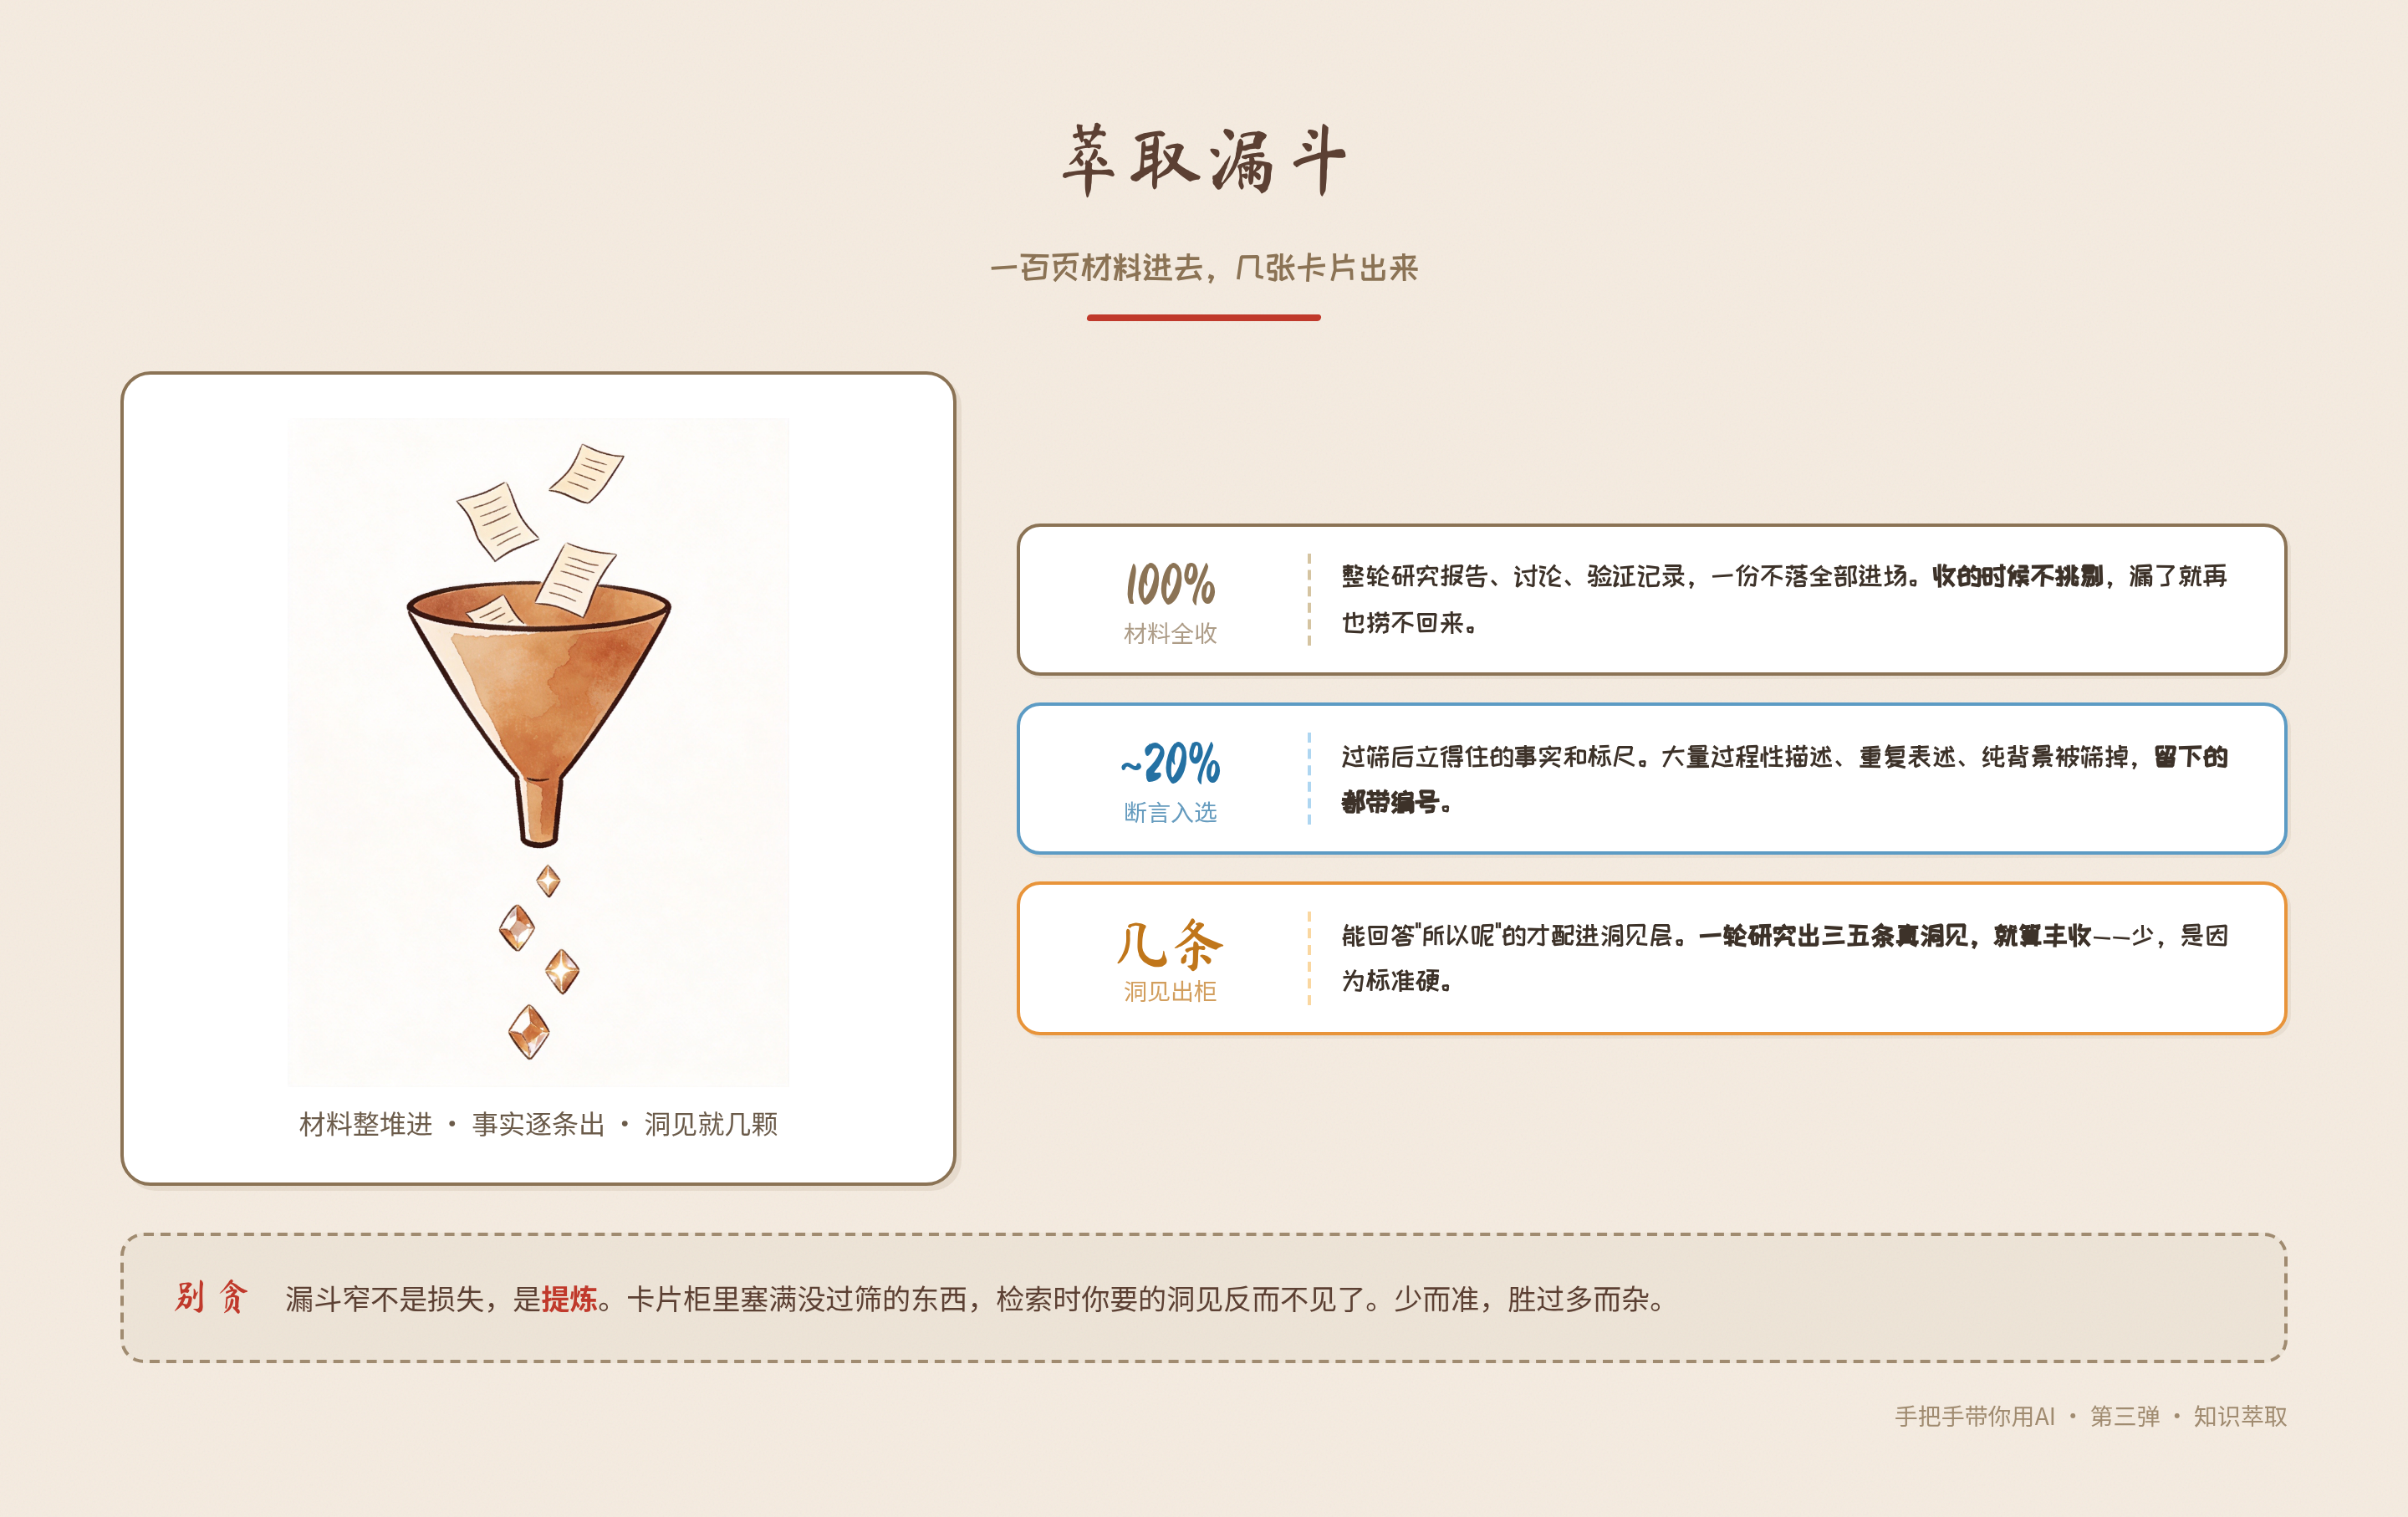
八份材料,十分钟终审,三十四个事实、三十条数据、十一条洞进入库。留意这个比例:材料八份,洞见十一条。萃取不是缩写,是编目。几百页卷宗,最后变成十一条卡片,但往后每个课题,取的都是这十一条。
再回头看那条"语义鸿沟",它的来源里既有投诉调研报告(材料),又有"用户表述三层级结构"的分析。洞见很少从单一材料里长出来,它长在材料的交叉处。 这也是为什么要先分层,分了层,AI才知道拿哪些层去碰。
实操办法·建库:存下来
存的三条纪律
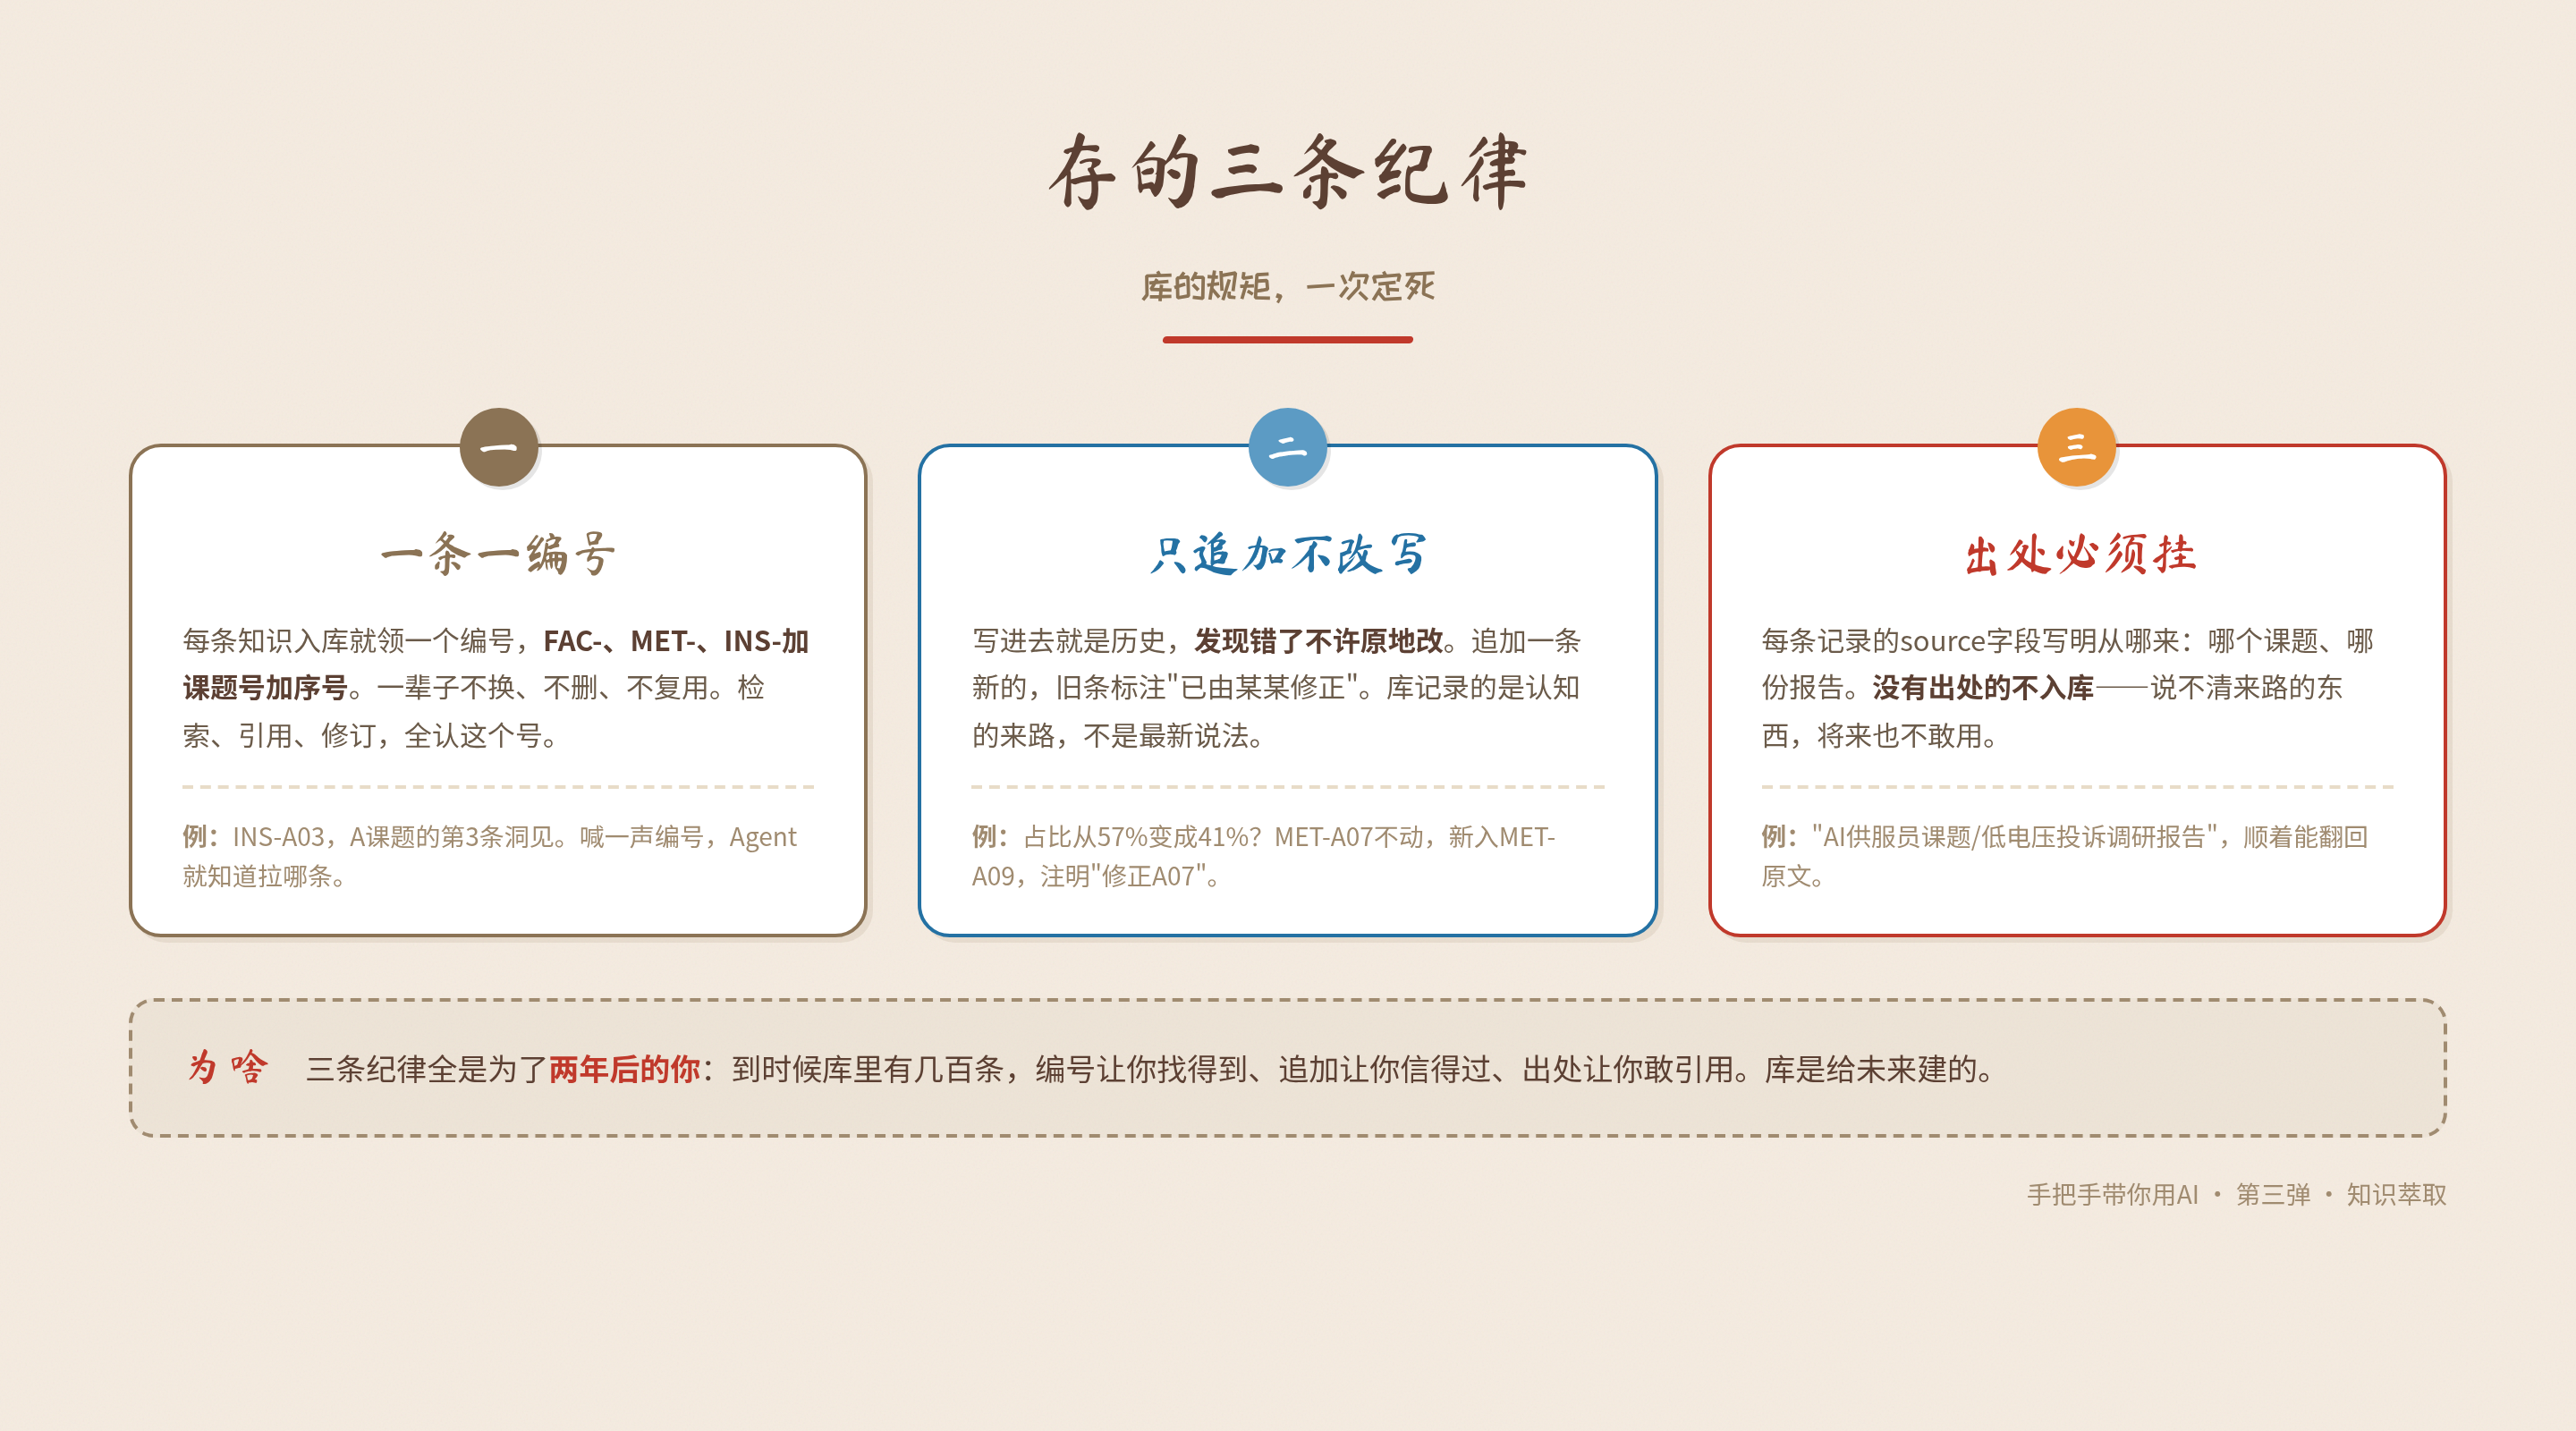
萃取出来的东西往哪存?上一章建的全局cognition库,三个文件,在这里落位。存的时候三条纪律:
一条一编号。 INS-A03就是A课题的第3条洞见。编号是它的身份证,往后任何地方引用这条知识,报编号就行,不用复述全文。
来源必须带。 从哪个课题、哪份材料里炼出来的,一行写清。三个月后你想引用它,靠这行字判断还作不作数。
Insight的行动含义一栏,空着不许入库。 写不出"改变了什么做法"的,退回去重写,写不出来就降级成Metric。这是"所以呢"测试的入库关卡。
库就是全局一份,没有第二处要同步。想快,可以让Agent在库旁边维护一份索引文件:一行一条,编号加一句话标题加课题来源。索引只做目录不放正文,找哪条先扫索引,快。
这里有个我踩过的真实坑,值得单独说:新萃取的内容别存成新文件。 有段时间,每轮萃取都生成一个facts_new,跟旧文件并排放着。文件越攒越多,检索时两处都要翻,编号还差点重复。后来知识管理课题里沉淀了一条Insight,直接把规矩定了:"关键认知应原子化保存,合并在同一文件"。一条一个最小单元,但都归进同一个facts文件,只增不改结构。一次萃取,追加写入,完。
四个坑,我都替你踩过了
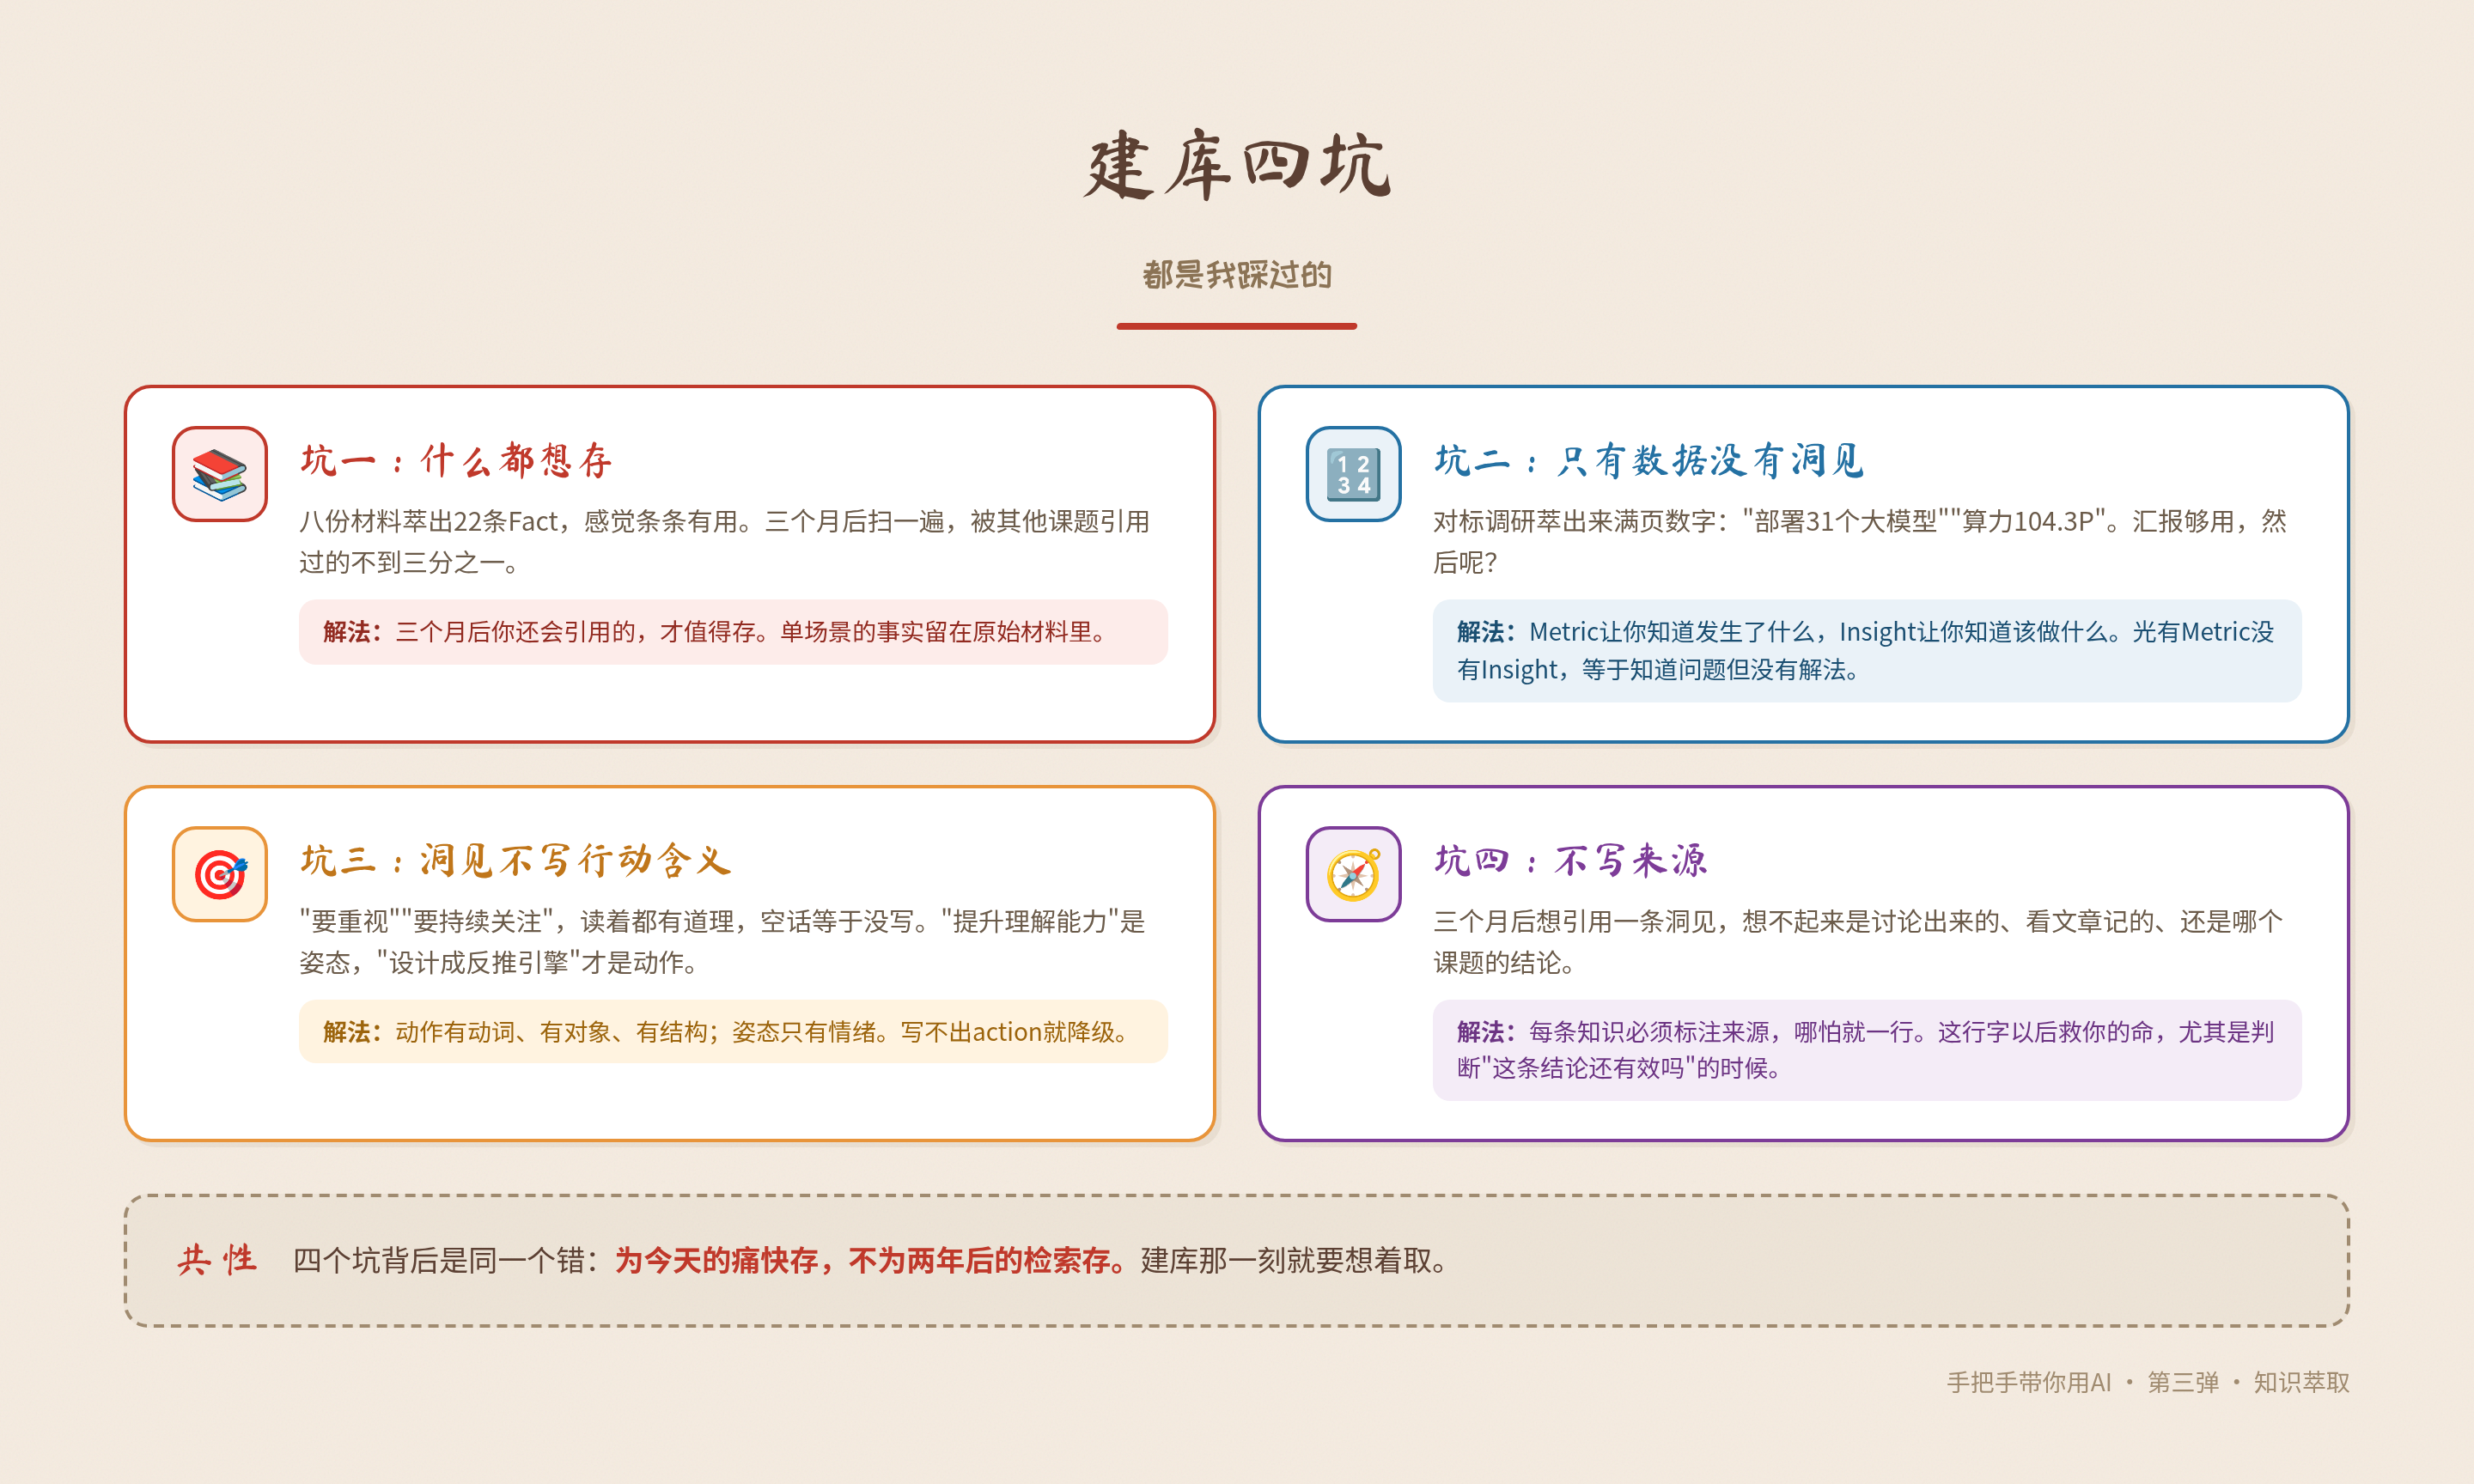
这套方法我跑了快一年,五十多个课题,库里累计四百多条洞见。四个最典型的坑,我都替你踩过了:
坑一:什么都想存。 八份材料萃出22条Fact的时候,感觉条条有用。三个月后扫一遍,真正被其他课题引用过的不到三分之一。三个月后你还会引用的,才值得存。 现在我的Fact层严格准入:只有可能被多个课题反复引用的事实才入库,单场景的事实留在原始材料里就好。
坑二:只有数据没有洞见。 那轮萃取Metric有30条、Insight有11条,比例还算健康。危险的是另一种课题:行业对标类调研,萃出来满页都是"某公司部署31个大模型""某网算力资源池104.3P",数字漂亮,汇报够用,然后呢?对标数字不告诉你做什么。Metric让你知道发生了什么,Insight让你知道该做什么。 光有Metric没有Insight,等于知道了问题但没有解法。
坑三:洞见不写行动含义。 每条Insight读着都有道理,但"行动含义"一栏空着,或者写成"要重视""要持续关注"这类空话。空话等于没写。对照一下就明白:"提升对用户表述的理解能力"是姿态,"输入接口设计成生活体验倒推技术原因的反推引擎"才是动作。动作有动词、有对象、有结构;姿态只有情绪。
坑四:不写来源。 三个月后想引用一条洞见,想不起来是讨论出来的、看文章记的、还是哪个课题的结论。我做知识库清理的时候翻出过一批条目,缺编号、缺来源链,清理它们花的功夫,比当初萃取时多写那一行字多出十倍不止。每条知识必须标注来源,哪怕就一行。这行字以后救你的命,尤其是你需要判断"这条结论还有效吗"的时候。
萃取的质量不在数量,在精度和连接。宁可少存,存了就确保它是对的、能用的、带出身的。
实操办法·应用:用起来——让AI在该想起的时候想起
建了库不用,等于没建。接着讲第三个动作,用起来。目标就一个:让开头那两件事,不再靠你的脑子兜底。
应用的核心思路一句话:把"你记得"换成"它必查"。 具体两个动作。
动作一:开新课题前,先过一遍已有知识
告诉你的Agent:我要开一个新课题,先读课题总览,再扫一遍cognition库,看有没有相关结论。
Agent会报三类东西:
能直接复用的。 "这个新课题的核心问题,你在某某课题里已经有一条洞见了。"研究起点直接前移。
相关但前提不同的。 "某某课题有条结论,但它的适用场景跟你这次不太一样,注意边界。"
可能矛盾的。 "你这次的方向,跟某某课题的一条结论打架。要么有一个错了,要么适用条件不同。"
真实案例。我后来开"敏感客户主动感知"课题,开题前扫库,Agent报上来的东西直接改了研究计划。
可复用:AI供服员课题的"投诉触发是三重阈值链"(INS-A08)——客户"感知异常→累积不满→情绪引爆"的三重阈值,可直接作为敏感客户识别的定量依据:累积阈值(如两个月内停电3次)就是判断客户进入敏感状态的触发线。配套的一条重复投诉率数据可支持建模。
边界提醒:该结论的样本来自低电压和频繁停电场景,本课题若涉及缴费类敏感,需重新验证。
一条旧洞见,让新课题的识别模型没从零起步。这就是复利入账的样子。
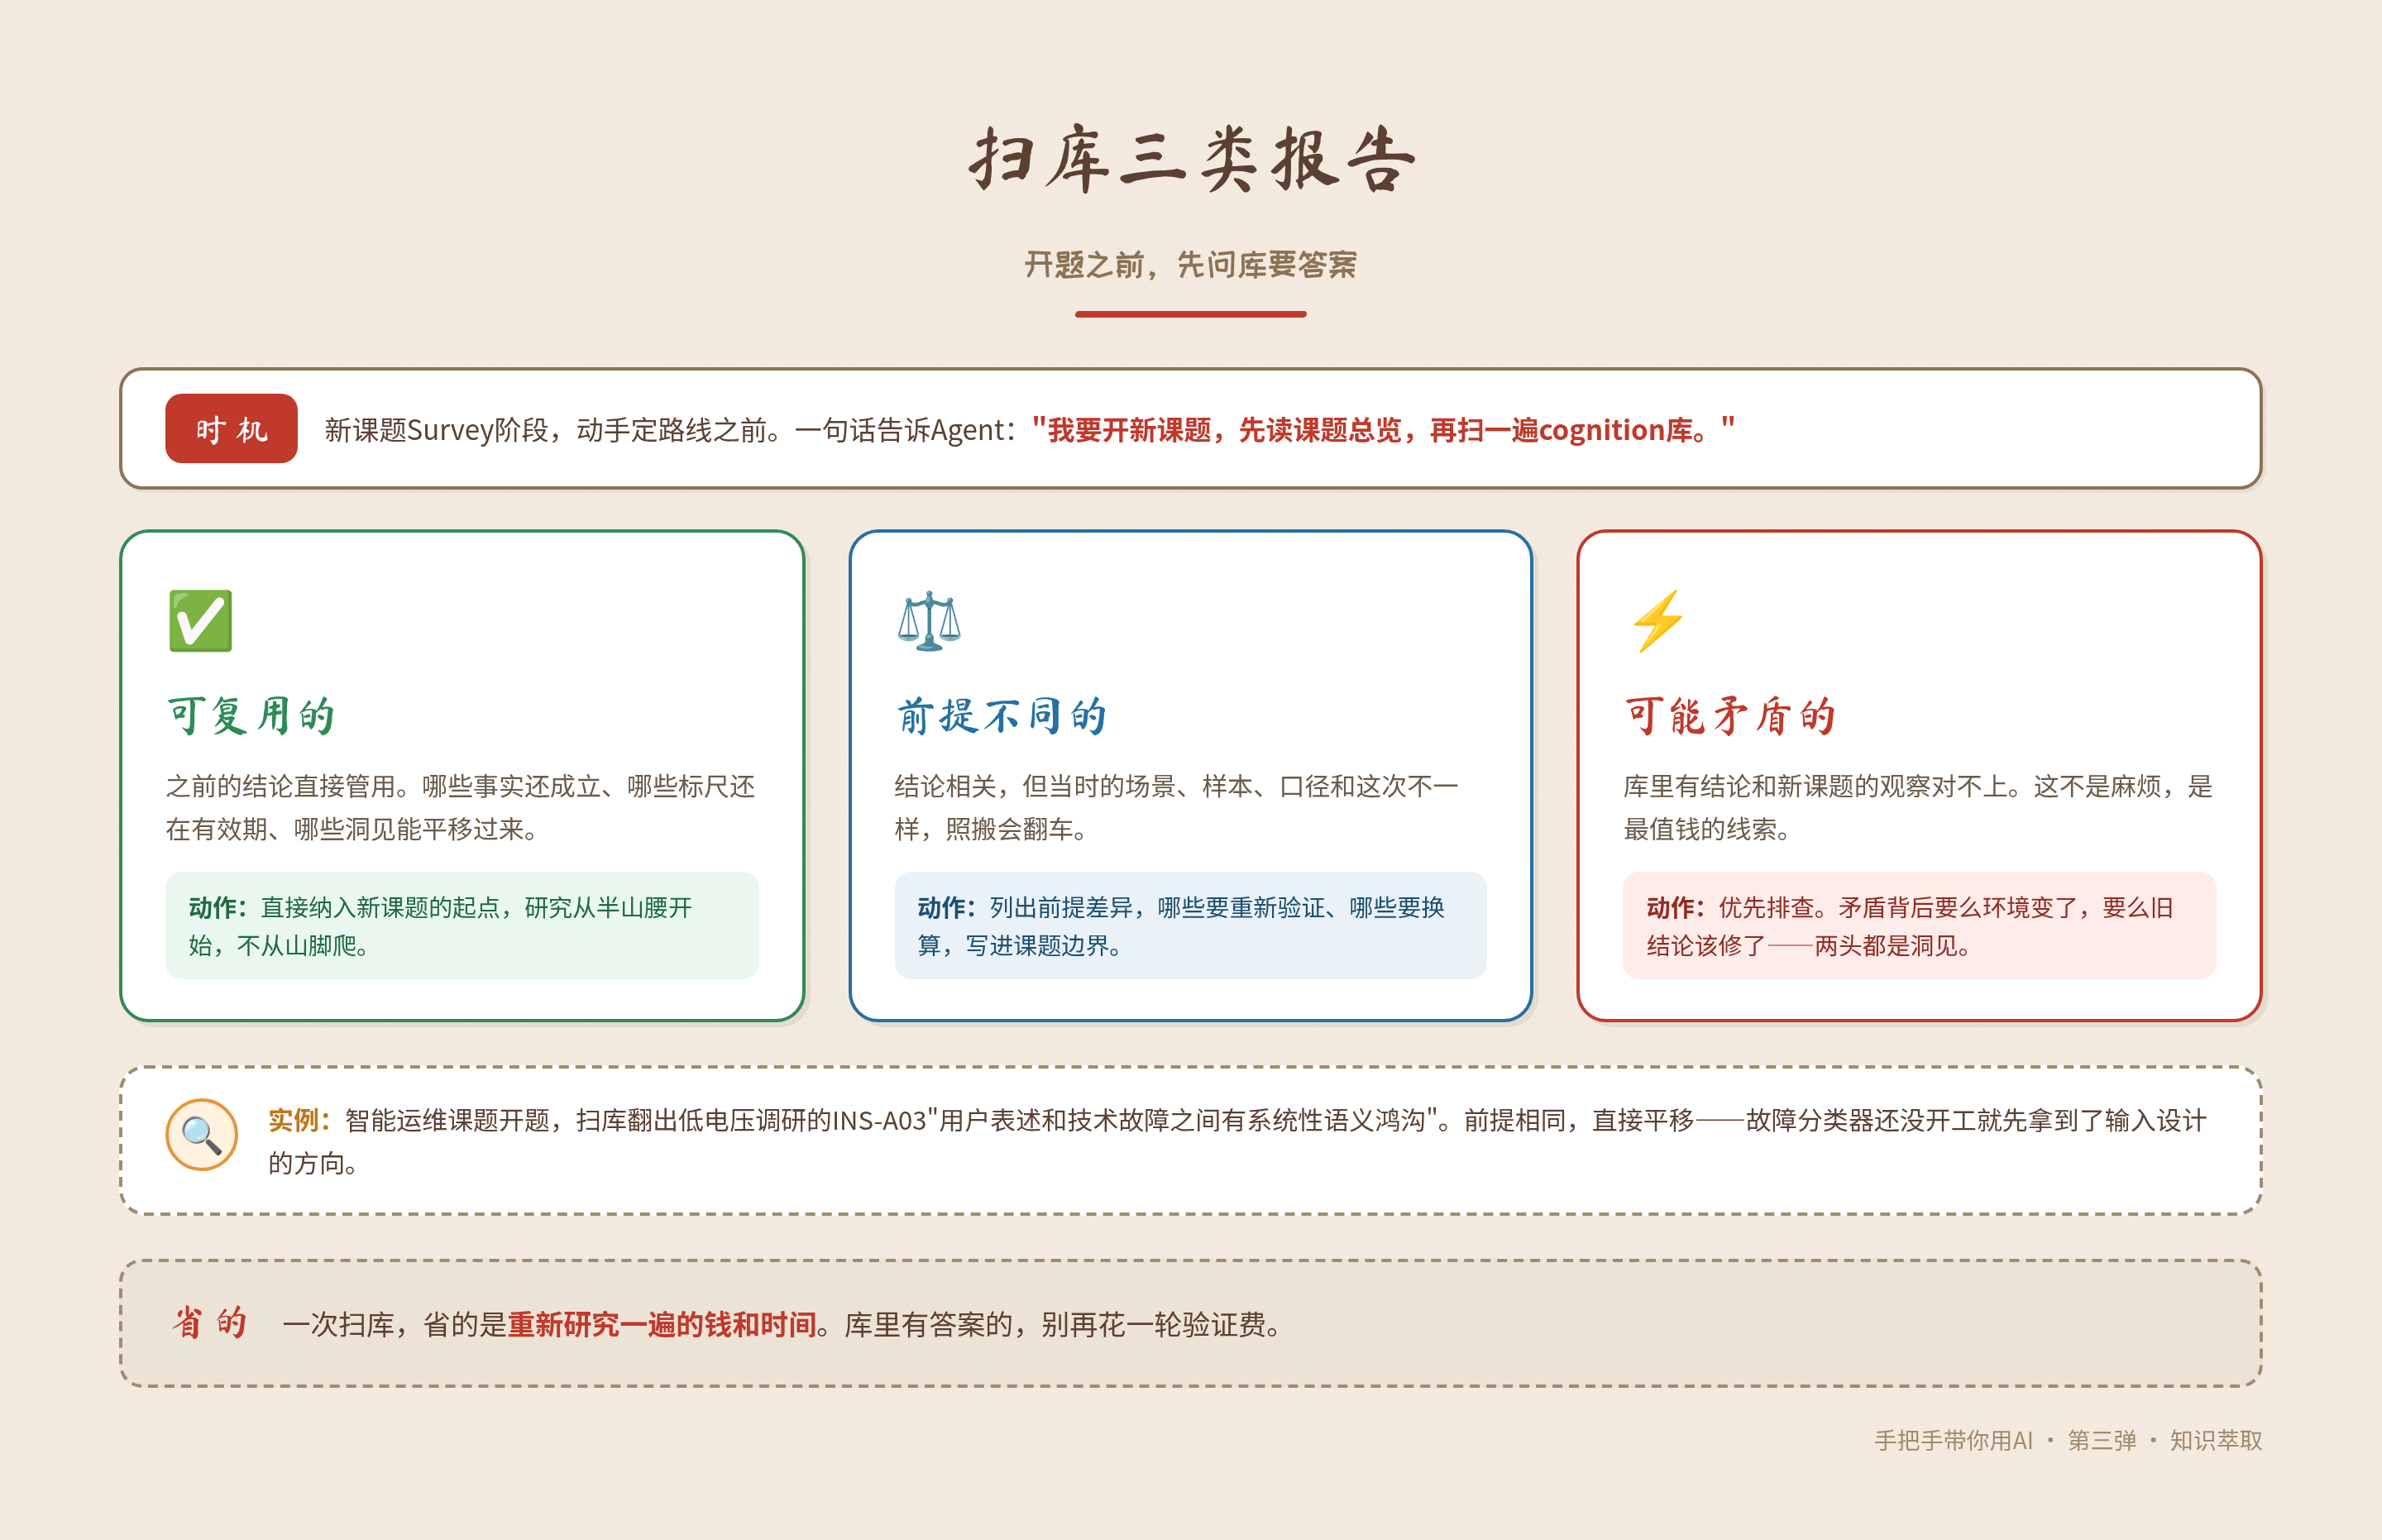
第三类"矛盾"最值钱。矛盾是知识墙上的裂缝,裂缝里全是新课题的研究问题。
动作二:老课题定期回扫
不是只有新课题才查知识库。跑了一段时间,让Agent反过来问一遍:这段时间新入库的洞见,有没有哪条,影响到更早的课题结论?
新知识反哺老课题,这是第二弹之前做不到的事。那时候课题之间是孤岛,现在知识全在同一个库里,随时倒流。
给你看一次真实的回扫收获。八月初我在知识管理课题里沉淀过一条判断:"通过分析别人的问题获得的洞见,可能无根,不是自己踩的坑,靠不住。"当时还觉得这标准挺严。
三周后回扫,这条结论撞上了新入库的几条洞见。它们全是从分析、讨论、碰撞里长出来的,每一条都实打实改了行动。照旧标准,它们全该判"无根"。矛盾了。
处理结果是一次修订,修订后的原文长这样:
INS-KG-009 "有根"的真实含义是认知摩擦,不是一手经验
此前判断"分析别人问题获得的洞见可能无根"是错误的。"有根"不等于"必须自己踩坑",而是有真实的认知摩擦——分析一篇有深度的文章、发现论证漏洞、提炼反直觉结论,这个认知过程本身就是摩擦。
注意这个格式:旧判断没有被删,它被点名修正,理由写明。 这就是知识库跟笔记本的区别。笔记本里的错页要么撕掉要么接着误导你;知识库里的错误结论,会变成"我们当初这么想、后来因为什么改了"的演化记录。这条修订记录本身,比原先那条正确结论更值钱。
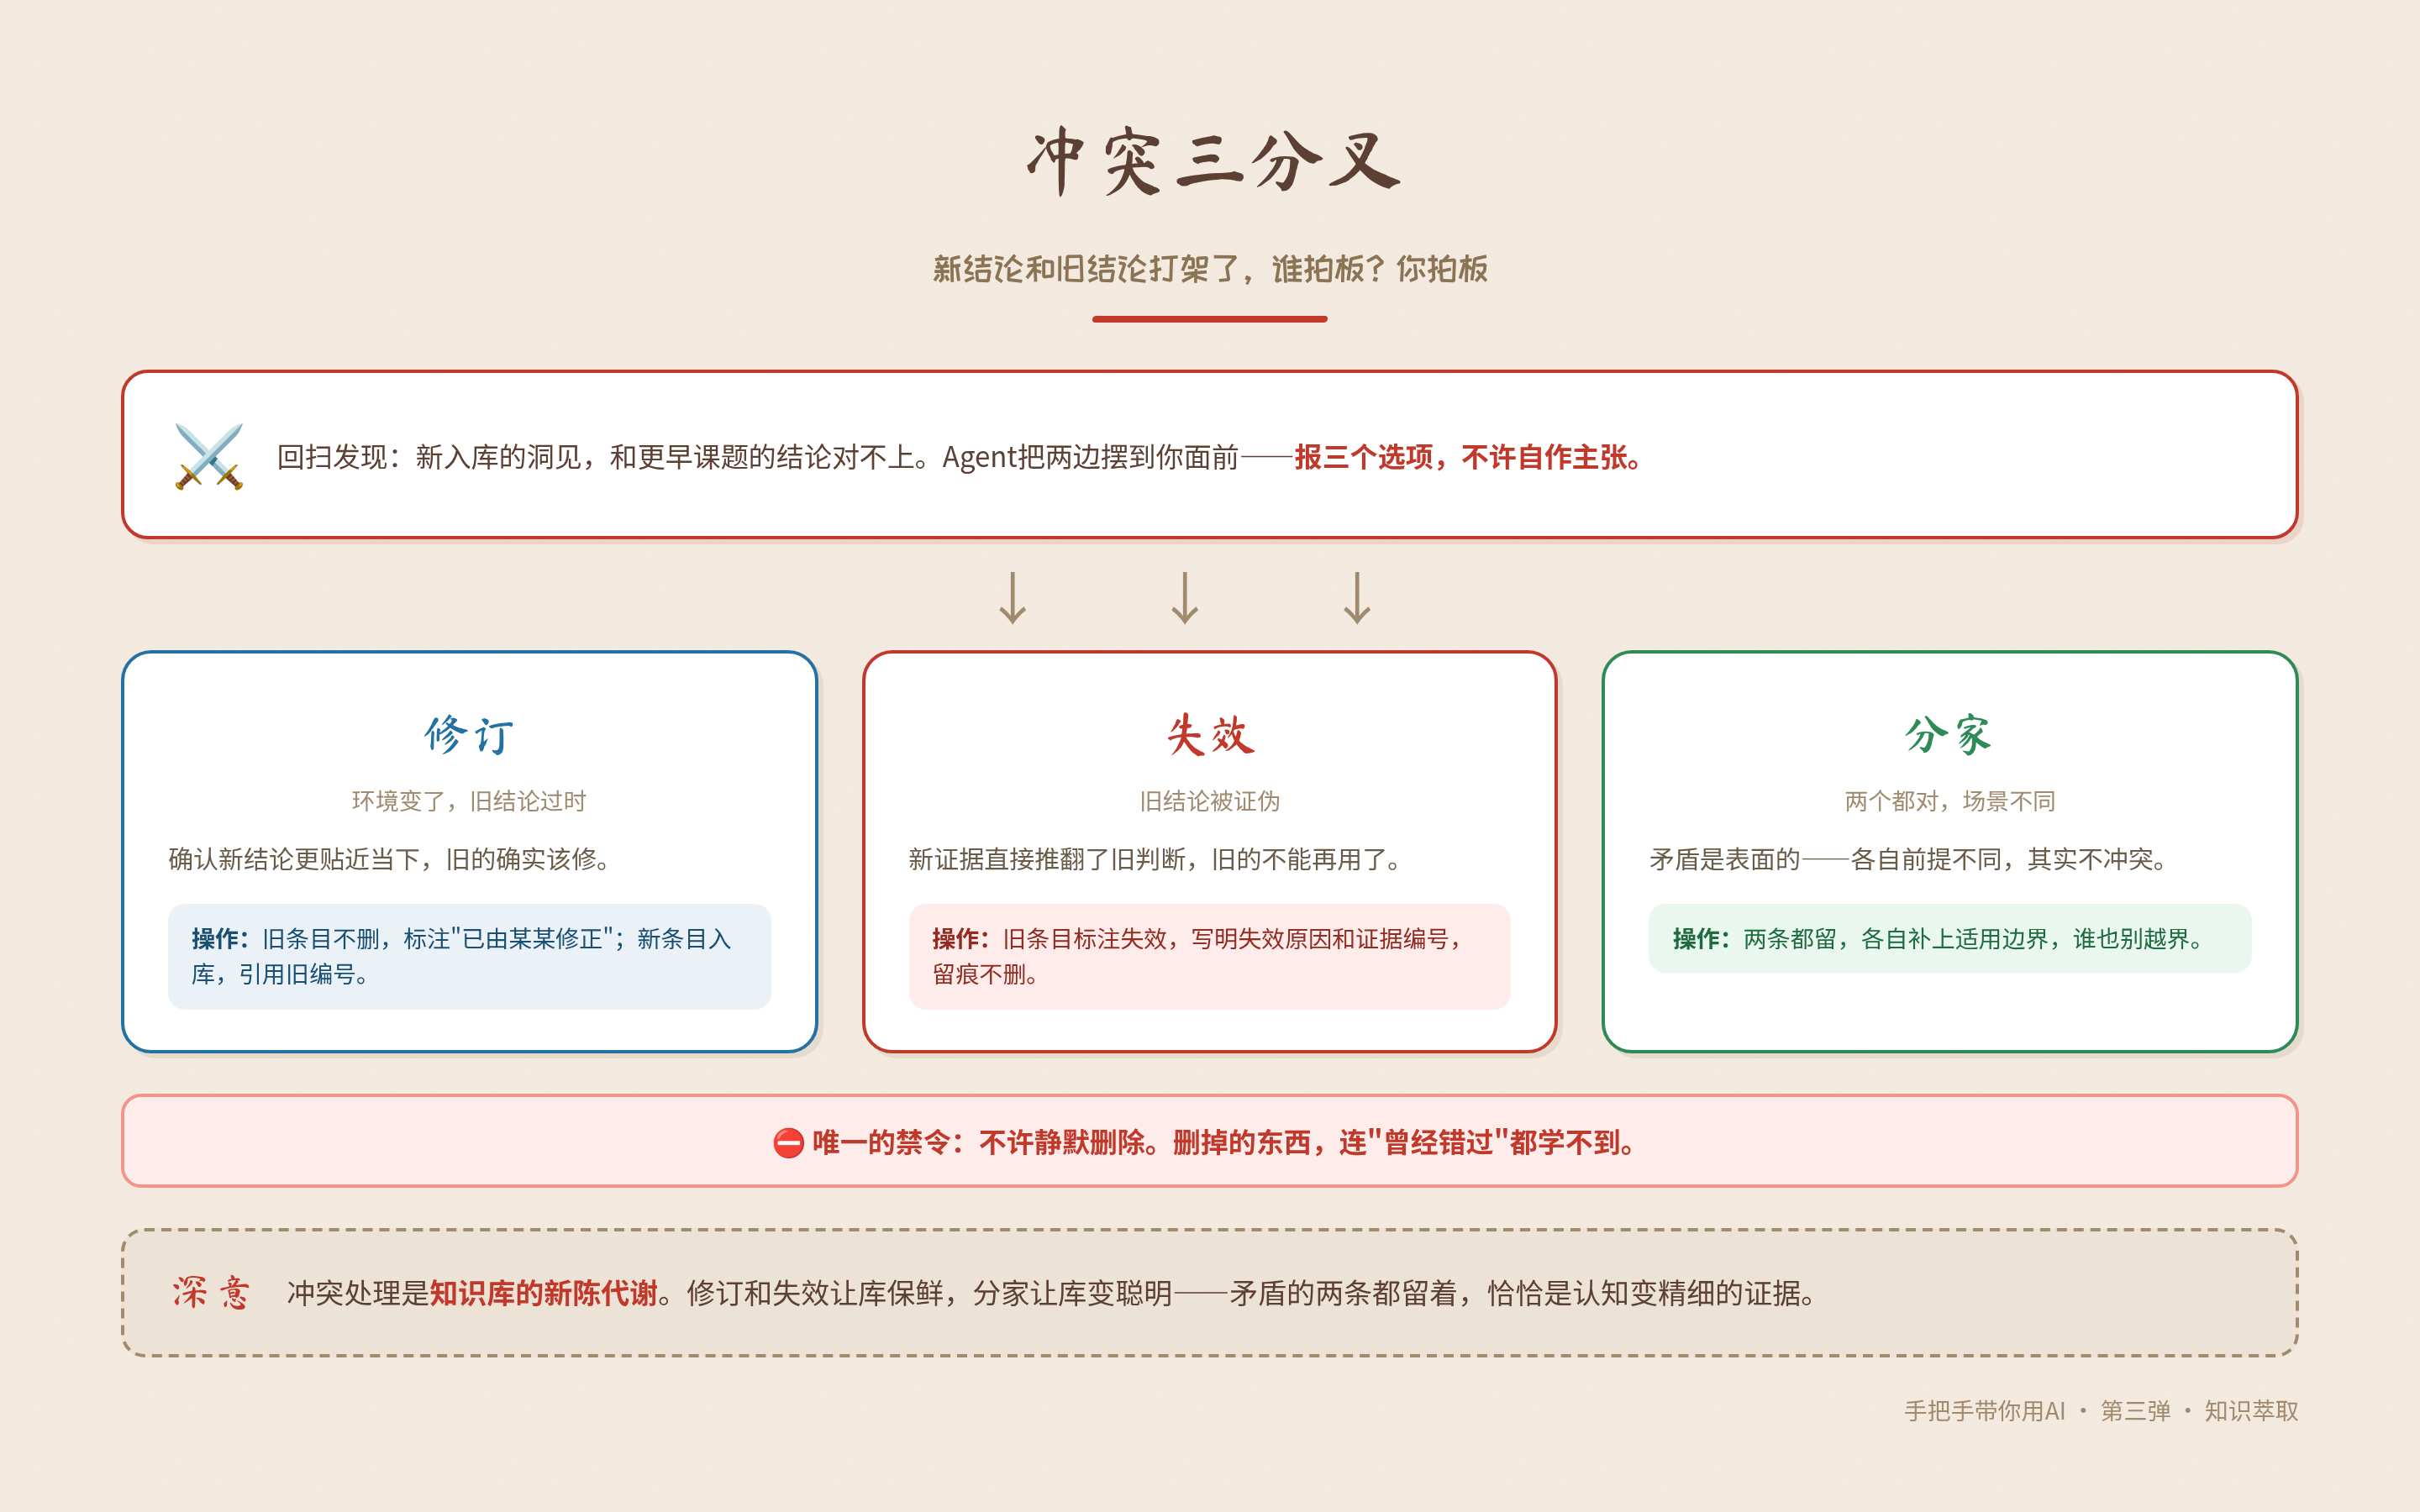
回扫撞上新旧冲突怎么办?三选一,让AI报方案你拍板:
- 修订:新证据充分,旧结论改写。旧条目不删,标注"已由某某修正",保留演化痕迹。
- 失效:旧结论依据的数据过期或场景消失。标注"已失效",原因写清。
- 分家:两个都对,只是适用条件不同。各自补上边界说明,从此各管一段。
共同点:没有一条是被静默删除的。
顺带一个高频场景:写作。写公众号、写汇报、答知乎,先让AI扫知识库:关于这个主题,我有哪些已有洞见?它报编号和标题,你挑几条展开。写出来的每个观点都有出处,观点之间自动带着你自己的体系感。 你现在读的这篇,引的每一条Insight都带编号,不是我背下来的,是扫库扫出来的。
提醒一句:查这一步必须用Agent做,不能靠纯对话框。因为要读写你的cognition库和课题档案,对话框里的AI看不见你的文件。
当你的知识库超过100条
这篇只讲三层,但先打个预防针。
跑久了你会发现,Insight层里混进两种东西。一种帮你理解问题:"57%的投诉有系统性根因,所以防控要治源头,不是治态度。"一种直接指挥你做事:"异常累积频次纳入客户敏感度监测。"前者是认知,后者是决定。
判别法:认知换个场景还成立,可迁移;决定绑着具体流程,可执行。我后来把Insight拆成COGNITION和DECISION两层,四层模型是从三层里长出来的。
但刚起步,别搞四层。 先把三层跑通。等你真超过100条、真觉得混在一起不好用了,再拆。别在设计系统上花时间,把时间花在萃取知识上。
技能:把方法装进Agent
讲交付物之前,先补一个观念:技能。这一弹的交付物全围着它转,值得单独说透。
技能和智能体是什么关系
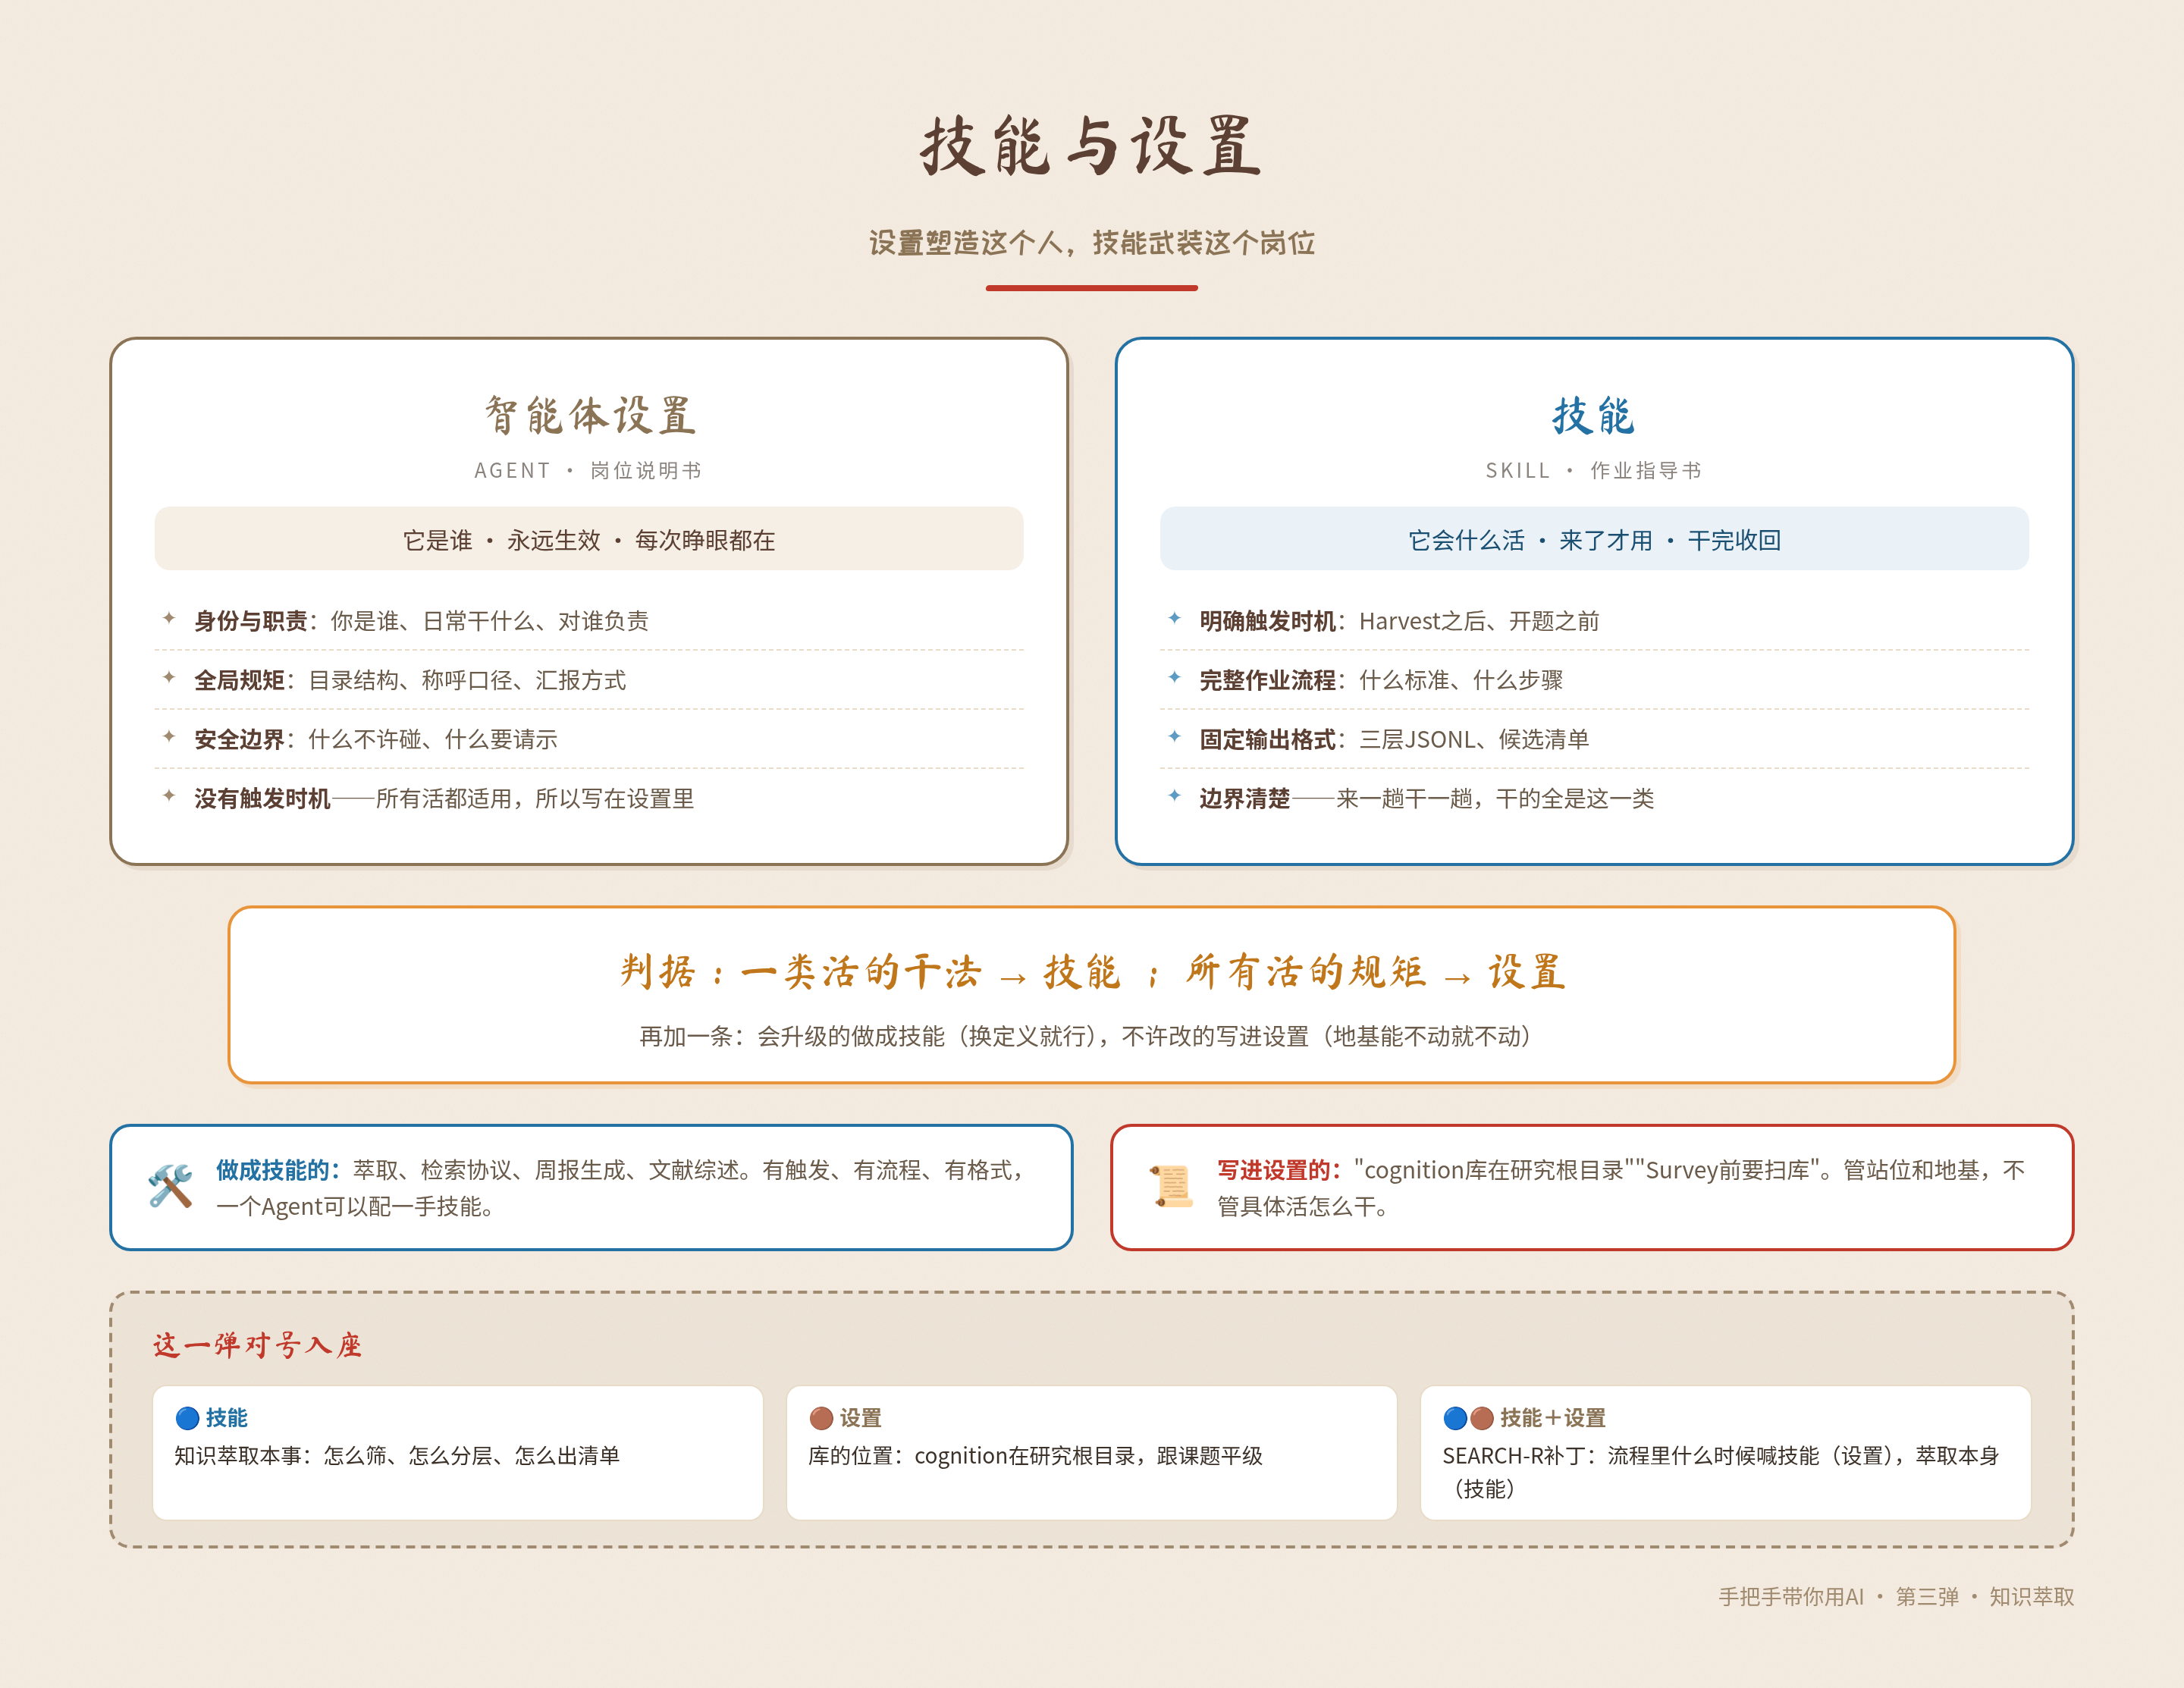
一个智能体(Agent),你把它理解成一个岗位。岗位说明书写在它的设置里:你是谁、日常职责是什么、文件放哪里、什么规矩。这些是常驻设置,Agent每次睁眼都在。
技能呢,是这个岗位的手艺。一段写清楚的作业指导书:遇到某类活,按什么标准、什么步骤、什么格式干完。平时收在工具箱,活来了掏出来,干完收回去。
两者的关系一句话:设置塑造这个人,技能武装这个岗位。 设置管它是谁,技能管它会什么活。一个Agent常驻一份设置,配一手技能。
跟Prompt比一下更清楚。Prompt是你贴一次、它做一次,下次还得再贴;技能装进Agent之后,到了特定时机它自己知道该用。知识萃取要的就是后者。它不是一次性任务,是每轮研究结束都要发生的固定工序,不该指望你每次记得手动贴一段话。
什么做成技能,什么写进设置
判断标准就一条:这段要求,是"一类活"的干法,还是"所有活"的规矩。
做成技能的:有明确触发时机、有完整作业流程、有固定输出格式的能力。萃取就是典型——触发时机是Harvest之后,流程是初筛加终审,输出格式是三层JSONL记录。同类还有:检索协议、周报生成、文献综述。特征是边界清楚,来一趟干一趟,干的全是这一类。
写进设置的:全局都要遵守的规矩。文件目录结构、称呼口径、汇报方式、安全边界。比如"课题档案统一放研究根目录"这条,它不属于任何一类活,是所有活的地基,写进设置。特征是没有触发时机,永远生效。
拿这一弹对号:知识萃取本身是技能;而"cognition库在研究根目录、跟课题平级"是设置;"SEARCH-R流程在Survey前和Harvest后调用萃取技能",也是设置——它管的是流程站位,不是萃取本身怎么干。
还有一条实用判据:会升级的做成技能,不许改的写进设置。 技能是活的,萃取方法迭代了,换一份技能定义就完事,Agent其他部分纹丝不动。设置是地基,能不动就不动。
实操交付物
观念讲完了,上货。三个交付物,正好对应这一弹的三步。萃取技能,把上一章的手艺装进Agent,平台通用,扣子、ChatGPT、Claude都行。知识库的schema和初始化指令,把库一次建对,格式定死不靠猜。SEARCH-R升级补丁,在流程对应环节显性调用技能。三张长图分别放在三节末尾,存图照配,拿来就用。
交付物①:知识萃取技能
第一个交付物就是萃取这门手艺的作业指导书,装进你日常用的Agent。扣子里可以做成子流程或插件;ChatGPT里存成Projects的自定义指令;Claude里就是一个SKILL文件。
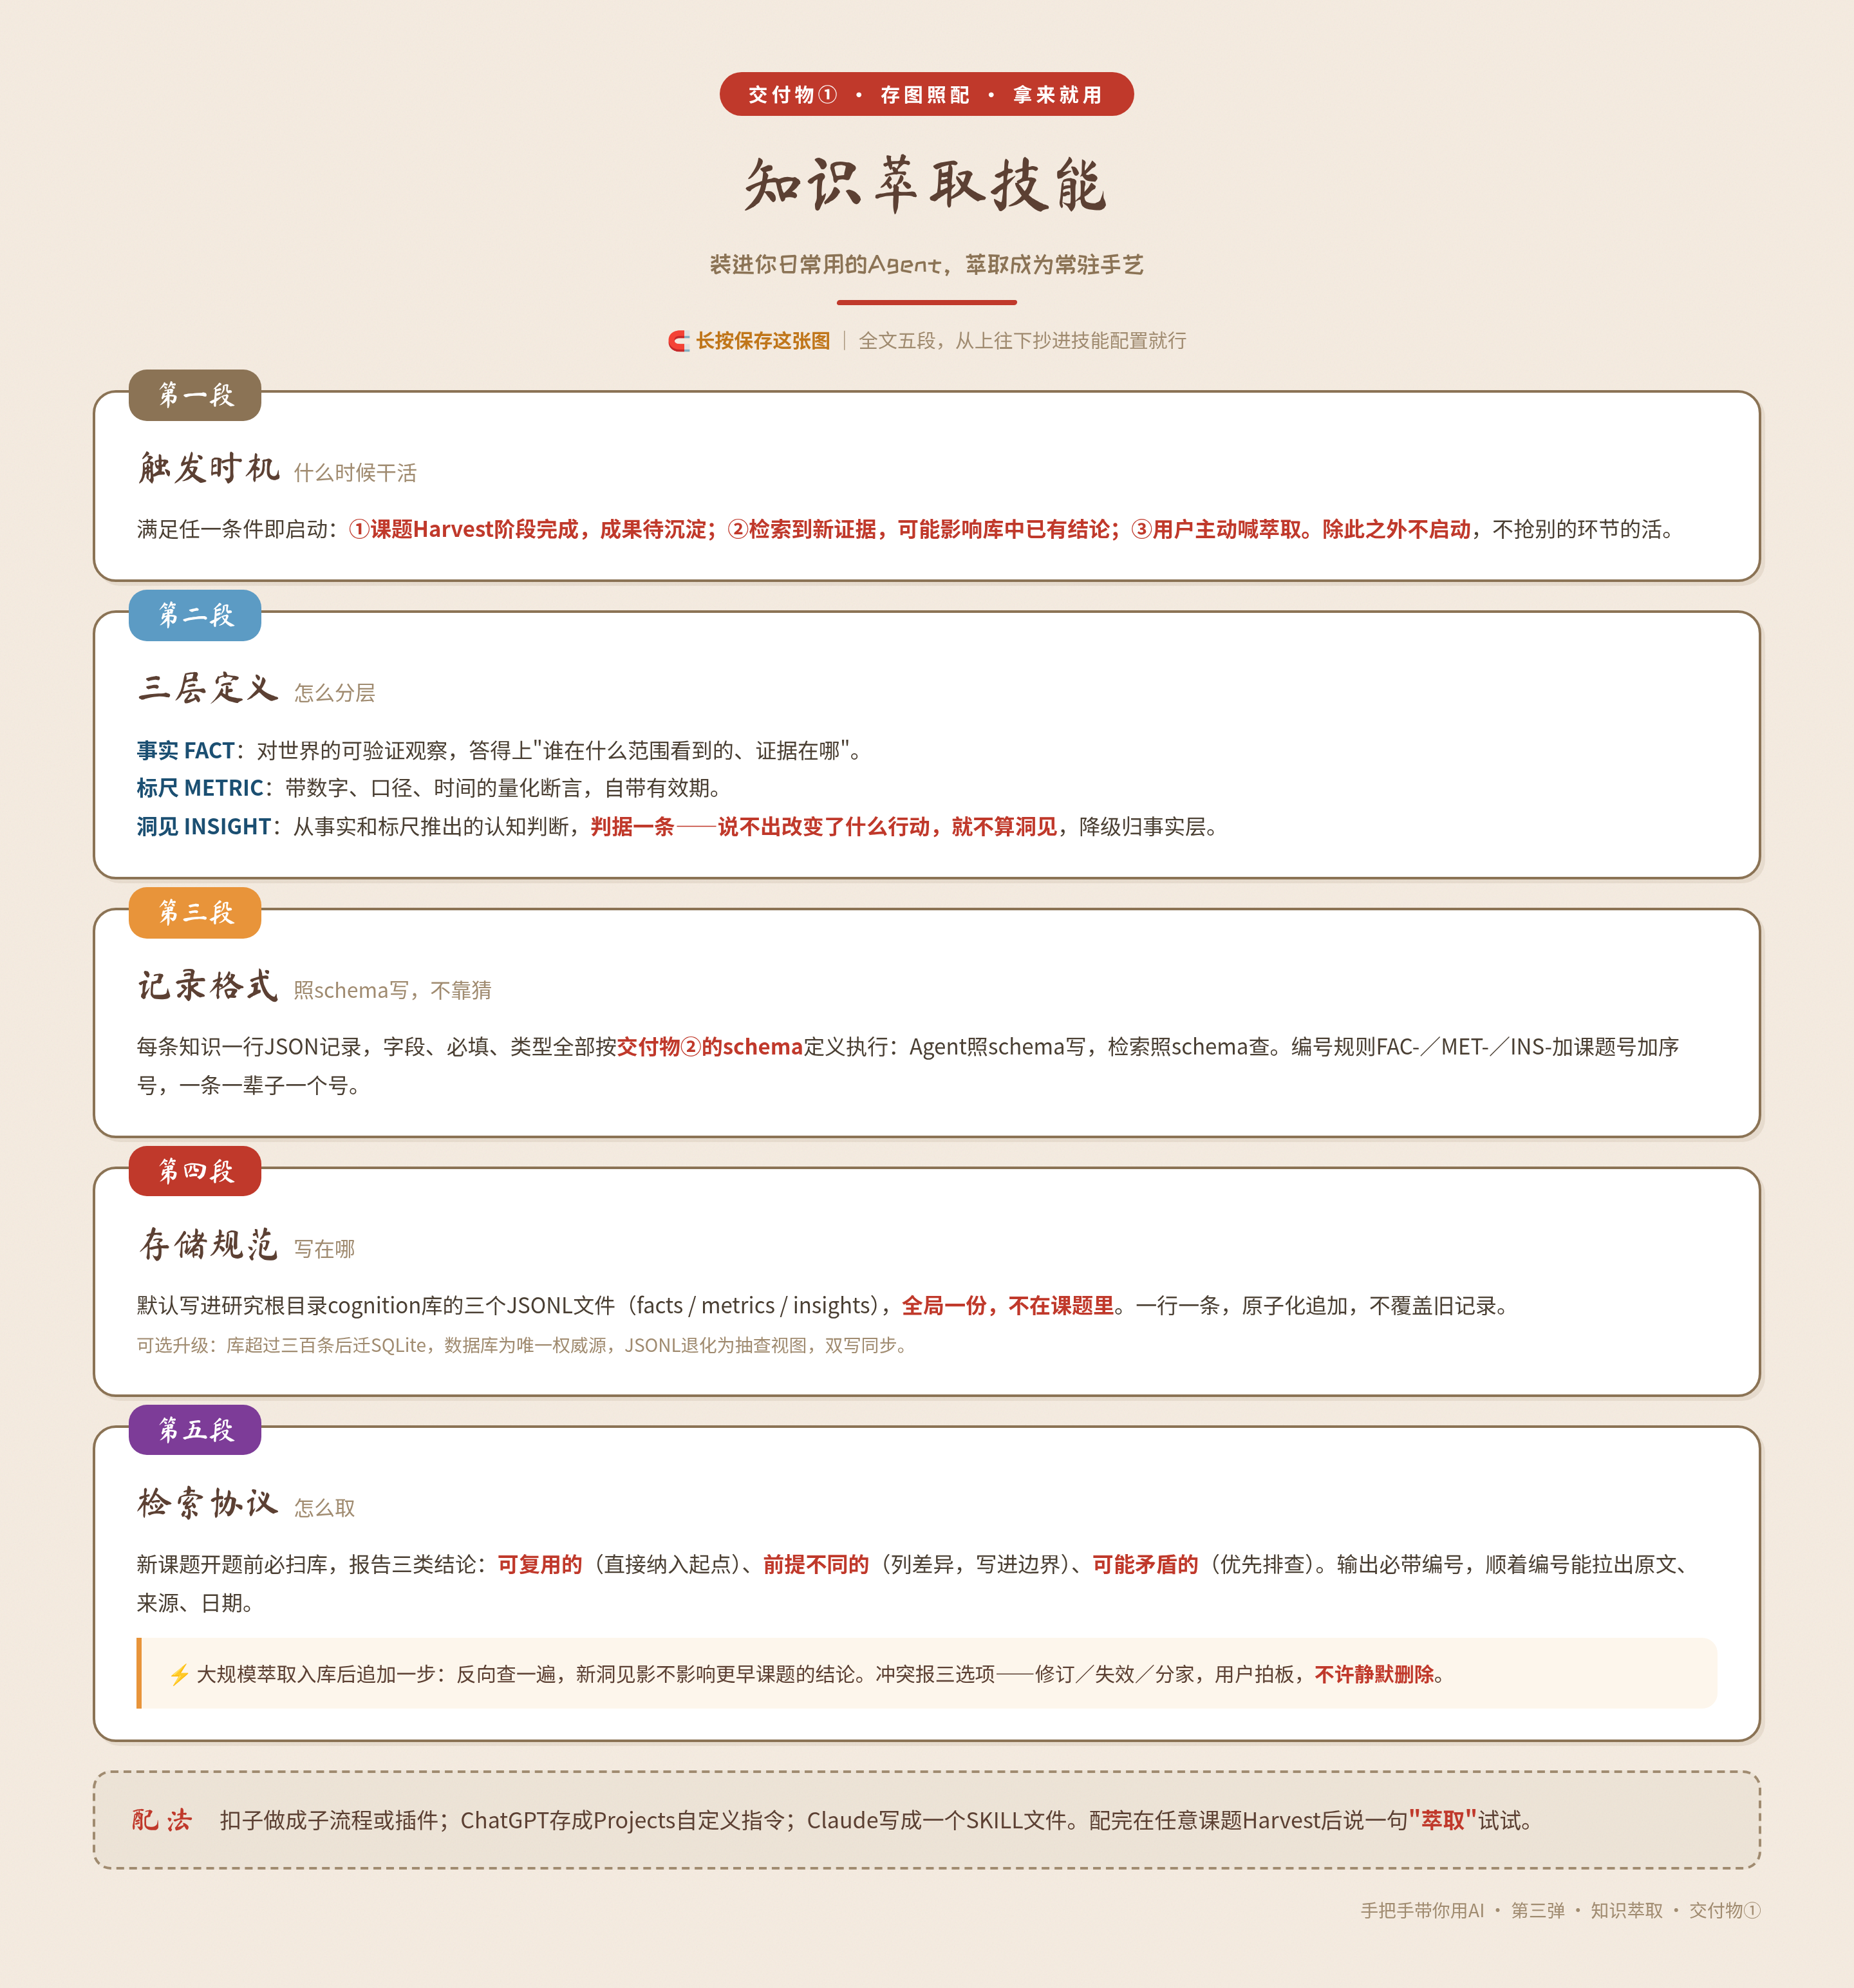
技能全文我做成了一张文字长图,就放在本节末尾,存下来照着配就行。这里先把骨架讲清楚,一共五段。
触发时机。 什么时候自动用:每轮研究完成Harvest之后,自动萃取本轮成果;开新课题之前,自动跑检索协议;你说"萃取""入库""扫库"这些词的时候。
三层定义。 Fact、Metric、Insight各是什么、判据是什么,跟这一章讲的一致。再加上四类不合格内容,数据点、过程结论、工程设计、通识,一律不许进Insight层。
记录格式。 技能不自造格式,直接引用交付物②的schema:每层一条记录有哪些字段、哪些必填、什么类型,在那里全部定义死。Agent照schema写,检索照schema查,不靠猜。Insight层的action字段必填,写不出来就不算Insight。
存储规范。 默认写进研究根目录cognition库的三个JSONL文件,全局一份,不在课题里。一条一编号,一行一条记录,原子化追加。SQLite是里面的可选升级项:库超过三百条、检索开始靠翻文件拼的时候再启用。启用后数据库是唯一权威源,JSONL退化为抽查视图,写入双写同步。
检索协议。 技能的另一半。开新课题前扫库,报告三类结论:可复用的、前提不同的、可能矛盾的。引用必须报编号,矛盾必须显式上报、不许自行调和,库里没有就说没有,不现编。
测试方法:找一个你之前跟AI聊过的研究话题,触发技能跑一遍。Insight数量是0?别慌,说明之前的研究停在信息收集阶段,大部分人都是这样,从现在开始就行。Insight很多但质量不高?逐条做"所以呢"测试,写不出行动含义的降级。
交付物②:知识的schema和初始化指令
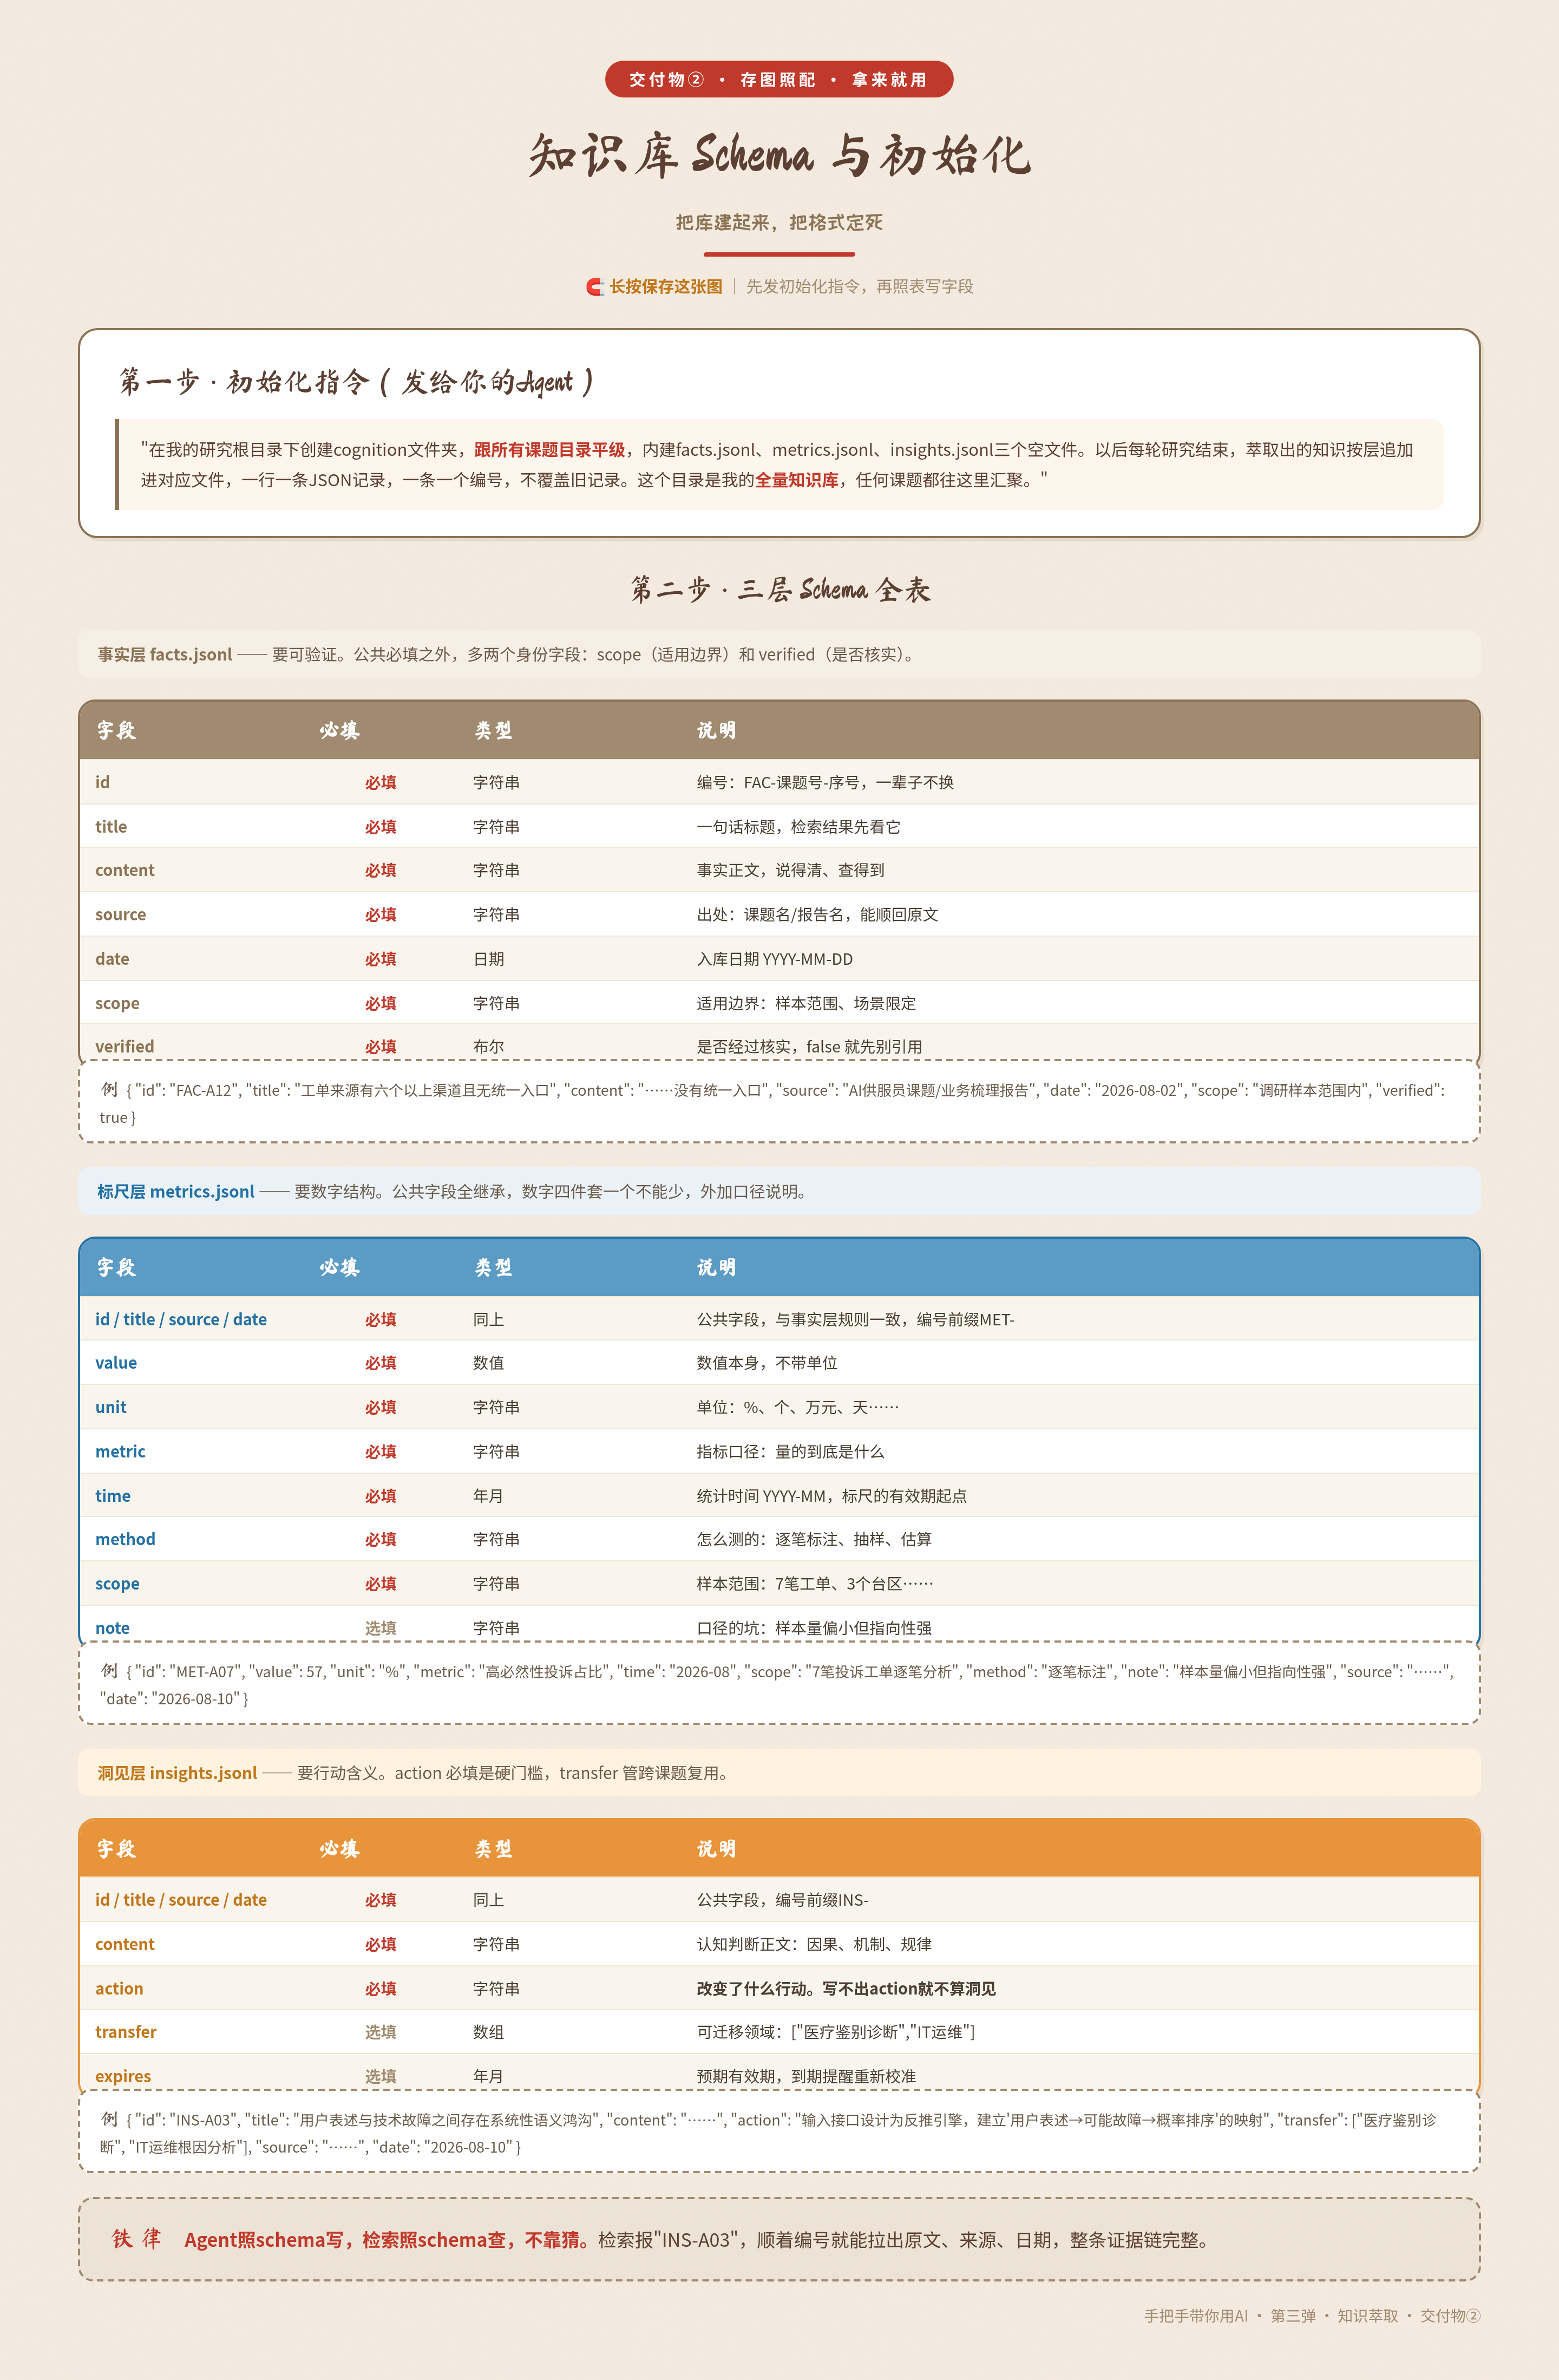
手艺教完了,还得有个地方放成果。第二个交付物干两件事:把库建起来,把格式定死。库就是前面说的全局cognition目录,初始化一次,往后所有课题共用。
先说初始化指令。把这段话发给你的Agent,一次就位:
在我的研究根目录下创建cognition文件夹,跟所有课题目录平级,内建facts.jsonl、metrics.jsonl、insights.jsonl三个空文件。以后每轮研究结束,萃取出的知识按层追加进对应文件,一行一条JSON记录,一条一个编号,不覆盖旧记录。这个目录是我的全量知识库,任何课题都往这里汇聚。
再说schema。三个文件结构相同,都是一行一条JSON记录,但每层字段不一样,这就是三层知识的身份证差异。完整字段表我做成了长图,就放在本节末尾,存图即用。先看每层的核心字段:
Fact层,要可验证。id、title、content、source、date必填,再带两个Fact专属字段:scope,这条事实的适用边界;verified,是否经过核实。
{ "id": "FAC-A12", "title": "工单来源有六个以上渠道且无统一入口", "content": "工单来源包括客服热线、政务热线、本地电话、微信群、营业厅等六个以上渠道,没有统一入口", "source": "AI供服员课题/业务梳理报告", "date": "2026-08-02", "scope": "调研样本范围内", "verified": true }
Metric层,要数字结构。Fact的必填字段都继承,另外必须带value、unit、metric、time四件套:数值、单位、指标口径、统计时间。再加method说明怎么测的,note记口径的坑。
{ "id": "MET-A07", "title": "高必然性投诉占比57%", "value": 57, "unit": "%", "metric": "高必然性投诉占比", "time": "2026-08", "scope": "7笔投诉工单逐笔分析", "method": "逐笔标注", "note": "样本量偏小但指向性强", "source": "AI供服员课题/低电压投诉调研报告", "date": "2026-08-10" }
Insight层,要行动含义。还是那些必填字段,但action必填,写不出action就不算Insight。再加transfer,这条洞见能迁移到哪些领域,跨课题复用就靠它。
{ "id": "INS-A03", "title": "用户表述与技术故障之间存在系统性语义鸿沟", "content": "用户不用专业术语,用功能性表述。从表述到技术原因需多步推理,正确路径是'生活体验→反推技术原因集合→排序排查'", "action": "输入接口设计为反推引擎,建立'用户表述→可能故障→概率排序'的映射", "transfer": ["医疗鉴别诊断", "IT运维根因分析"], "source": "AI供服员课题/低电压投诉调研报告(用户表述三层级结构)", "date": "2026-08-10" }
编号规则也定死在schema里:FAC-、MET-、INS-加课题号加序号,库里的每条知识一辈子只有一个编号,检索引用全靠它。
Schema定死的好处就一句:Agent照schema写,检索照schema查,不靠猜。 检索报"INS-A03",你顺着编号就能拉出原文、来源、日期,整条证据链完整。
我自己的生产库已经是SQLite版,数据库为唯一权威源,文件是抽查视图,一千五百多条断言带全文索引。但技能里的SQLite是可选项:先用三个JSONL文件把萃取习惯跑起来,等库超过三百条、检索开始靠翻文件拼的时候再开,不迟。而且这一步几乎无痛,JSONL本来就是一行一记录,导库就是搬运。
库建好了,技能装了,还差最后一件事:让流程在正确的时机喊技能出场。
交付物③:SEARCH-R Agent 升级补丁
按上一章的判据,这三句话是设置不是技能:它们不教萃取怎么干,只规定流程站位。具体就三句话,追加到Agent配置里。接在"课题档案管理"之后就行,没配过SEARCH-R的先回第二弹。
Survey开题之前,先跑知识萃取技能的检索协议。扫库,报告三类结论,可复用的、前提不同的、可能矛盾的,然后再定研究路线。
Harvest收割之后,自动跑知识萃取技能。萃取本轮成果,汇报各层统计和Insight候选清单,等你终审。每回大规模萃取之后,再反向查一遍:新入库的洞见,有没有影响更早课题的结论。
新旧结论冲突时,Agent报三个选项你来拍板:修订,旧条目不删,标注"已由某某修正";失效,标注原因;分家,各自补上适用边界。不许静默删除。
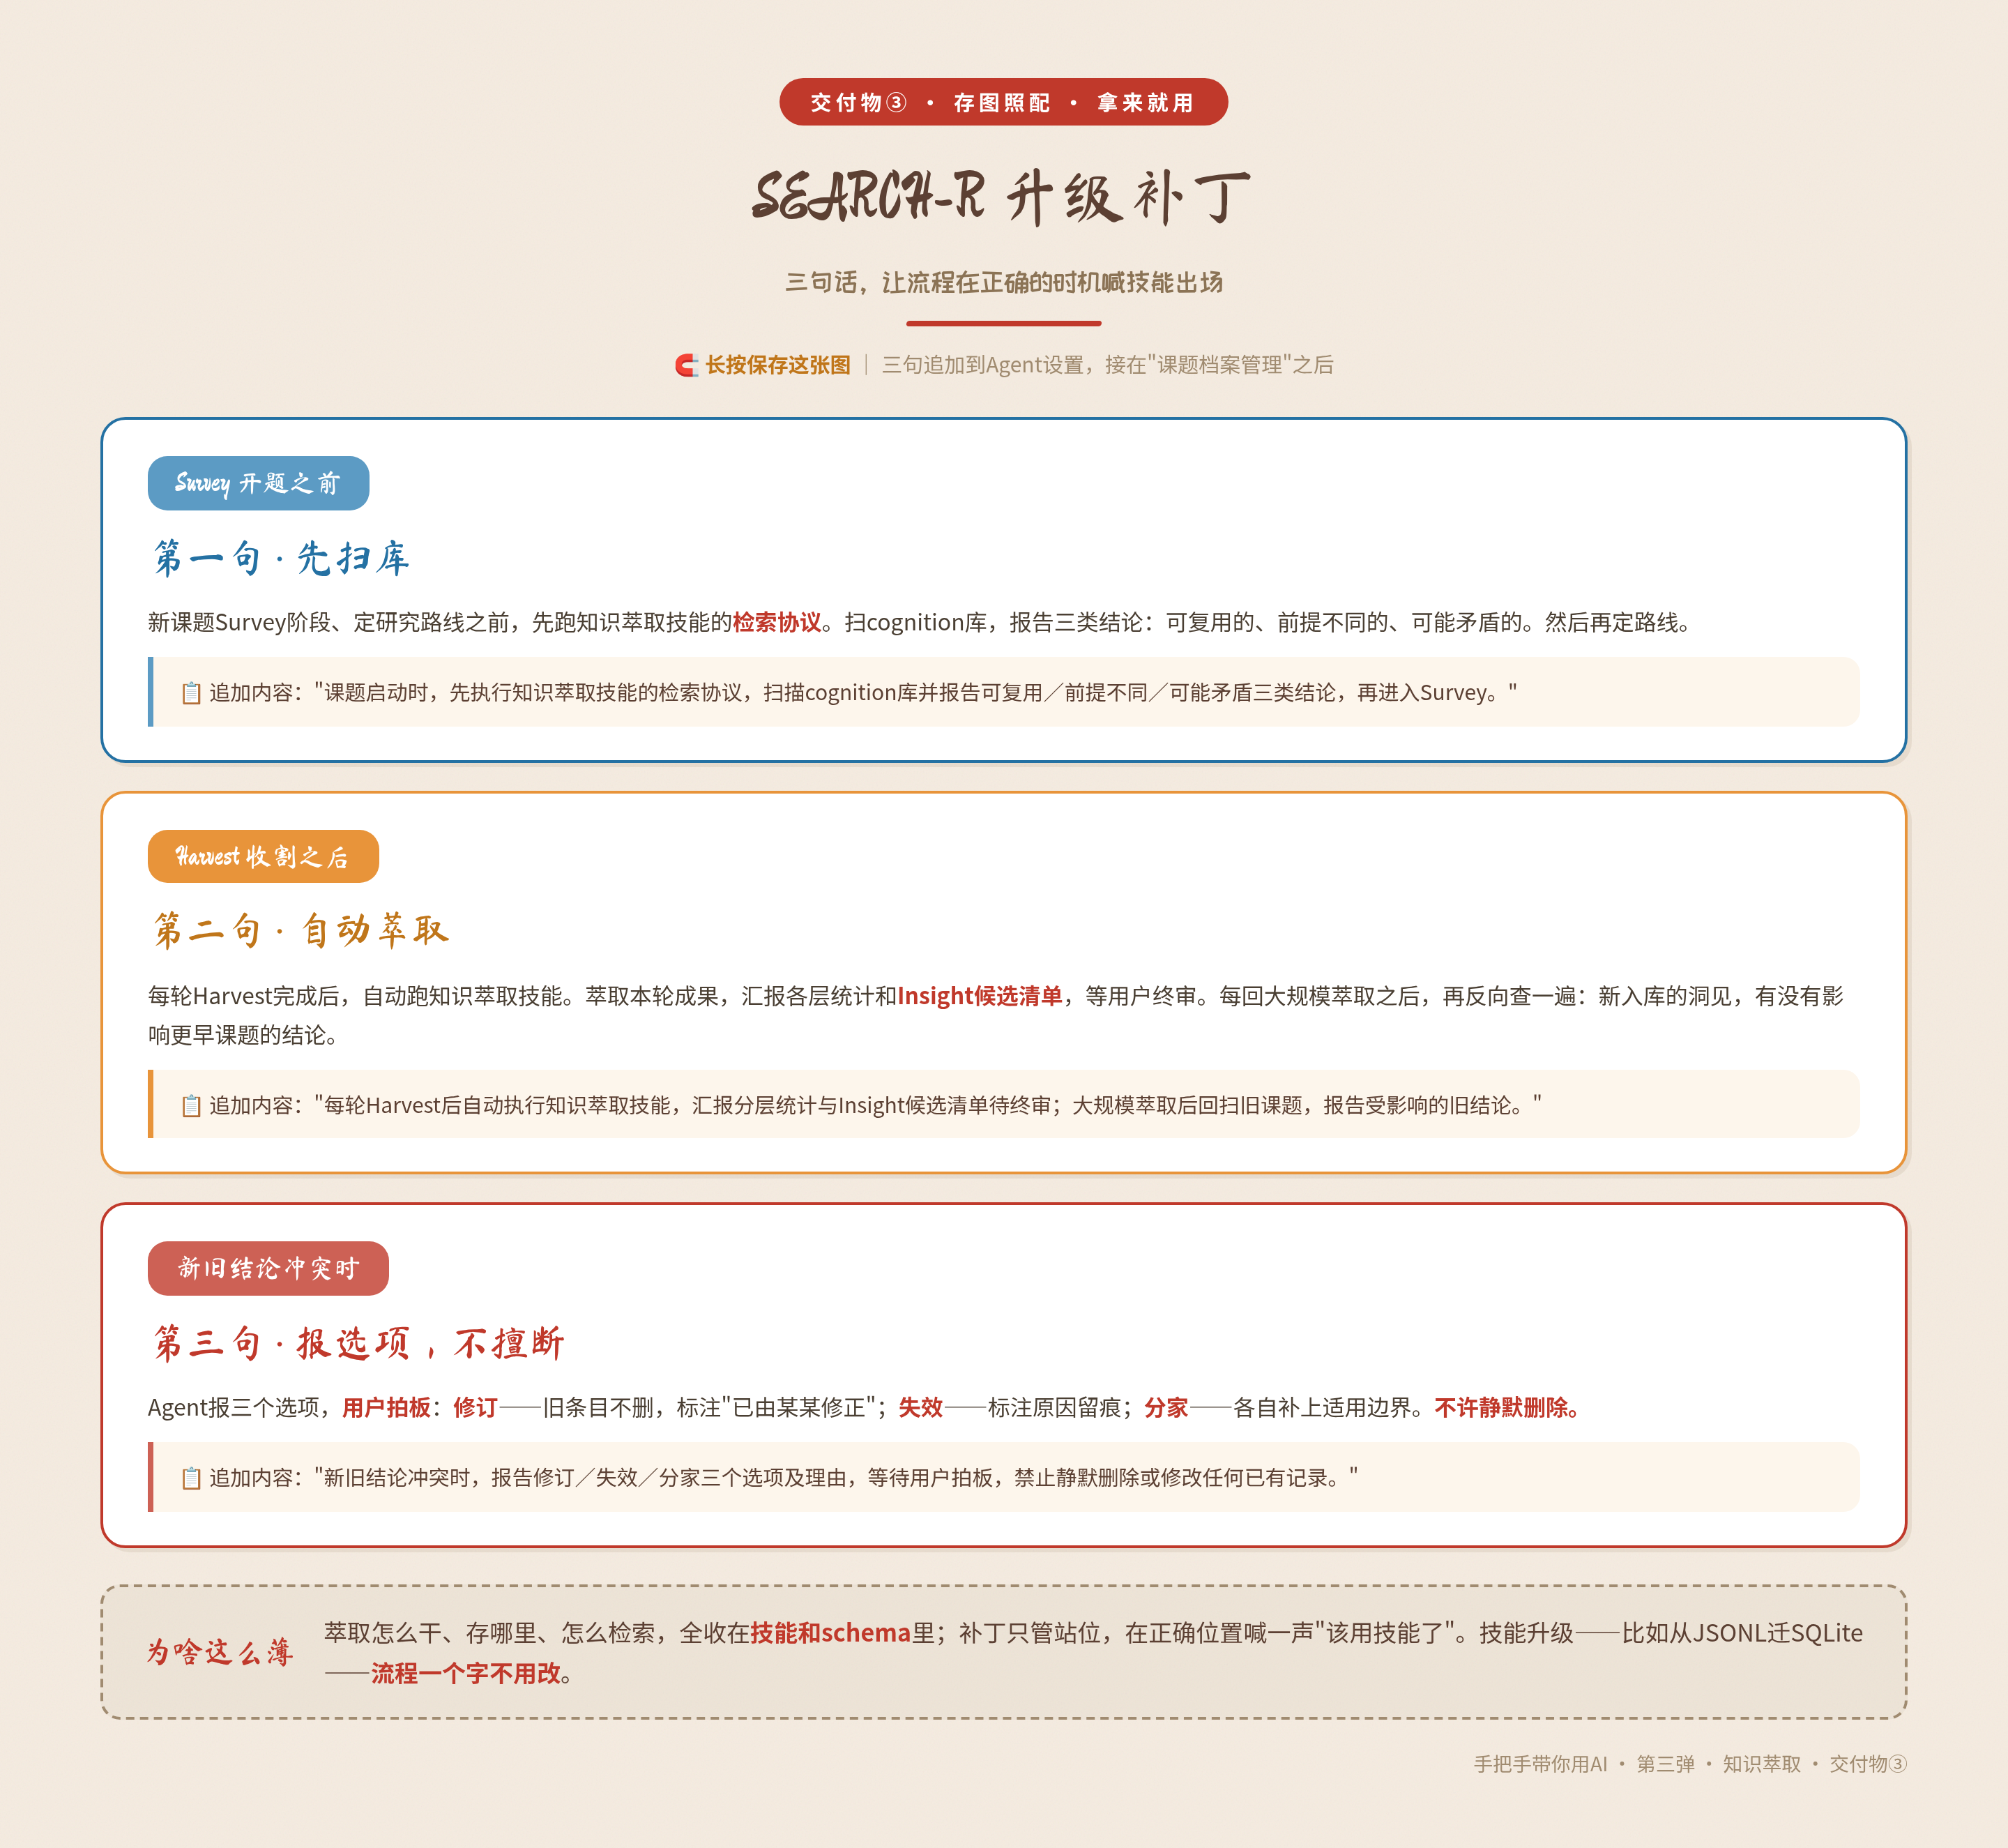
说明一句:这个补丁故意写得这么薄。萃取怎么做、存哪里、怎么检索,全收在技能和schema里;补丁只负责在SEARCH-R的正确位置喊一声"该用技能了"。技能和流程分开,往后技能升级,比如从JSONL文件迁到SQLite,流程一个字都不用改。
这套技能只管萃取和检索,不管关联扫描。洞见与洞见之间的连接、跨课题的网络,那是第四弹的事,到时候再加一个模块。
结尾
回到开头那两件事。
新课题从零起步。现在AI开题前先扫知识库,能复用的直接复用。触发复用的不再是你的记忆,是它的必查动作。敏感客户课题站在三重阈值链上开题,这就是它该有的样子。
隐隐觉得不对、要靠人肉回忆去查证。现在矛盾结论会被显式报告出来。你的直觉说"好像研究过",它就能真去查给你看;你还没起疑的时候,回扫自己就把矛盾摆到你面前。"无根"那条判断被修正,靠的就是这个机制,不是我记性好。
你的脑子从"索引"的岗位上退下来了。它只干最擅长的那件事:判断。
第二弹说过,研究的复利要靠循环往下钻。这一弹补上另一半:复利要入账。 找出来、存下来、用起来,三个动作转起来,每个课题炼出的洞见进了库,下一个课题才能站在它上面。不入账的复利不是复利,是流水。
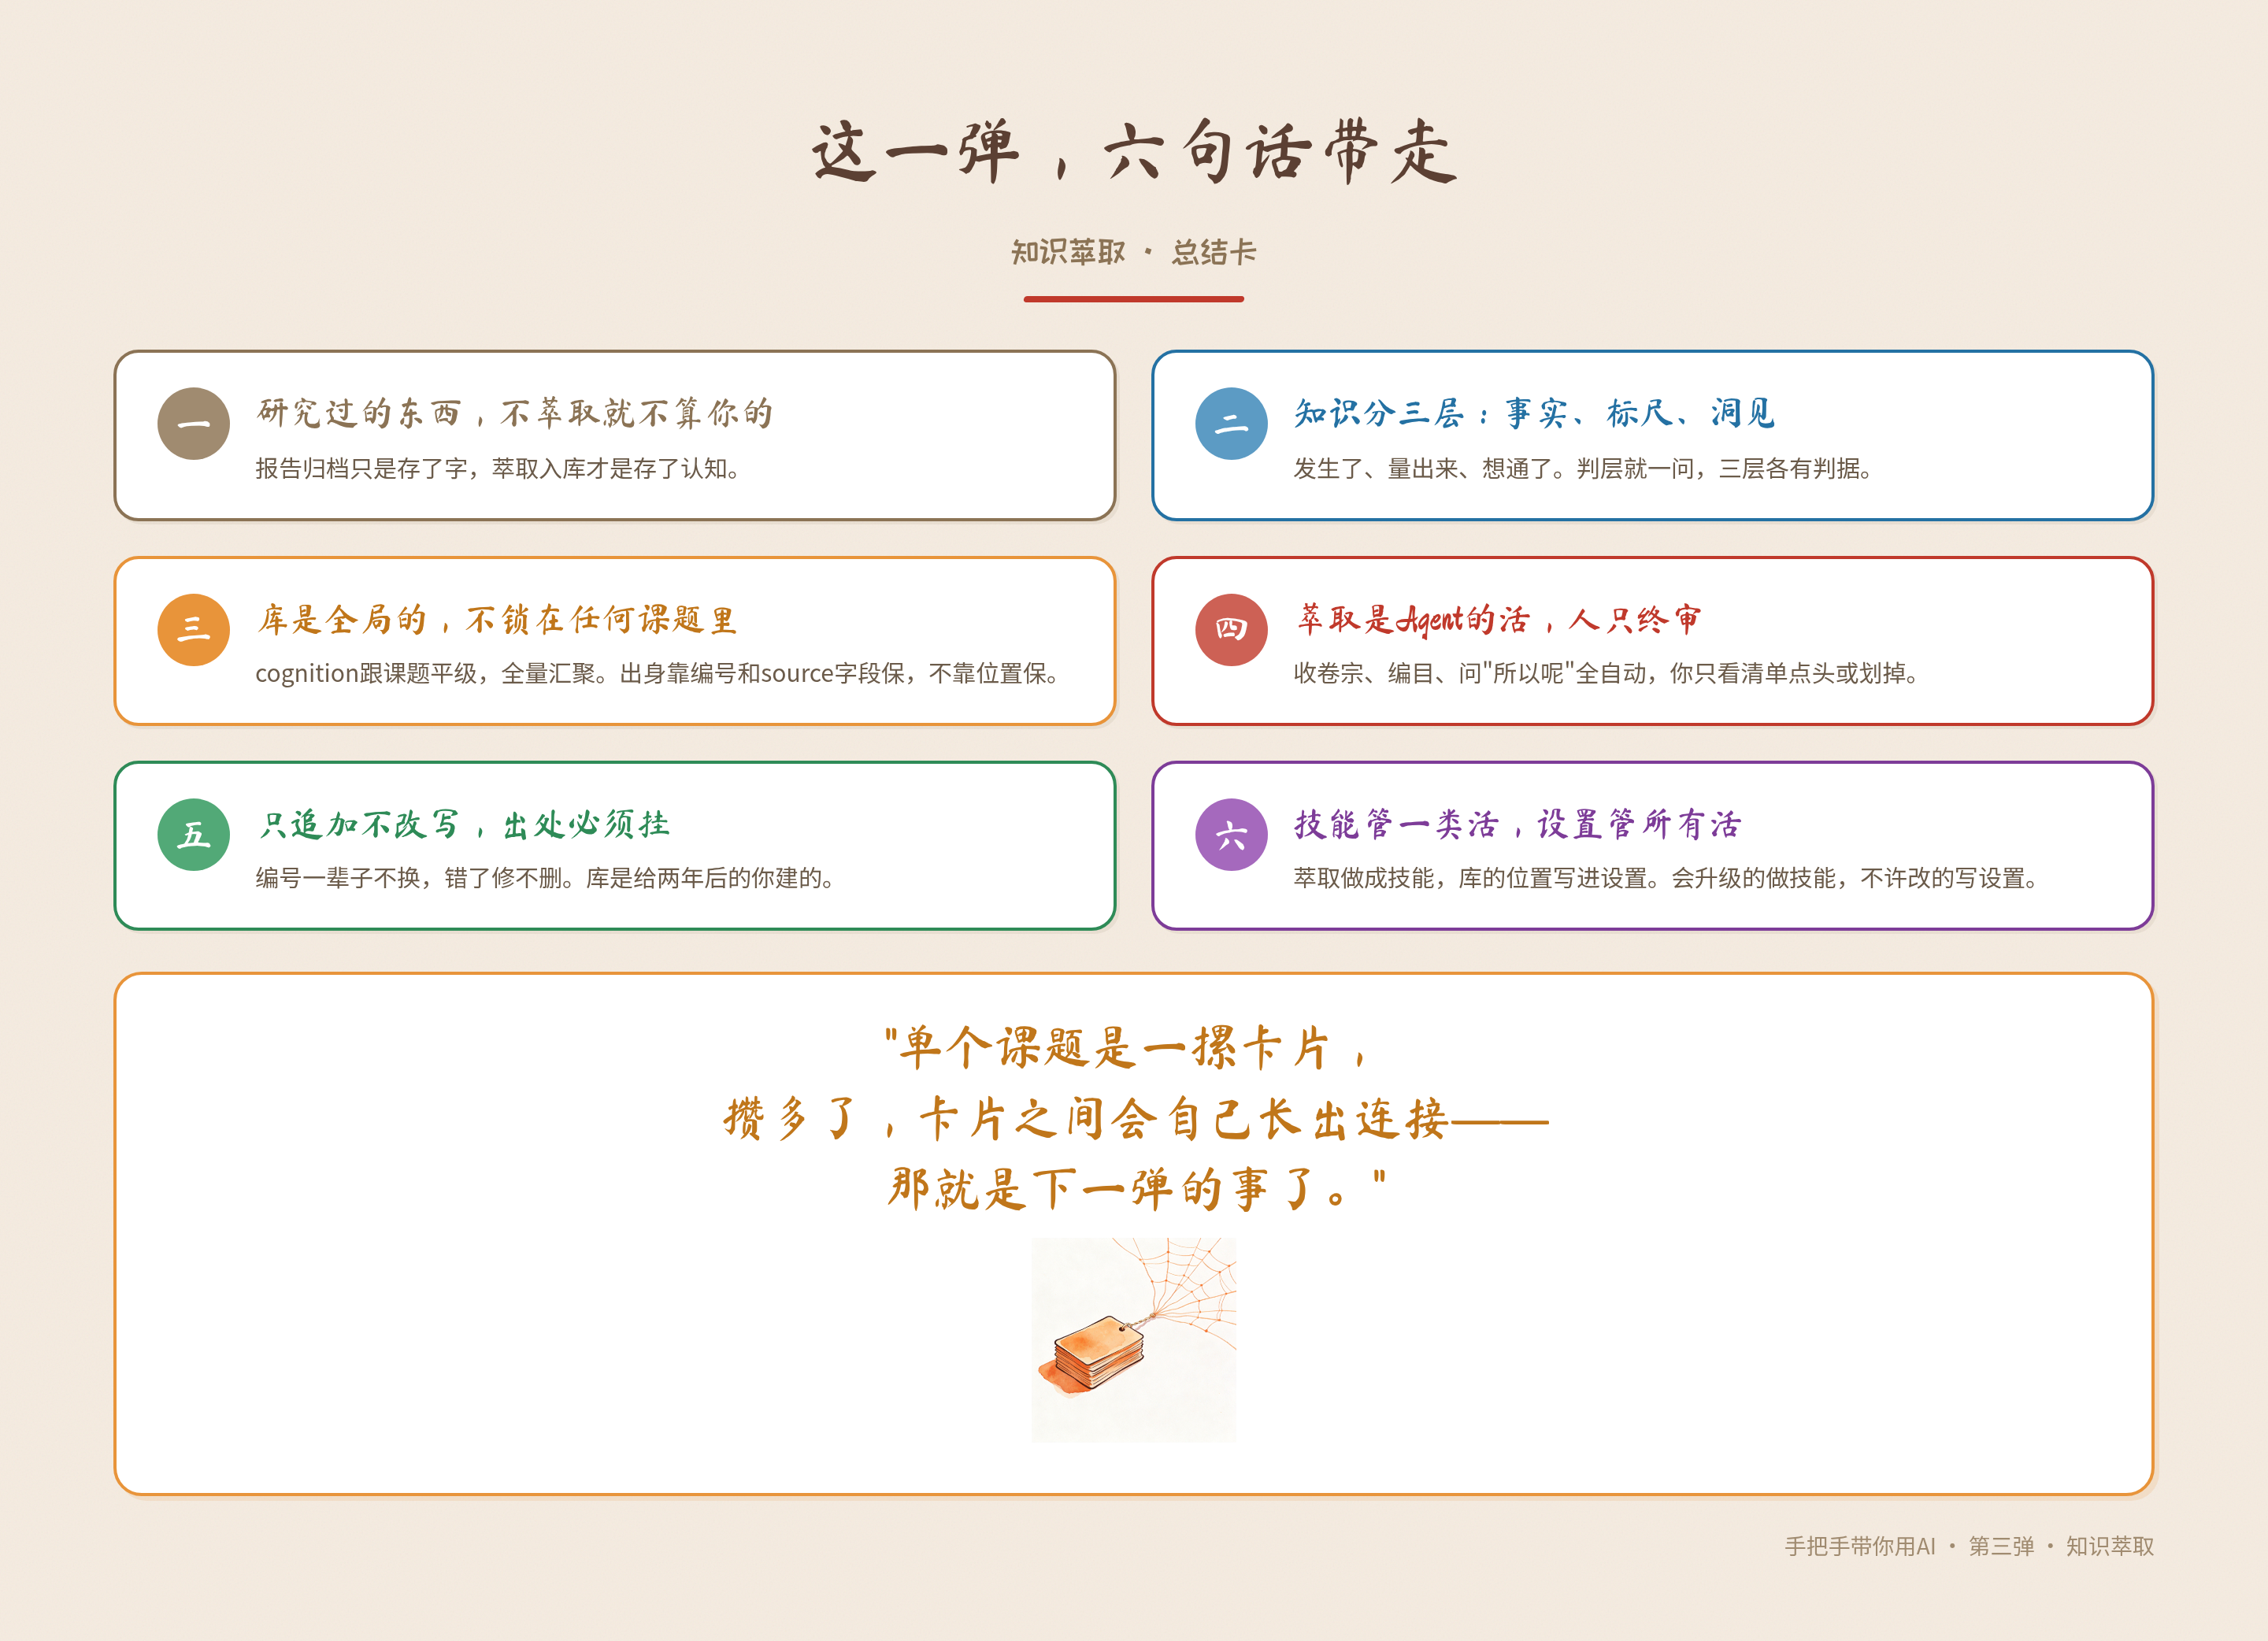
但走到这里,也只是把"断"接上了。每个课题的知识进了同一个库,能查,能追溯。你的知识库,现在是一摞整理好的卡片。
卡片攒多了,新问题会冒出来:这些卡片之间是什么关系?哪几张讲的是同一件事?哪几张连起来,能拼出一张你从没见过的图?
这已经不是"存"和"查"能回答的了。你要让洞见之间发生连接,支撑的、矛盾的、同构的,把一摞卡片织成一张网。
第四弹讲这个:知识关联图,洞见连成网,网里长出新知识。
如果这篇文章对你有用,点个"在看",或者转给一个正在做笔记却从没回看过的朋友。
你现在的笔记方式是什么?收藏夹吃灰型,还是软件囤积型?评论区聊聊。
进阶实战,在行动实验室
文章里的交付物做成了长图,存图照抄,能用。但我知道不少人想要的是更进一步的东西:完整可导入的智能体和技能。不用对着长图一行行抄,导入包直接拿走,装上就跑。
再往远一步,是构建你自己完整的业务智能体:从研究底座起步,问题澄清、需求梳理、原型落地,一圈一圈长成贴合你自己业务的模样。
这两件事,我每周都在知识星球「行动实验室」带着一批人实打实地做:智能体和技能的导入包直接拿,每一期的课题实操、踩坑复盘,都是跑过才写的。
想从"看懂了"走到"用起来了",欢迎进来一起练。