直接说结论。
长程任务能力的瓶颈,从来不是模型不够强,而是系统架构缺东西。
我在电力行业做了快两年的Agent落地,从调度智能体到供电服务智能体,从绍兴的大小模型联动项目到成都的武侯小智,经手的场景少说也有几十个。最深的感受就是,大家总在讨论换个更强的模型会不会好一点,但真正拉开差距的,从来不是模型参数多少,而是你在模型外面搭了什么。
先给个硬数据。我们做过ProOPF-B测试,让最强的通用大模型直接做电力最优潮流计算建模,准确率不到30%,最高难度等级直接是零分。最可怕的不是准确率低,而是错误的形态。GPT-5写出来的方案,语言流畅、术语准确、步骤清晰,你一眼看过去觉得很专业,但关键参数是错的。这种错比实习生写错还危险,因为实习生写错了你能看出来,大模型写错了你看不出来。
为什么会这样?因为垂直行业的真正关键知识是"暗知识",不在互联网上,在运行规程里,在调度员脑子里,在供电所档案里。你把模型从1300亿参数升到1万亿参数,它还是不会。就像一个再聪明的文科生,不给他公式和例题,他做不出物理题。
这就是单靠模型的根本问题。长程任务是很多步推理串联起来的,每一步都可能引入一点点偏差,十步之后偏差就放大到不可收拾。更要命的是暗知识效应,模型不知道自己缺什么,它会用流畅的语言把缺口补上,形成隐蔽的错误。短任务还能靠通识能力蒙混过关,长任务就像走夜路,走得越远越容易掉坑里。
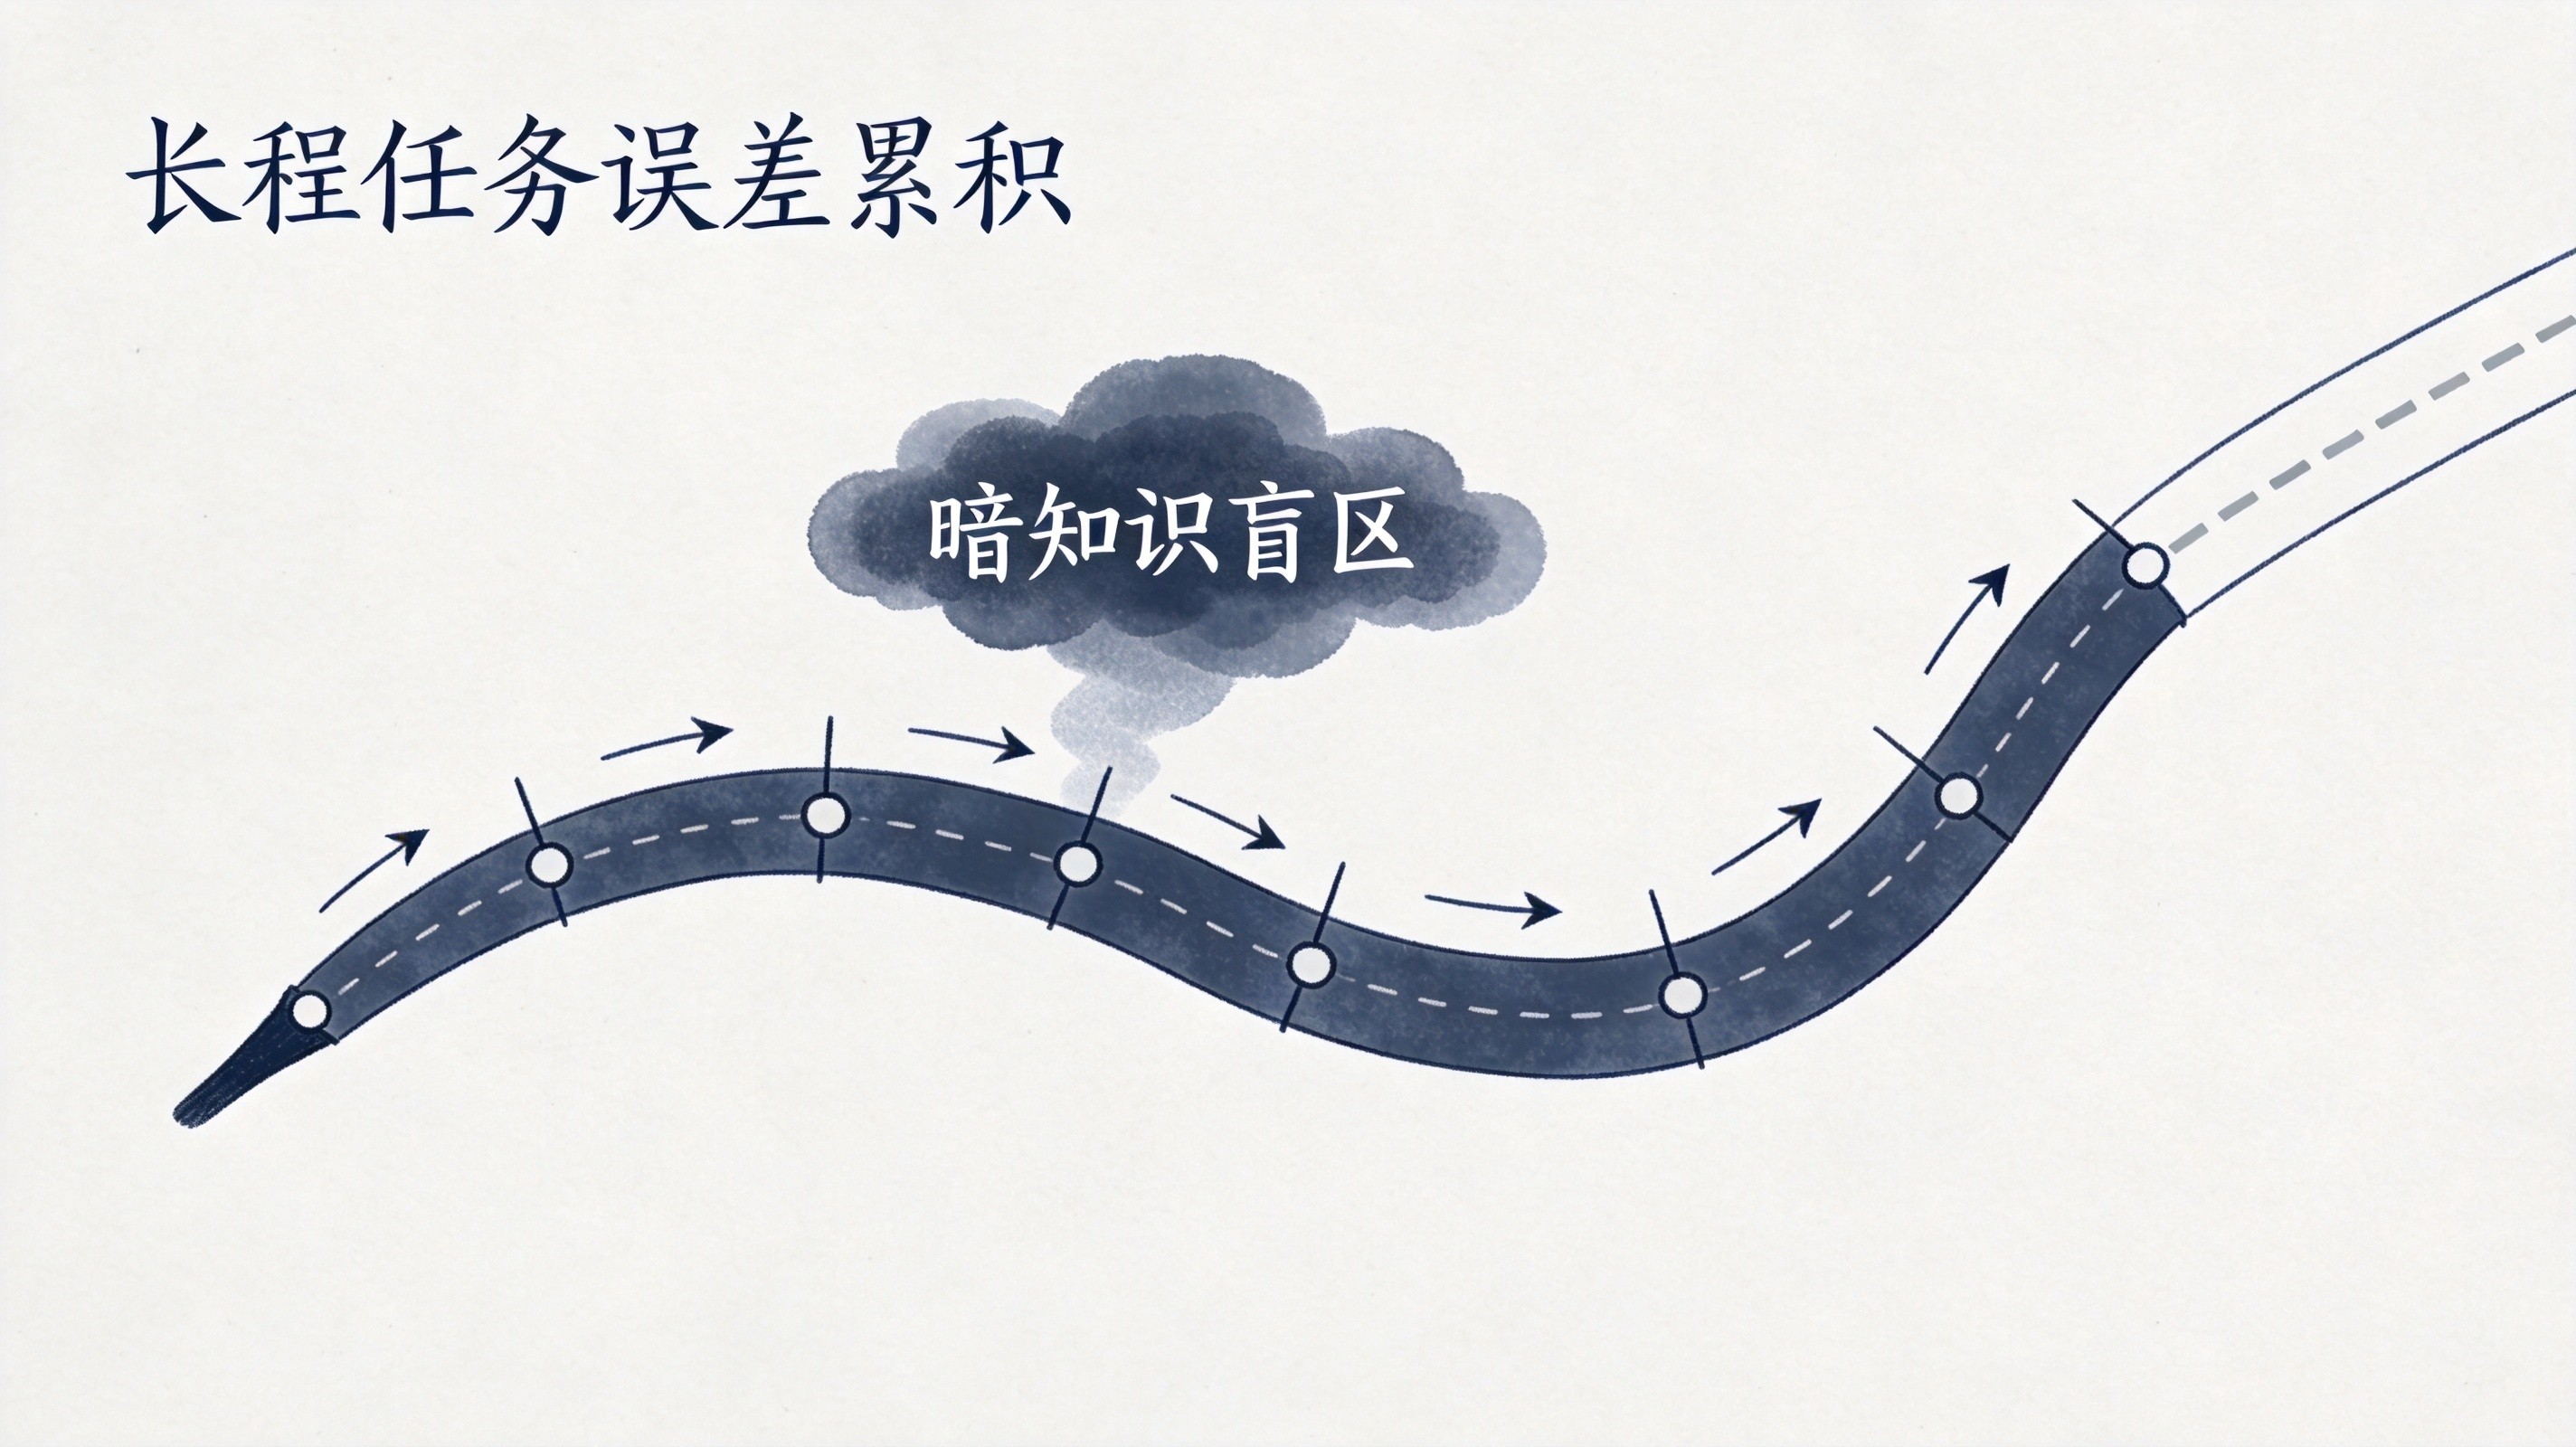
那怎么办?靠记忆系统。但我说的记忆不是把对话历史存下来这么简单。很多人一说Agent记忆就是vector database加RAG,搜点上下文塞给模型。这玩意儿只能解决记不住的问题,解决不了不知道自己不知道的问题。
真正的长程记忆底座,是结构化知识作为外部参照系。
我们做本体智能研究的时候发现一个现象,叫"逆参数知识效应"。本体约束的价值,跟大模型训练数据的覆盖度成反比。LLM越不擅长的领域,结构化知识的增益越大。电力行业训练数据极度稀缺,本体约束就是最大的价值放大器。
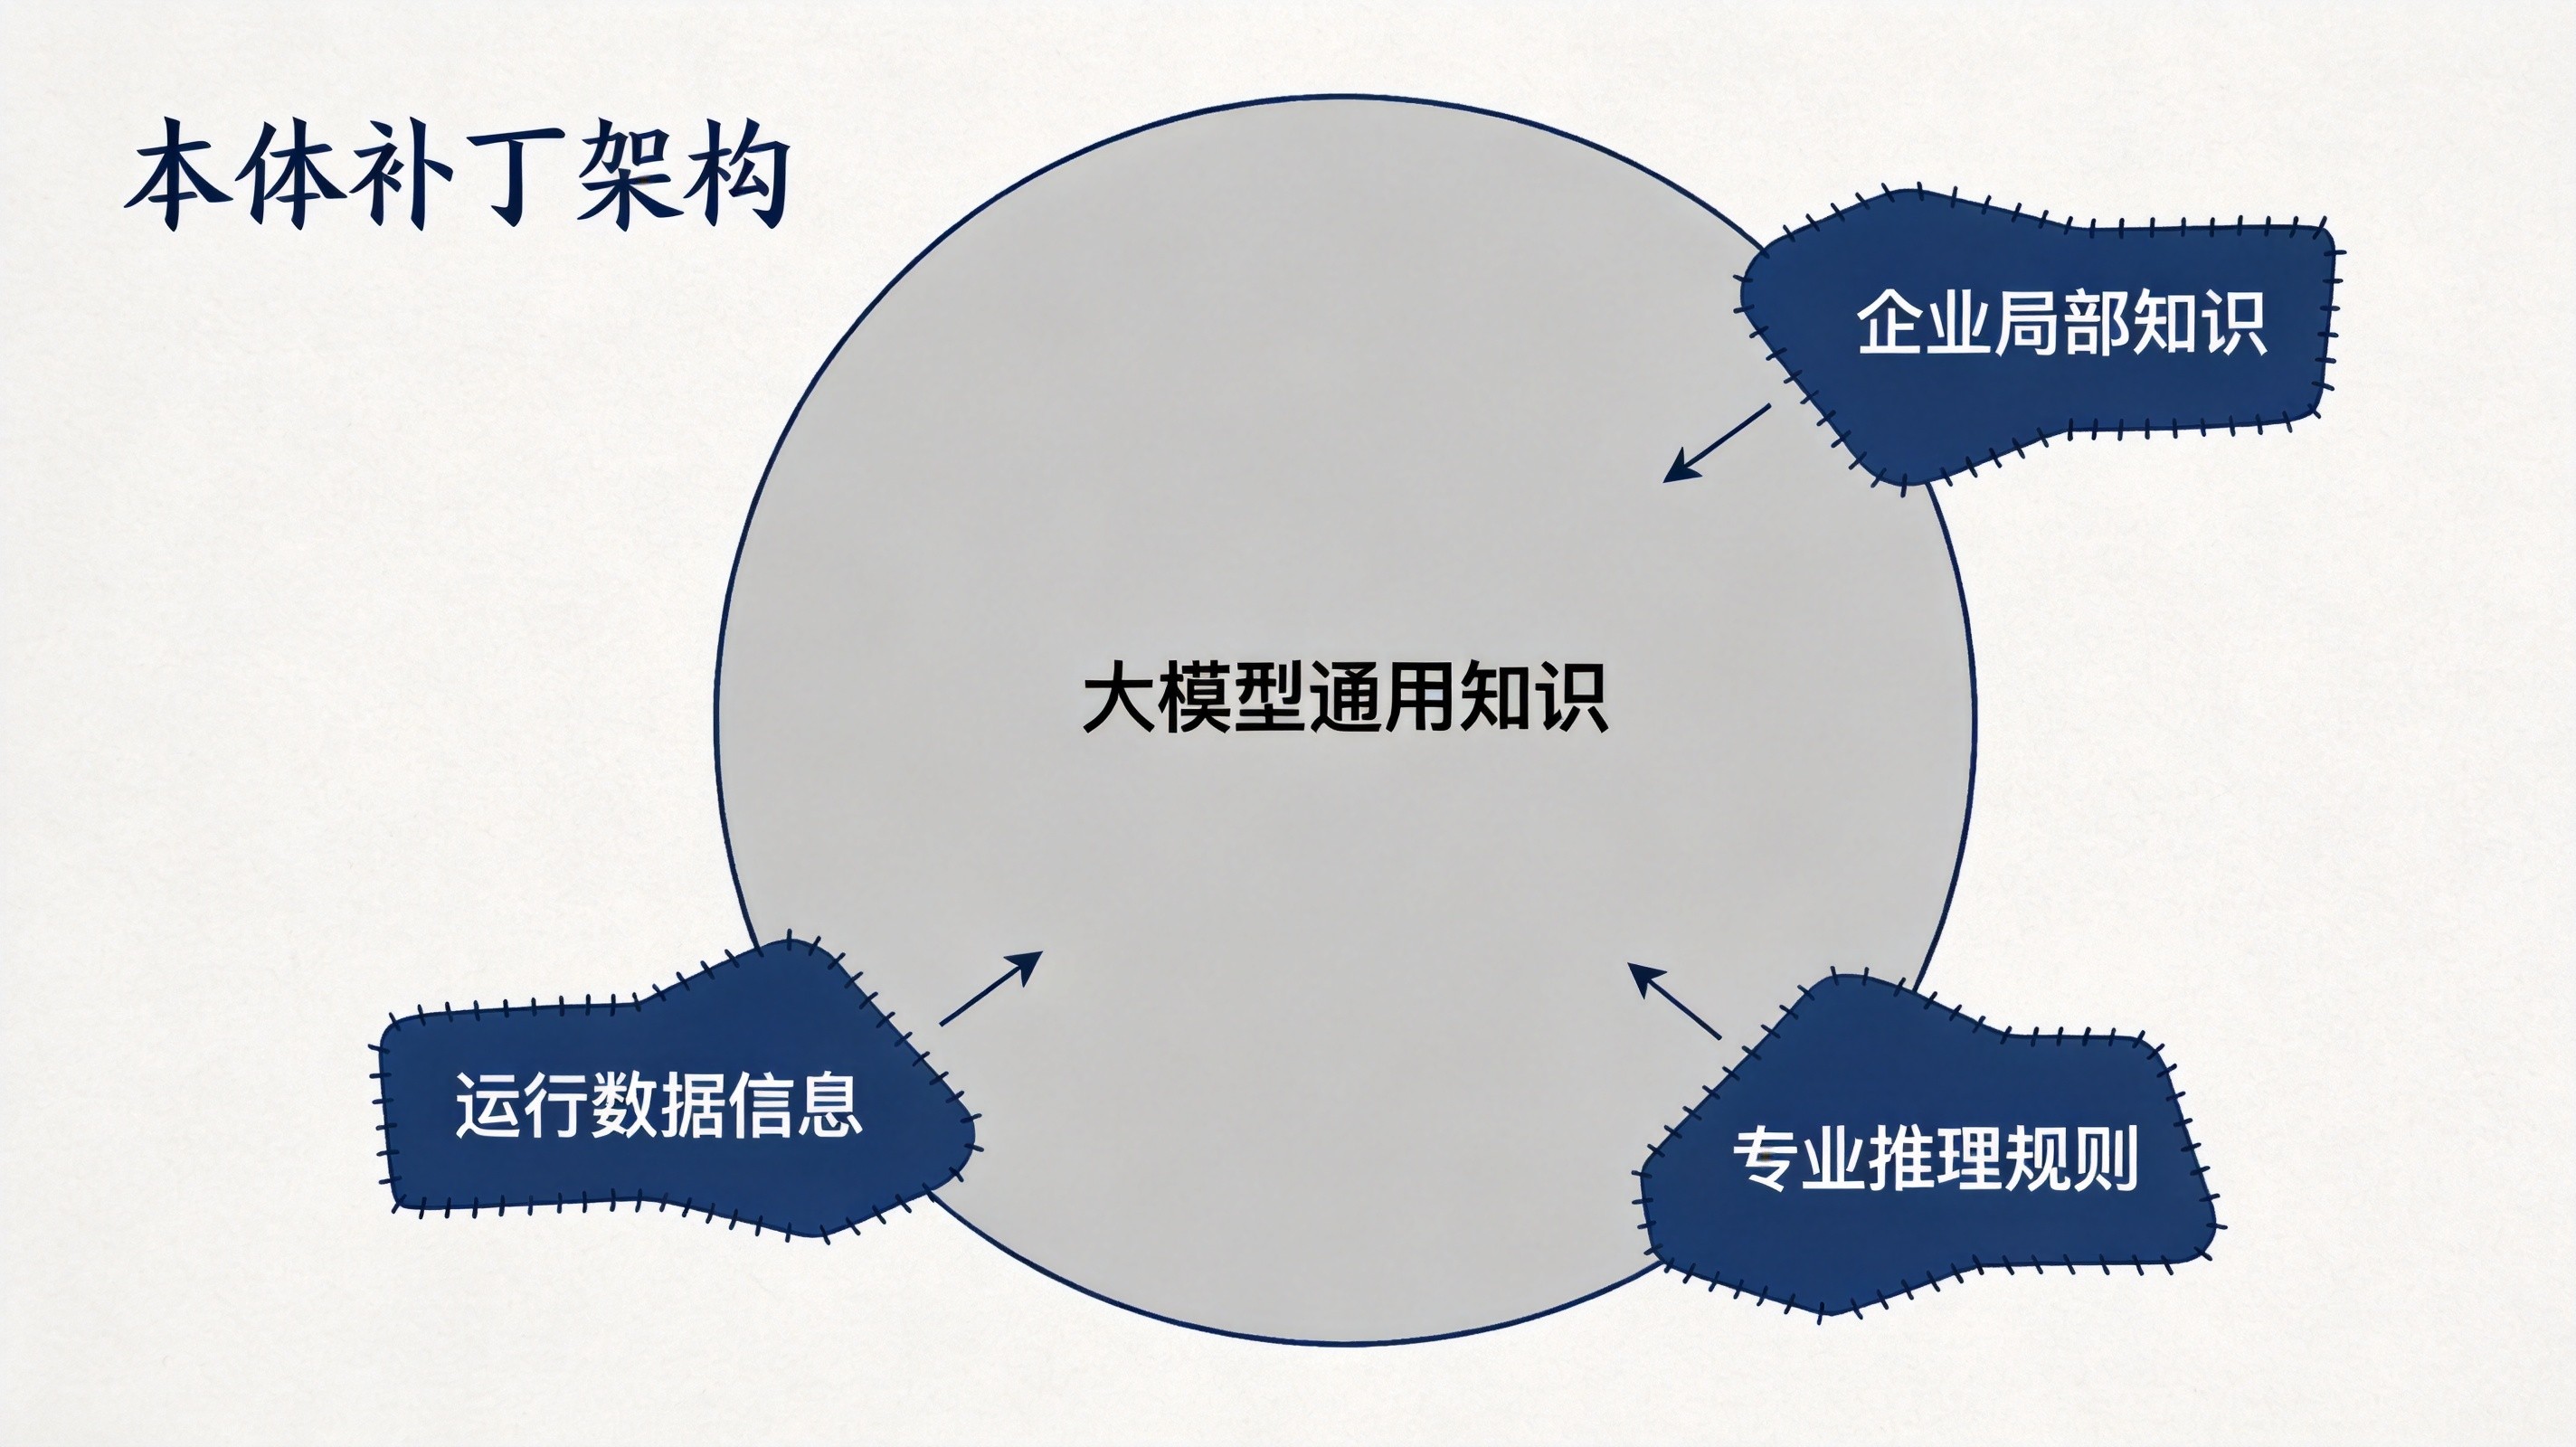
这里有个核心的方法论转变。以前大家觉得本体是围栏,把模型圈在里面。我们现在的理解完全反过来了,模型知识是主力,本体是补丁。你不需要把所有知识都塞进本体里,只需要覆盖三类关键内容,企业内部局部知识、实际运行的数据信息、行业特殊的专业推理和阈值。其他的,模型自己够用。
这就像一个有经验的工程师,大部分问题他自己能搞定,但手边随时放着一本规程手册,遇到拿不准的就翻一下。长程任务的连续性,本质上不是记住了多少对话,而是每一步推理有没有一个稳定的外部参照系来校准偏差。
光有参照系还不够,单条路径走下去还是会偏。
我们在做认识论边界智能体研究的时候,提出了EBA方法论,核心就八个字,大胆试错,小心归结论。
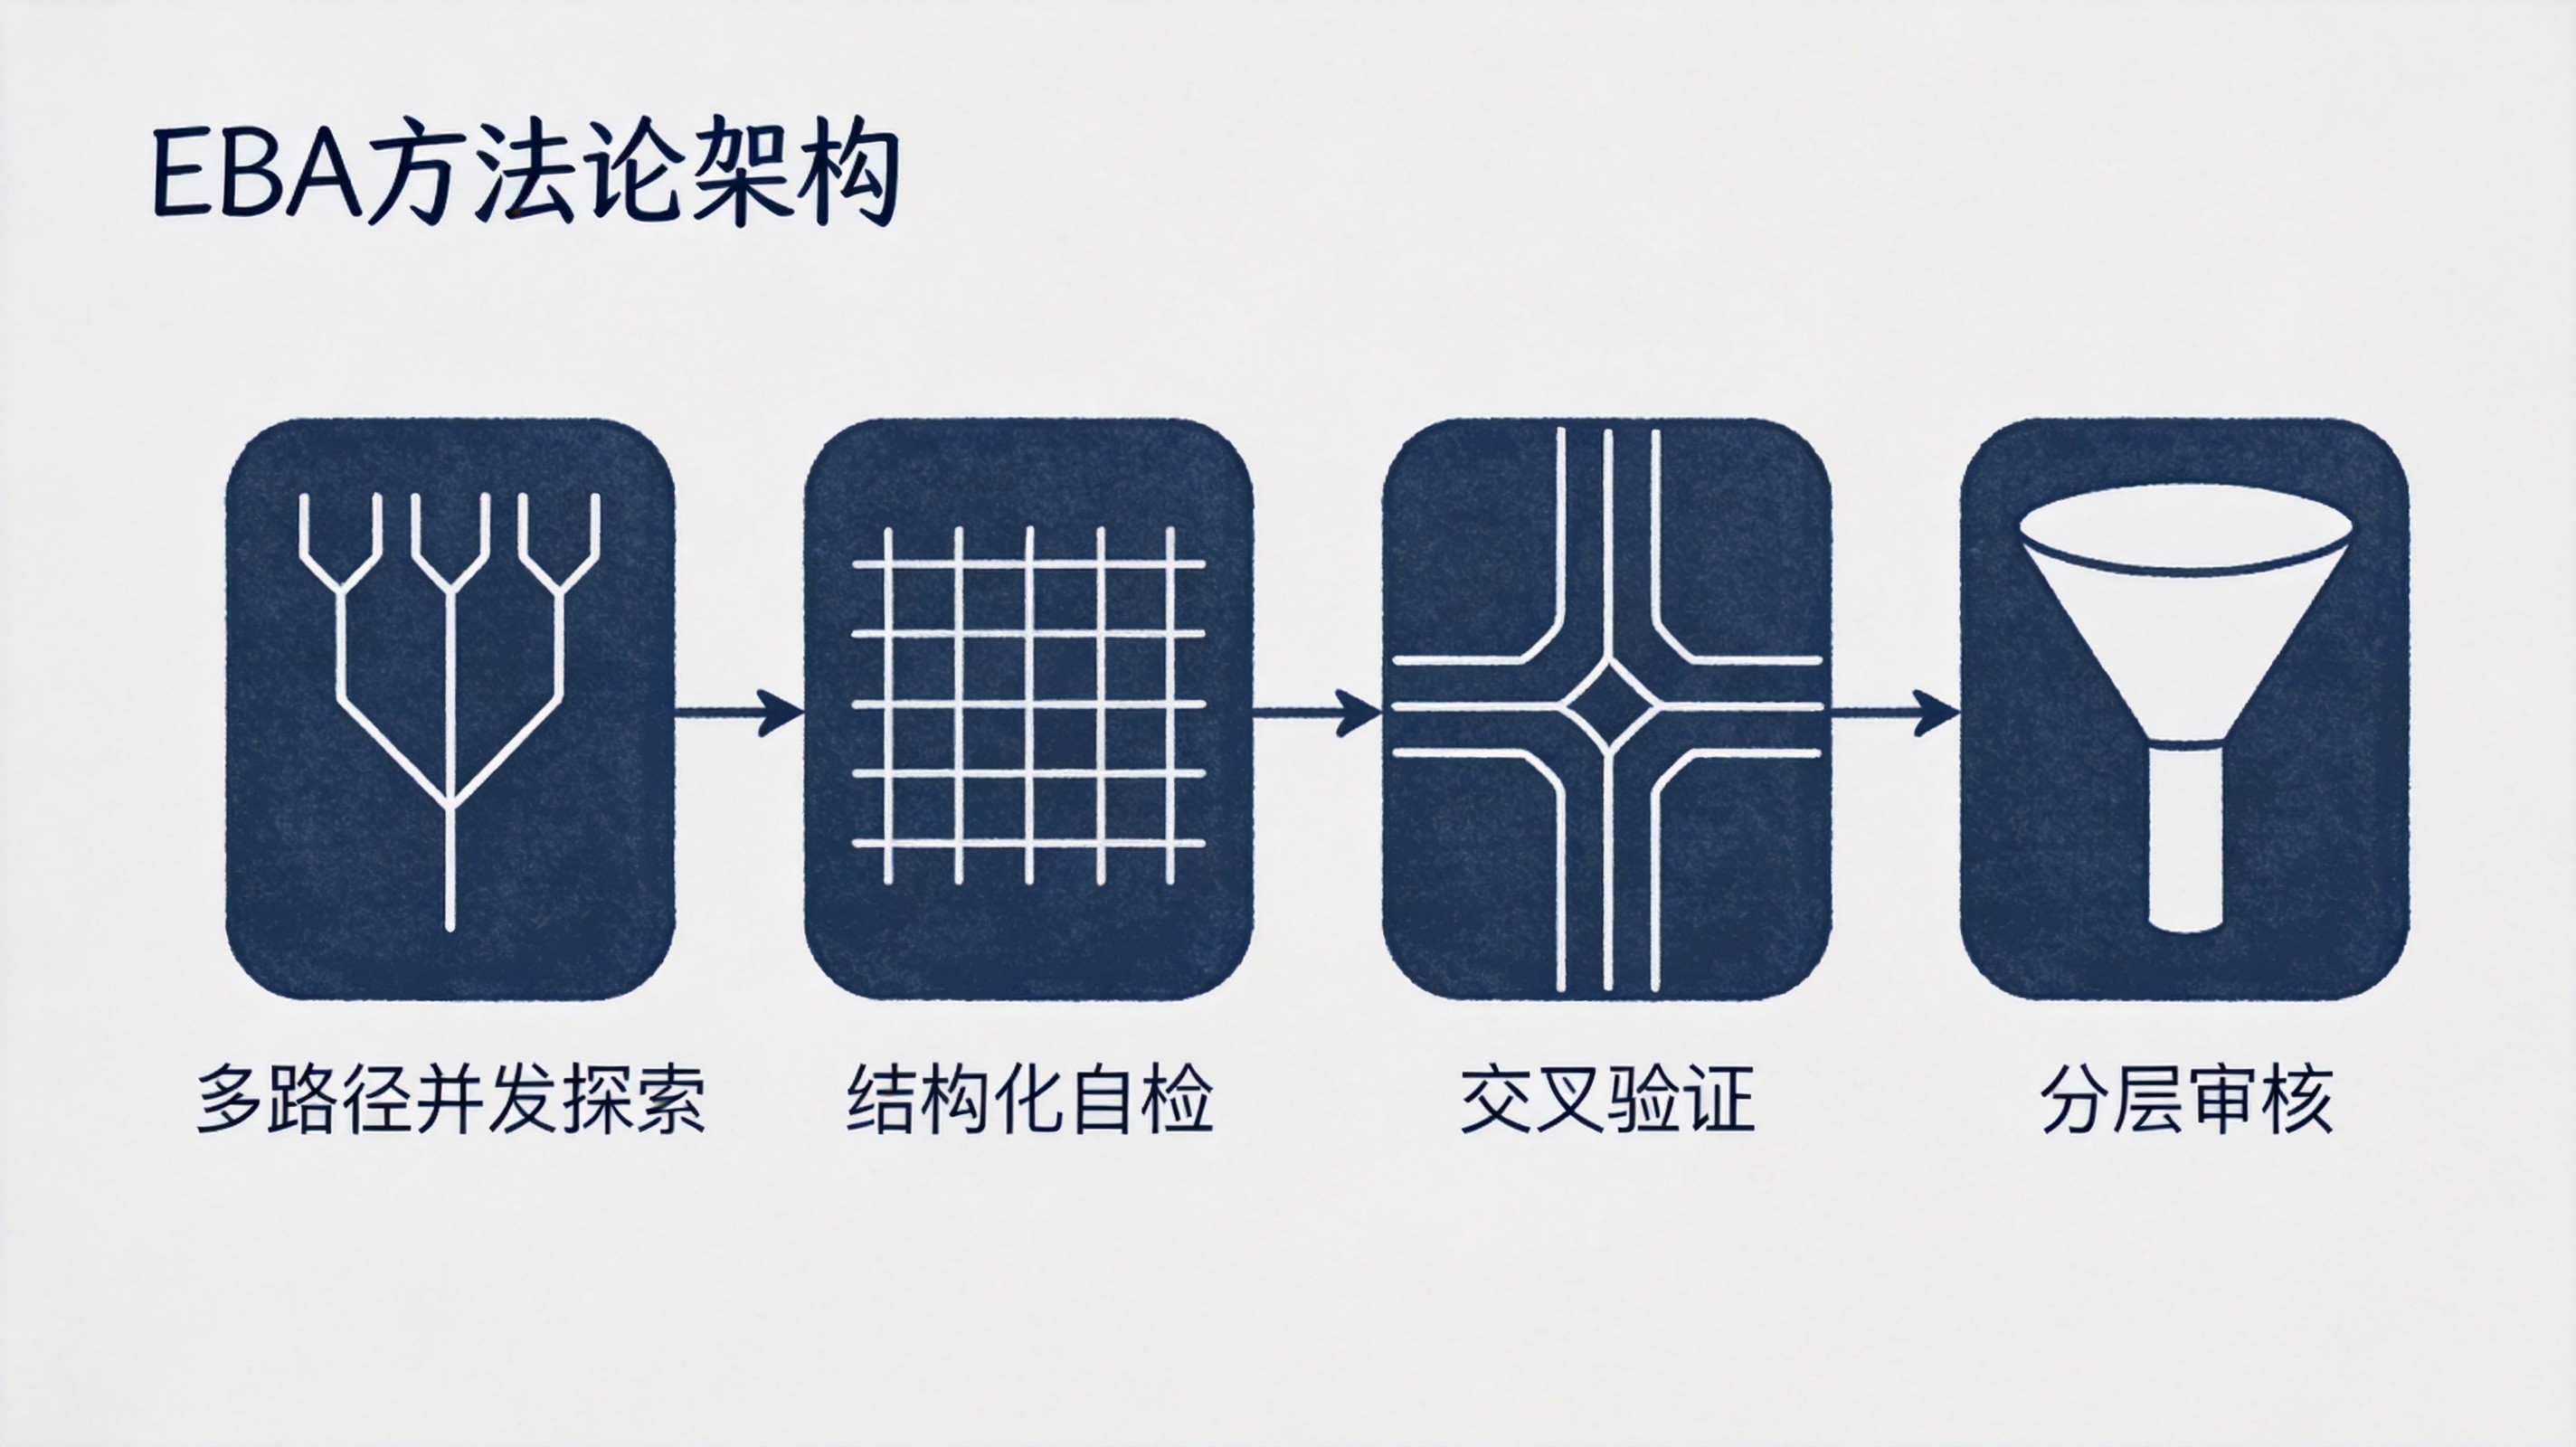
不要求模型单路径收敛到正确答案,而是允许多路径并发探索。在关键决策分叉点生成两三条候选路径,每条独立推理,不提前剪枝。然后全链路依据标注,每一步的依据和结论都标清楚,人可以倒推。证据来源可审计,所有证据的来源链都能追溯。
每条路径的可信度怎么判断?不是让模型自评,那玩意儿不靠谱。RLHF训练会引入ownership bias,模型对自己答案的置信度会系统性偏高26%。DeepMind2023年的研究就证明了,没有外部锚点反馈的自我纠正反而会降低性能。
所以要用本体图来做外部参照系。把每条推理路径投影到本体结构上,覆盖度越高可信度越高。百分之百覆盖的,高可信度。百分之六十覆盖的,中等可信度。只有百分之二十覆盖的,低可信度,大概率是模型在凭参数知识瞎猜。
多条路径之间还能交叉验证。如果三条独立的路径最后都走到了同一个结论,哪怕其中两条越界了,这个结论的可信度也会被提升。这就是冗余的价值。
多路径探索会不会很费token?会,但这笔账要算清楚。高价值场景里,多花三五倍token成本,跟走错路重做的时间成本比不值一提。而且我们做了分级标注策略,大部分在本体边界内的推理步骤几乎零额外开销,整体开销大概是单路径的两到四倍。
最后一步,也是最容易被忽略的一步,外部反馈机制。
我见过太多团队做Agent,搞完自评就上线了,结果一塌糊涂。模型自评不可靠这个事儿,刚才已经说了。那靠什么?靠双轨运行,靠人类终裁。
我们做AI供电服务员的时候,总结了三个落地原则,复用优先、数据中转、双轨运行。双轨运行是什么意思?就是AI先跑着,但所有决策都要经过人这一关。人不是全程介入,那样效率太低了,而是分层审核。
全路径在本体边界内、多条路径结论一致的,自动通过。部分越界但结论一致的,AI生成审核报告,人扫一眼就行。越界比较多、路径之间还有分歧的,这才提交人类来决策。实际跑下来,真正需要人介入的只有百分之十到二十。
每一次人类裁决,都应该被记录下来,结构化成存疑登记簿。分歧来自哪里,怎么裁决的,裁决之后要不要更新本体。每一次人工审核都在教系统边界在哪里。本体覆盖度持续提升,需要人介入的比例持续下降,这才是正反馈循环。
说到这儿其实答案已经很清楚了。
长程任务靠的不是更强的模型,而是更好的系统架构。模型是发动机,系统架构是整车。发动机再强,没有悬挂、没有刹车、没有导航,你开不了长途。开得越快越容易出事。
记忆系统是底盘,提供长程连续性的基础支撑。结构化知识是导航,告诉你什么地方有路什么地方是坑。多路径探索是冗余悬挂,一条路走不通还有别的路。证据审计是行车记录仪,出了问题能回溯。外部反馈机制是驾驶员,关键路口总得有人把方向。
这几样东西加起来,才是一辆能跑长途的车。
现在大家都在卷模型参数、卷benchmark分数,就像比赛谁的发动机排量大。但真正跑过长途的人都知道,发动机只是整车的一部分。长程任务拼的不是百米加速,是整车工程能力。什么时候行业的注意力从发动机转移到整车上了,AI Agent的长程任务能力才会真正上台阶。
如果你对AI Agent的系统架构和垂直行业落地感兴趣,欢迎关注我的公众号 & 知识星球 [SG AI实验室],我会定期分享一线落地经验和方法论思考。