单位想做个AI Agent项目,要支撑万级用户的「生产级」AI Agent,到底是怎样的?
做过两个生产级AI项目,一个服务侧一个调度侧,踩了不少POC到生产之间的坑。最大的感受是,POC级Agent和生产级Agent,根本不是同一种东西。 POC验证的是"能不能做",生产级要回答的是"能不能稳定地、安全地、低成本地给一万人用"。
这两个问题的难度差了至少一个量级。很多团队POC跑得很漂亮,一上生产就崩,根本原因就是用POC的思路做生产堆大模型、拼prompt、叠工具调用。这些东西在Demo级好用,到了万级用户量、每天几万次调用的场景下,全是坑。
生产级Agent跟POC比,至少有五个本质差异。
一、纯大模型方案有天花板,必须有结构化知识做乘法
POC阶段你可能觉得大模型很厉害,什么问题都能回答。但一上生产你就会发现,大模型在垂直领域的准确率有一道看不见的天花板大概70%到80%,再往上怎么走都走不动。
这不是prompt写得不够好,也不是模型不够大。这是"暗知识"问题领域里大量关键知识不在公开文本里,在内部规范、操作手册、老师傅的经验、各种不成文的约定里。大模型的训练数据里没有这些东西,它再大也没用。
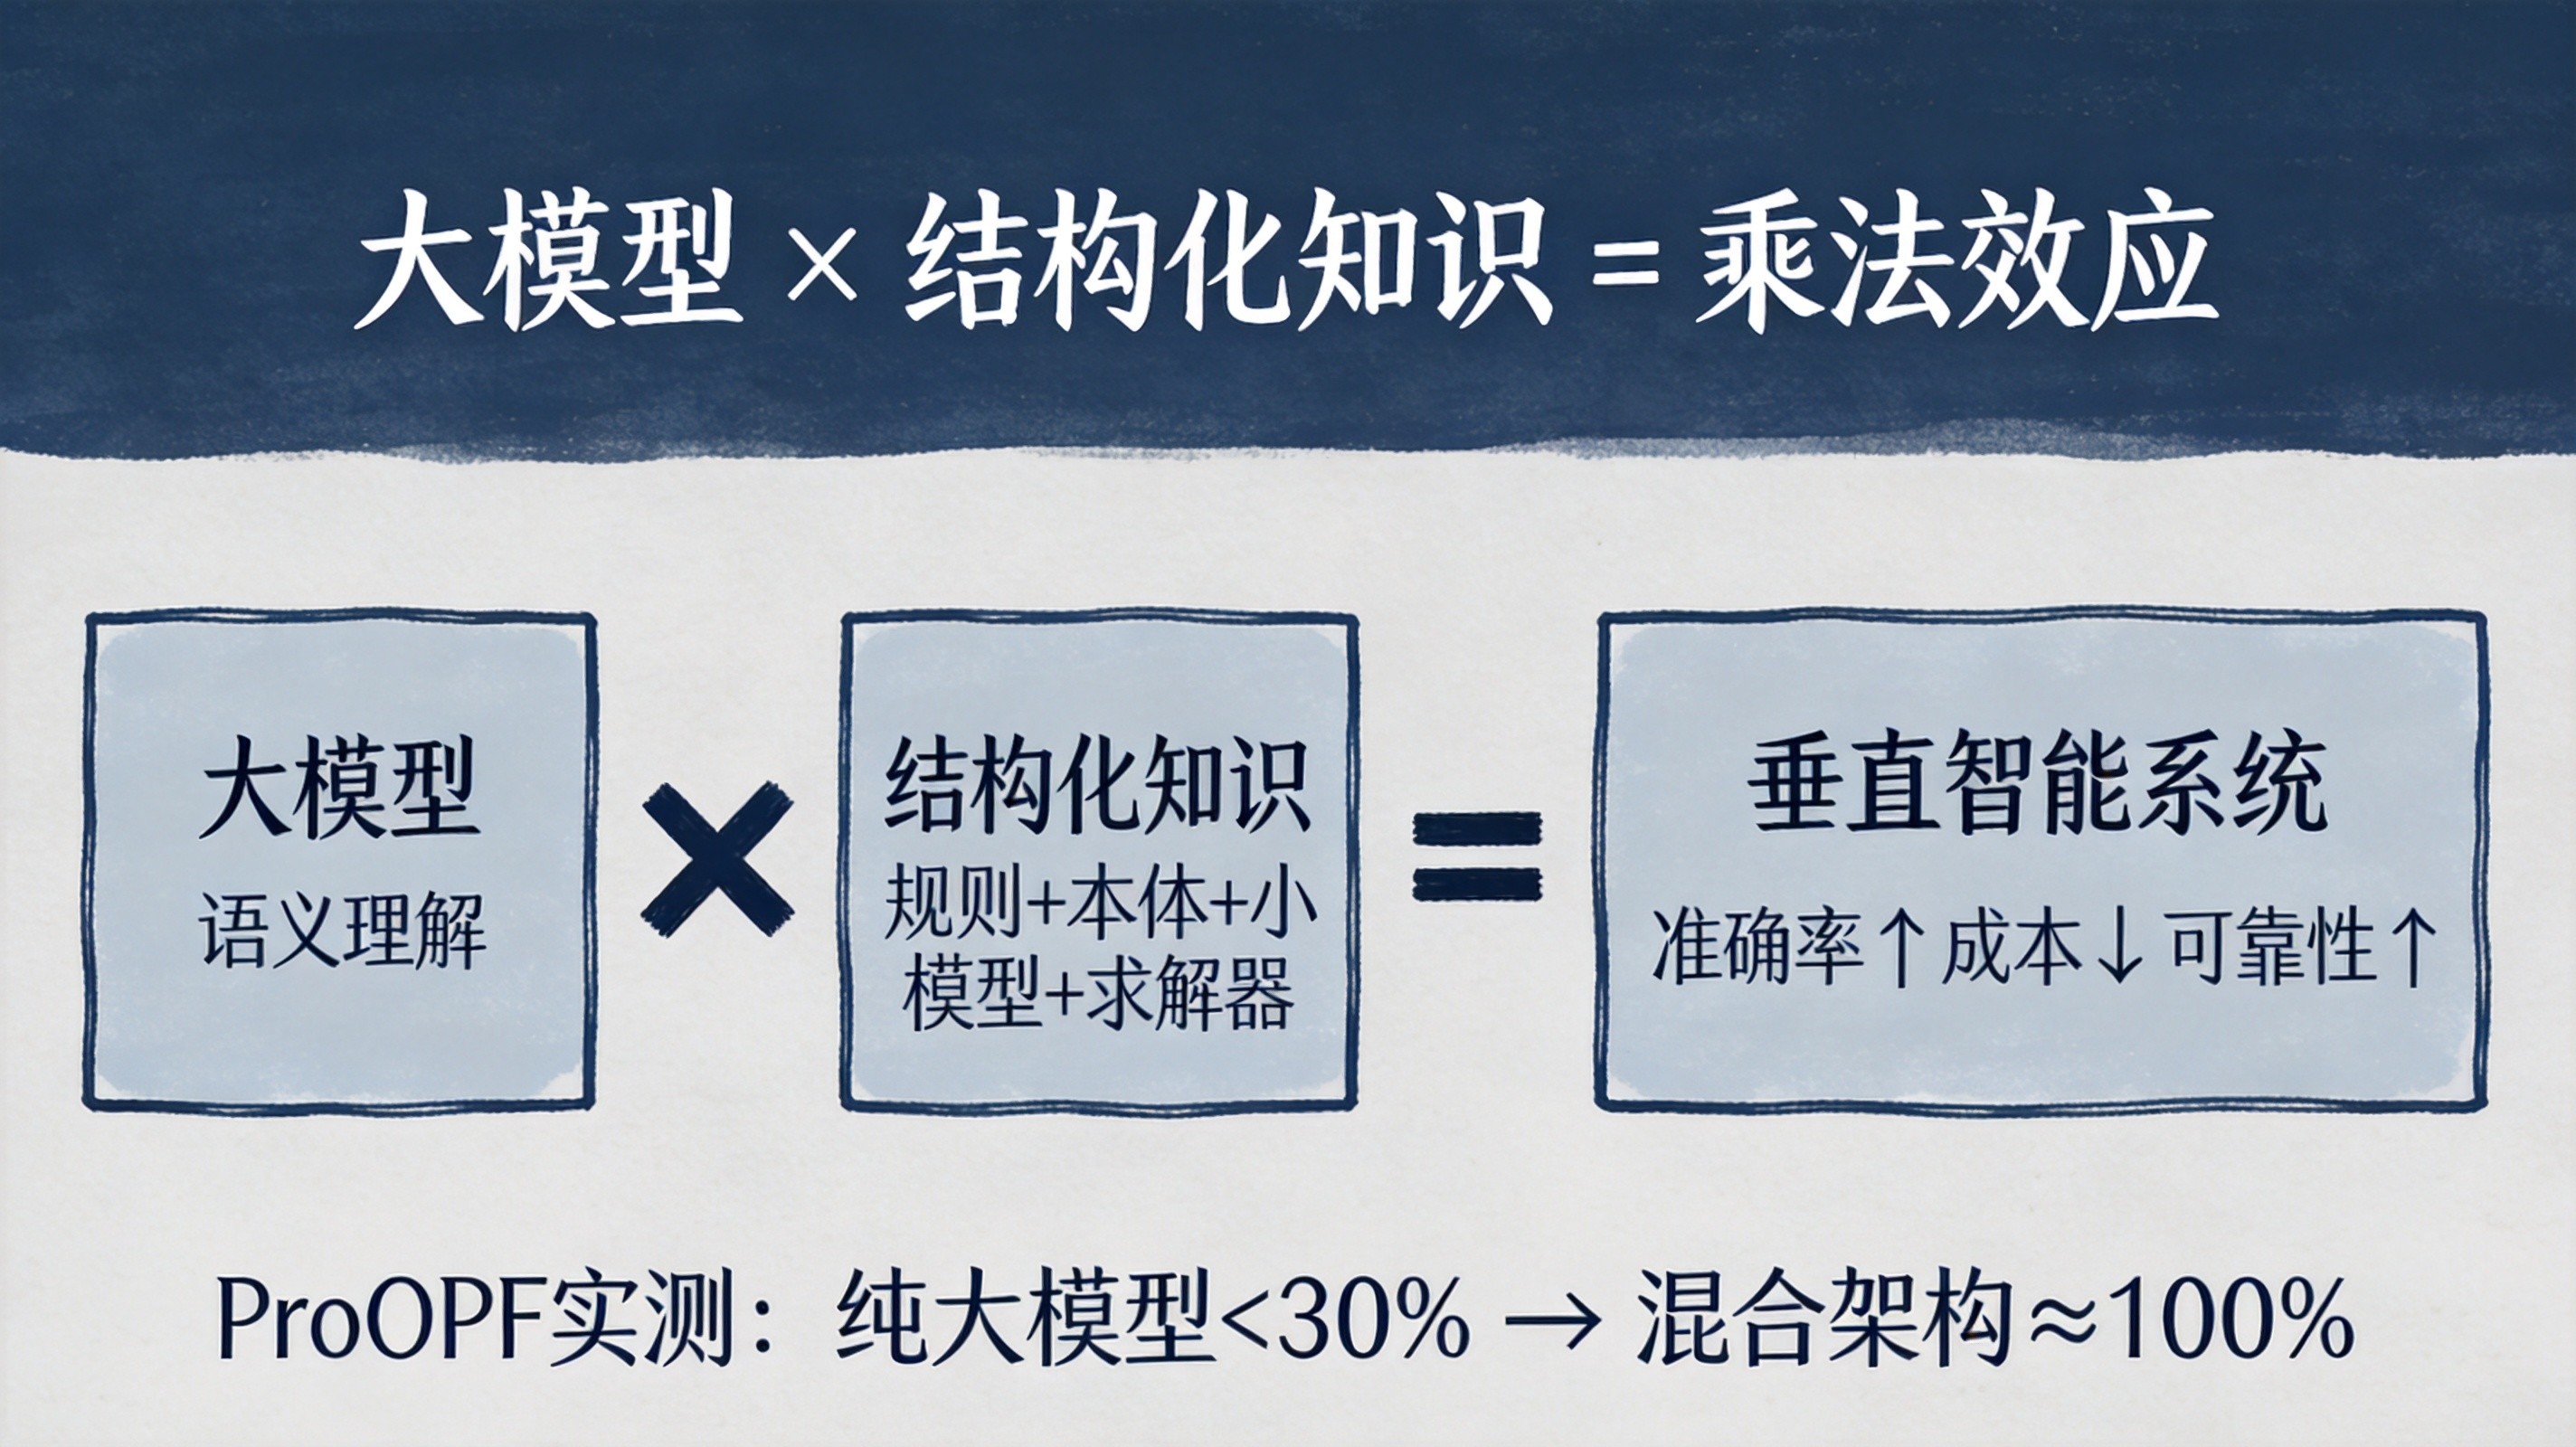
我们做电力调度优化的时候测过,纯大模型方案在ProOPF任务上的准确率不到30%。不是模型不行,是电力优化这个问题本质上就是精确计算问题,大模型擅长的是语义理解,不是数值推理。你把参数调得再高、prompt写得再长,天花板就在那。
后来换成"大模型+小模型"的架构,大模型做语义理解和问题拆解,小模型做精确计算和约束求解,准确率直接拉满,性能从分钟级降到秒级。
这就是生产级的第一个核心认知:大模型是语义引擎,不是万能引擎。 垂直领域的生产级Agent,必须有结构化知识层做乘法本体、知识库、规则引擎、专用求解器。大模型负责理解和组织,结构化知识负责精确和可靠。两者是乘法关系,不是加法关系。少了任何一个,效果都上不去。
二、生产级不是"功能全",而是"不出事"
POC阶段你关心的是"能不能实现这个功能"。生产级你最关心的变成了"出了问题怎么办"。
万级用户的场景下,任何一个小问题乘以一万,都是大问题。大模型幻觉率哪怕只有1%,每天一万次调用就是一百次幻觉。这一百次幻觉里只要有一次涉及关键业务决策,后果就可能很严重。
生产级Agent的架构设计,80%的精力都花在"不出事"上。
- 双轨运行:AI做的所有关键决策,必须有人类兜底通道。不是"AI替人做",而是"AI辅助人做"。人是最终责任人,AI是加速器。这听起来很保守,但在生产环境里,保守就是可靠。
- 确定层和不确定层分离:把系统里确定不变的部分数据源、规则逻辑、处置流程跟可能变化的部分调度方式、计算路径、部署形态分开。确定层一次做对,不确定层保持灵活。出了问题,你知道问题一定出在不确定层,排查范围大大缩小。
- 熔断回滚机制:任何关键操作都要有熔断阈值。AI输出的置信度低于多少、连续失败多少次、用户投诉率超过多少,触发自动降级或回滚。不能等出了大事再人工介入,那时候已经晚了。
- 全链路留痕:每一次AI决策都要有完整的审计日志输入是什么、调用了哪些工具、中间结果是什么、最终输出是什么、用户反馈如何。出了问题能回溯,有了成绩能归因。
很多团队觉得这些都是"运维的事",等功能做好了再说。不对。这些东西必须从第一天就设计进架构里。你后面再加,成本是从一开始就做的五倍以上,而且大概率加不上因为架构没有预留接口。
三、成本结构完全不同,POC的成本乘以100都不止
POC阶段你可能不在乎成本每天几十次调用,花不了几个钱。但生产级是另一回事。万级用户、每天几万次调用,纯大模型方案的成本会高到离谱。
我见过最夸张的一个例子,一个团队做POC的时候效果很好,算下来每个月API成本大概几百块。上线一个月后账单出来,六万多。原因很简单:POC是测试人员用,每天几十次;上线后是真实用户用,每天几千次,而且用户的使用方式比测试人员复杂得多,调用链长得多。
生产级Agent必须从第一天就考虑成本结构。几个关键经验如下。
能不用大模型的地方就不用。 很多任务其实用规则引擎、关键词匹配、小模型分类就能解决,而且更快更准更便宜。大模型只用来做它真正擅长的事语义理解、复杂推理、开放性问题。其他的全部下沉到结构化知识层或专用引擎。
缓存是你的好朋友。 很多用户问的问题其实是重复的。把常见问题和对应的答案缓存起来,下次直接返回,不用每次都跑大模型。做得好的话,缓存命中率能到30%到50%,成本直接砍一半。
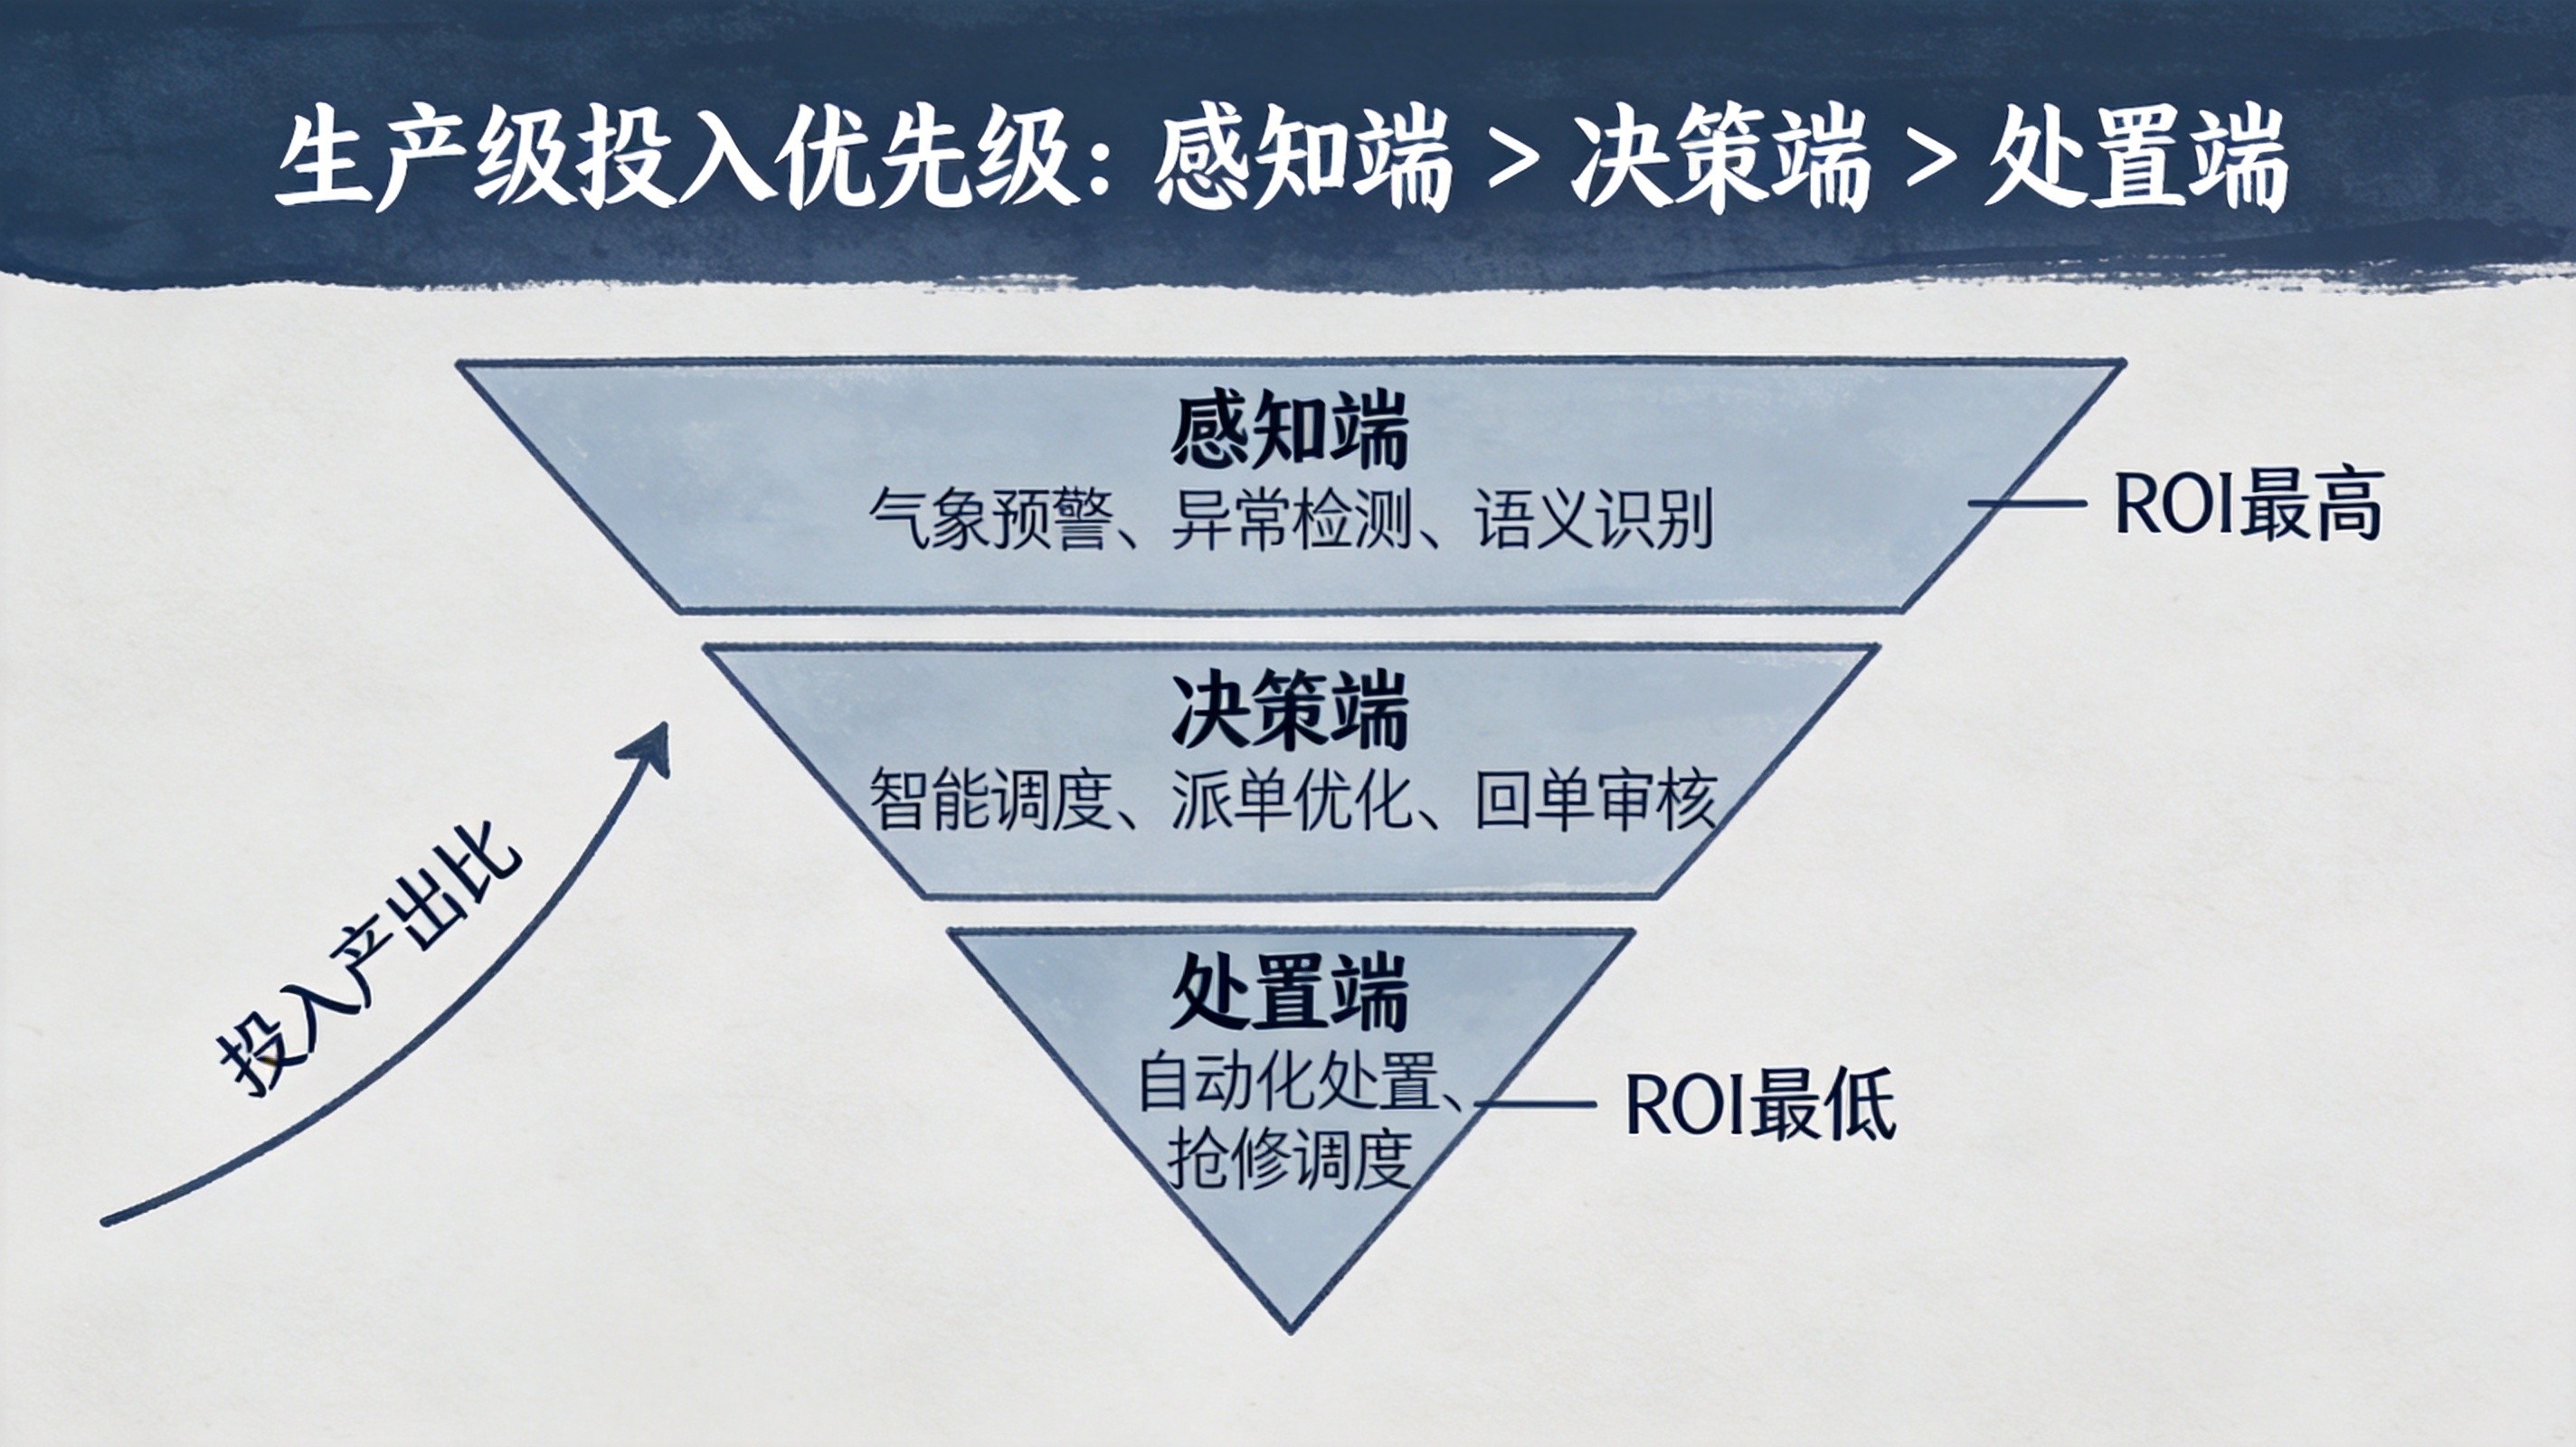
感知端投入的ROI远高于处置端。 这是我们做供电服务AI的一个反直觉发现在前置感知渠道投入1块钱,比在后置处置渠道投入10块钱的效果还好。因为问题发现得越早,处置成本越低。生产级Agent的投资顺序应该是:感知端 > 决策端 > 处置端,而不是反过来。
四、万级用户的Agent,不是一个Agent,是一个Agent系统
POC阶段你做的是一个Agent一个任务、一套prompt、几个工具。但生产级万级用户场景下,你面对的不是一个Agent,而是成百上千个Agent不同用户、不同场景、不同权限、不同数据范围。
这时候核心问题就变了。不再是"怎么让一个Agent变聪明",而是"怎么管理一堆Agent,让它们不打架、不越权、可复用、可审计"。
几个关键设计如下。
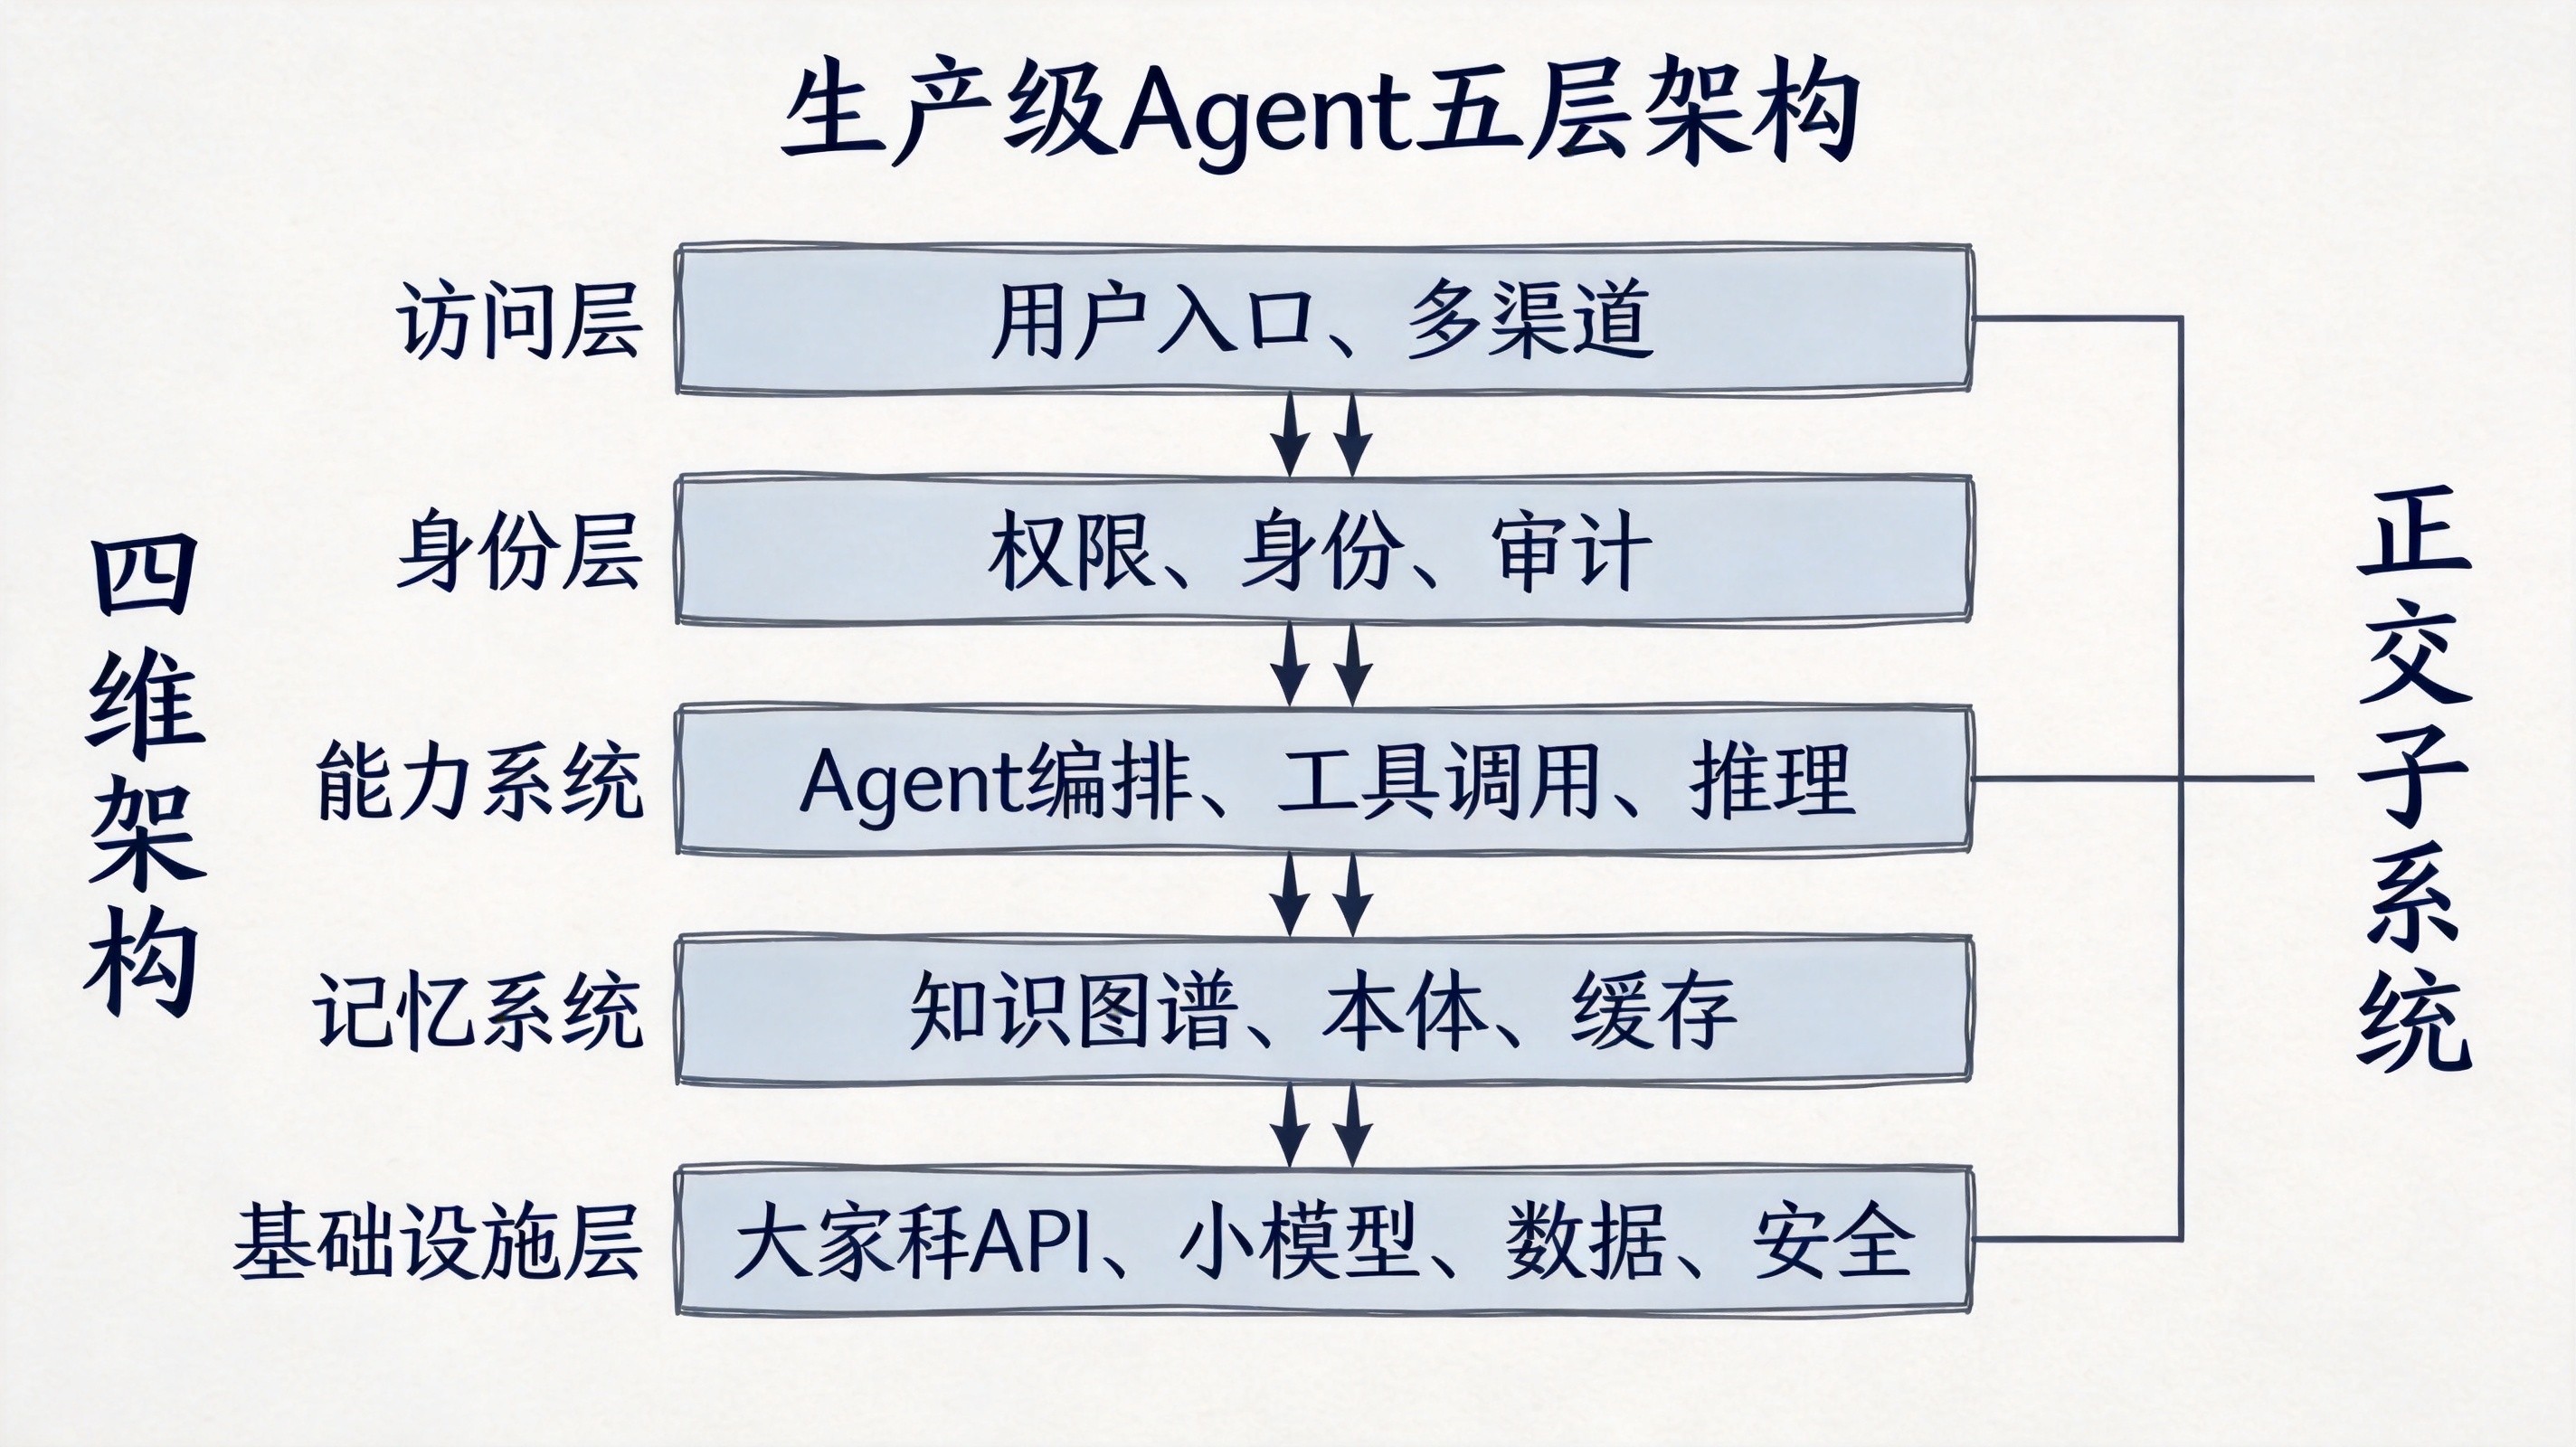
四维架构。 生产级Agent系统不是一个大模型加一堆工具,而是四个正交的子系统——身份层(谁在用、什么权限)、能力系统(能做什么、调用哪些工具)、记忆系统(知道什么、记住什么)、访问系统(怎么接入、从哪里调用)。四个层分开设计,各自演进,比混在一起的"超级Agent"靠谱得多。
权限是独立的一维。 很多团队做Agent的时候,权限是后加的Agent已经写完了,再接一套权限系统。这是错的。权限必须是架构的第一维。万级用户的场景下,不同人能看到的数据、能操作的功能天差地别。如果权限不是从底层设计进去的,后面一定会出越权问题不是数据泄露,就是AI"创造"出未授权的权限。
规则隔离比通信协议更重要。 多Agent系统,大家首先想到的是"Agent之间怎么通信"。但真正决定系统稳定性的,不是通信效率,而是规则隔离每个Agent有自己的职责边界、数据范围、操作权限。越界了就拦下来,不管它说得多有道理。没有隔离的多Agent系统,规模越大越混乱,最后变成一锅粥。
五、从POC到生产,最难过的关不是技术,是组织
最后说点实在的。很多项目死在生产化的路上,不是技术不行,是组织跟不上。
POC阶段几个人的小团队,说干就干,快速迭代。一到生产级,事情就全变了要跟数据部门谈数据接入、跟安全部门谈等保合规、跟运维部门谈部署规范、跟业务部门谈需求边界、跟法务谈责任认定。每一个部门都是一道关。
这也是为什么"双轨运行"这么重要。你不能一上来就说"我要替代谁谁谁的工作",那是在给自己找敌人。你要说"我来帮你做那些重复的、麻烦的事,决策还是你拍板"。先做助手,再做伙伴,最后才谈得上替代部分工作。这个顺序不能乱。
组织层面还有一个经常被忽视的点:谁是DRI(直接责任人)。生产级Agent出了问题,不能说"是AI干的",必须有明确的人来负责任。这个人不是技术负责人,是业务负责人因为AI做的是业务决策,后果由业务承担。技术团队提供工具,业务团队承担责任,这个权责关系必须理清楚,否则出一次事项目就黄了。
总结一下。生产级AI Agent,不是POC的放大版,是完全不同的物种。它的核心不是大模型有多聪明,而是架构有多稳、成本有多低、安全有多可靠、组织有多对齐。
纯大模型方案,在Demo里好看,在生产里活不下去。真正的生产级Agent,是"大模型做语义引擎 + 结构化知识做精确底座 + 双轨运行做安全护栏 + 四维架构做系统骨架 + 明确的DRI做组织保障"。少了任何一环,跑不长久。
更多传统行业生产级AI落地的实战经验,在我的公众号 & 知识星球 [SG AI实验室],专注一线项目的一手记录。